인지야공/딥러닝 기초 정리/60번째 글
GAN — 속이는 쪽과 가려내는 쪽
실행:
python NN_64_gan.py(검증 환경: torch 2.8.0+cu129, RTX 5080, 18분) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
VAE 편은 “압축했다가 복원한다”는 과제로 생성 모델을 만들었다. GAN(적대적 생성 신경망)은 전혀 다른 길을 간다. “이 표본이 얼마나 그럴듯한가”를 사람이 식으로 적지 않는다. 그것을 재는 신경망을 하나 더 두고 둘을 겨루게 한다.
이 편은 질문 셋을 잰다.
- 가려내는 쪽은 이론이 말하는 값으로 정말 가는가
- 속이는 쪽은 데이터의 모든 봉우리를 만들게 되는가
- 두 신경망이 번갈아 움직일 때 학습은 한곳에 멈추는가
1. 두 신경망의 게임
위조지폐범과 감별사에 비유한다.
- 생성기 (위조지폐범): 무작위 숫자 를 받아 가짜 표본 를 만든다. 진짜 데이터는 한 번도 보지 못한다.
- 판별기 (감별사): 표본 를 받아 그것이 진짜일 확률 를 낸다.
둘은 같은 식을 놓고 반대로 움직인다.
| 기호 | 뜻 |
|---|---|
| 생성기에 넣는 무작위 숫자 (표준정규분포에서 뽑는다) | |
| 생성기가 만든 가짜 표본 | |
| 판별기가 본 ” 가 진짜일 확률” (0~1) | |
| 진짜 데이터의 분포 | |
| 생성기가 만드는 표본의 분포 | |
| 평균 |
- 판별기는 를 키운다. 진짜에는 , 가짜에는 이면 두 항이 모두 커진다.
- 생성기는 를 줄인다. 건드릴 수 있는 것은 둘째 항뿐이고, 이 되게 한다.
판별기가 가는 곳
생성기를 고정하고 판별기만 끝까지 학습하면, 판별기는 점 마다 다음 값으로 간다.
그 자리에 진짜가 얼마나 있고 가짜가 얼마나 있는지의 비율이다. 숫자로 따라가 본다.
| 그 자리의 상황 | |||
|---|---|---|---|
| 진짜만 있고 가짜는 없다 | 1/8 | 0 | 1 |
| 진짜와 가짜가 같은 양 | 1/8 | 1/8 | 1/2 |
| 가짜가 진짜의 두 배 | 1/8 | 1/4 | 1/3 |
생성기가 데이터를 완벽하게 흉내 내면 모든 자리에서 이 된다. 판별기는 동전을 던지는 수밖에 없다. 이것이 이 게임의 평형이다.
생성기의 손실을 바꾸는 이유
원래 식대로면 생성기는 를 줄인다. 실전에서는 대신 를 줄인다(비포화 손실). 목표는 같고 기울기의 크기가 다르다. 판별기의 출력을 확률로 바꾸기 전의 값(로짓)으로 미분하면 다음과 같다.
| 생성기의 손실 | 기울기의 크기 | 일 때 | 일 때 |
|---|---|---|---|
| 원래 식 (포화) | 0.01 | 0.5 | |
| 비포화 | 0.99 | 0.5 |
판별기가 가짜를 쉽게 가려내는 초반()에 원래 식은 기울기가 거의 사라진다. 가장 많이 배워야 할 때 신호가 가장 약하다.
모드 붕괴
생성기의 목표는 “판별기를 속이는 것”이지 “데이터 전체를 덮는 것”이 아니다. 데이터에 봉우리가 여덟 개 있어도, 그중 하나만 아주 잘 만들면 판별기는 그 표본을 진짜라고 한다. 이렇게 일부만 만들게 되는 것이 모드 붕괴다. 판별기가 그 봉우리를 의심하기 시작하면 생성기는 다른 봉우리로 옮겨 간다. 그래서 봉우리를 옮겨 다니기만 하고 전부를 덮지 못하는 일도 생긴다.
2. 직접 재 보기
데이터는 2차원 평면의 점이다. 반지름 2 인 원 위에 가우시안 봉우리 8개를 같은 간격으로 놓았다(표준편차 0.05). 생성기와 판별기는 은닉층 2개(각 128)짜리 완전연결망이고, Adam 학습률 , 배치 256, 생성기 기준 6,000스텝이다.
재는 것은 둘이다. 생성기가 만든 점 10,000개를 가장 가까운 봉우리에 배정한다.
- 좋은 표본의 비율(품질): 봉우리 중심에서 표준편차의 3배 안에 떨어진 점의 비율. 진짜 데이터라면 98.9% 다(, 계산값).
- 만든 봉우리 수(다양성): 좋은 표본이 전체의 2% 이상 떨어진 봉우리의 수. 고르게 만들면 봉우리마다 12.5% 다.
[A] 판별기는 이론값으로 가는가
생성기를 신경망이 아니라 “봉우리 8개 중 짝수 번째 4개만 만드는 분포” 로 고정하고 판별기만 4,000스텝 학습했다. 생성기가 만드는 봉우리에서는 가짜가 진짜의 두 배이므로 , 빠뜨린 봉우리에서는 이어야 한다.
| 봉우리 | 생성기가 | 판별기의 평균 출력 | 이론값 |
|---|---|---|---|
| 0, 2, 4, 6 | 만든다 | 0.336, 0.352, 0.341, 0.338 | 0.333 |
| 1, 3, 5, 7 | 빠뜨렸다 | 1.000, 1.000, 1.000, 1.000 | 1.000 |
판별기의 손실은 0.9513 이었고, 위의 를 넣어 계산한 이론값은 0.9548 이다. 두 분포가 완전히 같을 때의 값은 이다.
- 판별기는 식이 말하는 곳으로 갔다. 오차는 0.02 안이다.
- 빠진 봉우리에서 이라는 것은 생성기에게 “거기에 진짜가 있다”는 신호다. 다만 생성기는 자기가 만든 점에서만 기울기를 받는다. 한 번도 점을 찍지 않은 자리의 값은 생성기에게 직접 전해지지 않는다. 모드 붕괴가 저절로 풀리지 않는 이유다.
[B] 8개 봉우리를 다 만드는가
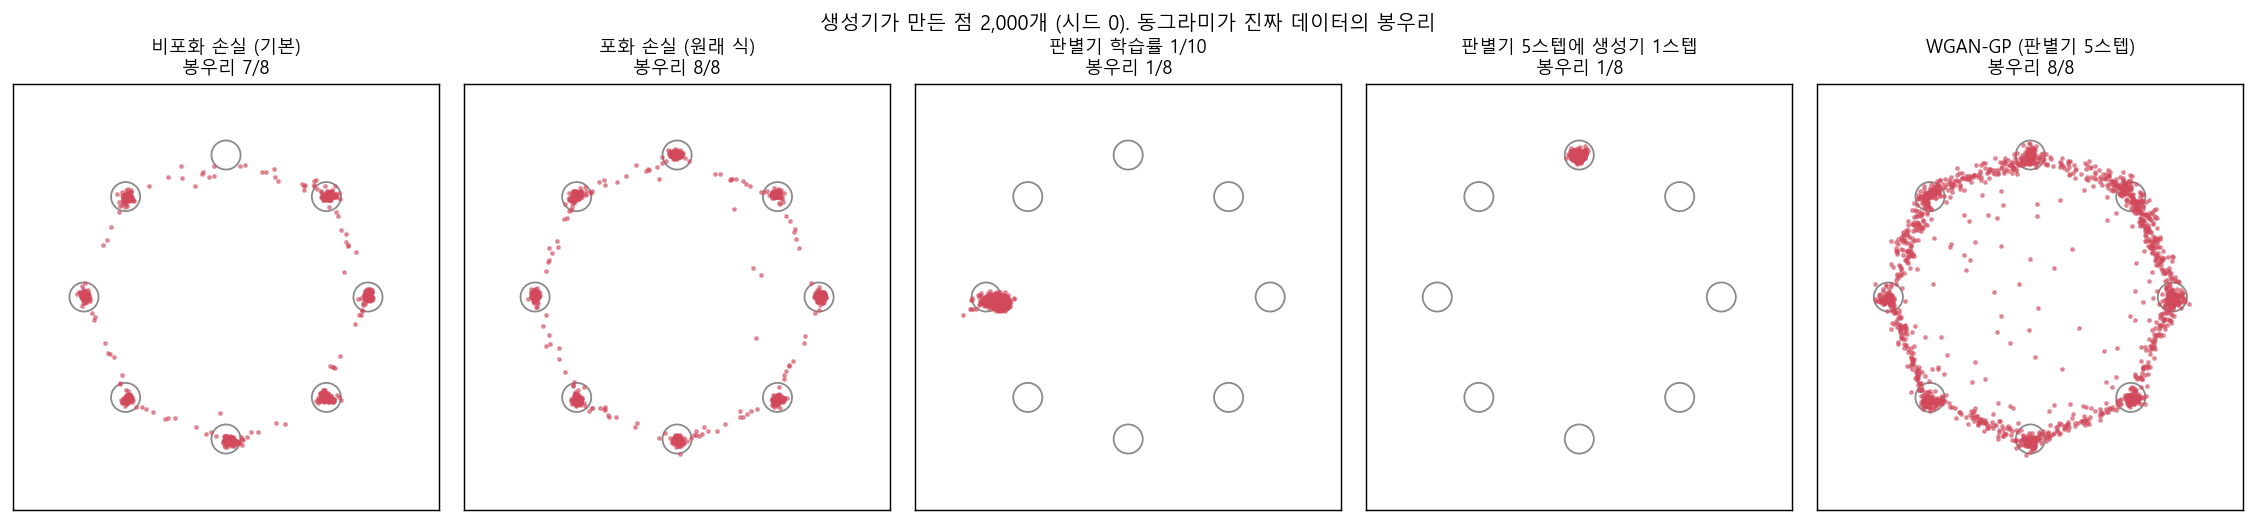
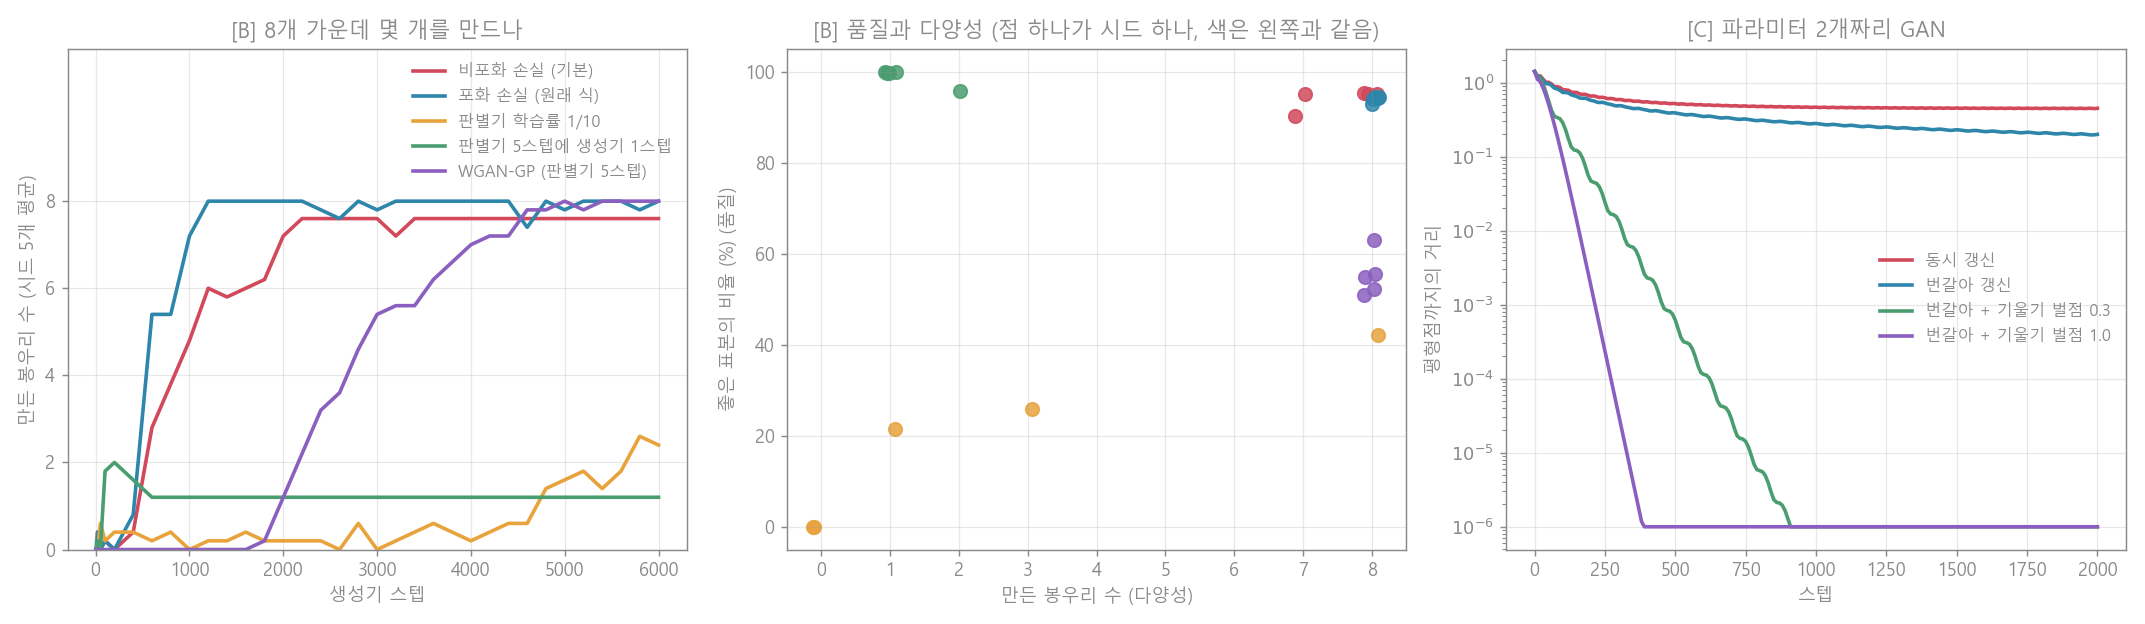
다섯 가지 설정을 시드 5개씩 학습했다.
| 설정 | 끝의 봉우리 수 (시드 5개) | 평균 | 좋은 표본 (범위) |
|---|---|---|---|
| 비포화 손실 (기본) | 7, 8, 7, 8, 8 | 7.6 | 94.2% (90.3~95.3) |
| 포화 손실 (원래 식) | 8, 8, 8, 8, 8 | 8.0 | 93.9% (92.8~94.3) |
| 판별기 학습률 1/10 | 1, 0, 8, 0, 3 | 2.4 | 17.9% (0.0~42.2) |
| 판별기 5스텝에 생성기 1스텝 | 1, 1, 2, 1, 1 | 1.2 | 98.9% (95.6~99.9) |
| WGAN-GP (판별기 5스텝) | 8, 8, 8, 8, 8 | 8.0 | 55.3% (50.9~63.0) |
- 기본 설정은 잘 됐다. 8개 중 평균 7.6개를 만들었고 표본의 94.2% 가 봉우리 안에 떨어졌다. 봉우리 사이를 잇는 가는 선이 남는데, 생성기가 연속 함수라 한 봉우리에서 다른 봉우리로 넘어가는 가 반드시 있기 때문이다.
- 판별기를 5배 자주 학습시키자 봉우리 하나로 무너졌다(평균 1.2개). 그런데 품질은 가장 높다. 표본의 98.9% 가 봉우리 안이고, 이것은 진짜 데이터의 값과 같다. 품질만 재면 이 모델이 가장 좋아 보인다. 표본 한 장 한 장은 완벽한데 여덟 가지 중 한 가지만 만든다.
- 판별기를 느리게 하면 품질과 다양성이 함께 무너졌다(2.4개, 17.9%). 시드 다섯 가운데 둘은 봉우리를 하나도 못 만들었다. 학습 후반에 “가장 많이 만드는 봉우리”가 15번의 관찰 사이에 8~14번 바뀌었다. 판별기가 따라오기 전에 생성기가 자리를 옮기는, 옮겨 다니기다.
- WGAN-GP 는 반대쪽의 거래다. 다섯 시드 모두 8개를 덮었지만 좋은 표본은 55.3% 다. 그림에서 보듯 봉우리가 아니라 원 전체에 번져 있다. 덮기는 다 덮었는데 흐리다.
예상과 달랐던 것 둘.
첫째, 포화 손실이 실패할 것이라고 예상했다. 실패하지 않았고 오히려 다섯 시드 모두 8개를 만들었다. 초반의 를 보면 이유가 보인다(시드 0).
| 생성기 스텝 | 1 | 5 | 10 | 20 | 50 | 100 |
|---|---|---|---|---|---|---|
| , 포화 손실 | 0.519 | 0.507 | 0.412 | 0.556 | 0.242 | 0.266 |
| , 비포화 손실 | 0.519 | 0.507 | 0.411 | 0.561 | 0.375 | 0.230 |
가 0.2 아래로 내려간 적이 없다. 포화 손실이 무너지는 조건은 판별기가 가짜를 거의 완벽히 가려내는 것인데, 판별기와 생성기를 한 스텝씩 번갈아 학습한 이 작은 문제에서는 그 상황이 오지 않았다. “포화 손실은 기울기가 사라진다”는 판별기가 크게 앞설 때의 이야기이고, 이 실험은 그 조건을 만들지 못했다.
둘째, 판별기를 더 많이 학습시키면 생성기가 더 정확한 신호를 받아 좋아질 것이라고 예상했다. 결과는 가장 심한 모드 붕괴였다. [A] 에서 본 것처럼 정확한 판별기도 생성기가 점을 찍지 않은 자리에 대해서는 알려 주지 못한다. 판별기가 강할수록 생성기는 이미 통하는 한 곳을 더 정확히 맞추는 쪽으로 갔다.
[C] 가장 작은 GAN 은 왜 멈추지 않는가
신경망을 다 걷어 내고 파라미터 두 개만 남긴다(Mescheder 외, 2018 의 설정).
- 진짜 데이터는 숫자 0 하나다.
- 생성기는 숫자 하나를 낸다.
- 판별기는 로 점수를 매긴다.
평형은 (생성기가 진짜와 같은 값을 냄), (판별기가 구분을 포기함)이다. 에서 출발해 학습률 0.1 로 평형까지의 거리를 쟀다.
| 갱신 방법 | 시작 | 100스텝 | 500스텝 | 1,000스텝 | 2,000스텝 | 의 부호가 바뀐 횟수 |
|---|---|---|---|---|---|---|
| 동시 갱신 | 1.414 | 0.804 | 0.521 | 0.467 | 0.451 | 32 |
| 번갈아 갱신 | 1.414 | 0.737 | 0.390 | 0.281 | 0.200 | 32 |
| 번갈아 + 기울기 벌점 0.3 | 1.414 | 0.288 | 0.001 | 0.000 | 0.000 | 30 |
| 번갈아 + 기울기 벌점 1.0 | 1.414 | 0.094 | 0.000 | 0.000 | 0.000 | 0 |
- 벌점이 없으면 평형에 닿지 못한다. 동시 갱신은 2,000스텝 뒤에도 0.451 만큼 떨어져 있고, 1,000스텝과 2,000스텝 사이에 0.016 밖에 줄지 않았다. 그동안 는 평형점을 32번 가로질렀다. 평형으로 내려가는 것이 아니라 그 둘레를 돈다.
- 왜 도는가. 생성기가 를 0 쪽으로 옮기면 판별기의 가 뒤따라 부호를 바꾸고, 그 가 다시 를 반대쪽으로 민다. 서로의 뒤를 쫓는 꼴이다. 손실 하나를 줄이는 보통의 학습에서는 내리막의 끝이 있지만, 두 선수가 서로 반대로 움직이는 게임에서는 내리막이 원이 될 수 있다.
- 번갈아 갱신이 조금 낫다(0.200). 상대의 최신 값을 보고 움직이는 것만으로 차이가 난다. 그래도 닿지 못했다.
- 기울기 벌점이 원을 나선으로 바꾼다. 판별기의 기울기가 커지지 못하게 벌점을 주자 500스텝 안에 평형에 닿았다. 벌점 0.3 은 30번 가로지르며 감겨 들어갔고, 1.0 은 한 번도 가로지르지 않고 곧장 들어갔다.
여기서도 예상 하나가 빗나갔다. 이 설정의 동시 갱신은 발산한다고 알려져 있어 거리가 늘어날 것이라 예상했는데, 처음에는 줄다가 0.45 근처에서 멈췄다. 비포화 손실에서는 가 0 이 아닌 동안 평형 쪽으로 당기는 힘이 조금 있고, 그 힘이 평형에 가까워질수록 급격히 약해져서다. 발산하지는 않았지만 수렴도 하지 않았다.
3. 흔한 오해와 한계
“손실이 줄면 학습이 잘 되고 있는 것이다.” GAN 에서는 아니다. 판별기의 손실이 줄면 생성기가 지고 있다는 뜻이고, 늘면 판별기가 지고 있다는 뜻이다. 평형에서 손실은 에 머문다. 손실 곡선으로는 품질도 다양성도 읽을 수 없다.
“표본이 진짜 같으면 좋은 생성 모델이다.” 품질이 가장 높았던 모델(98.9%)이 봉우리를 하나만 만들었다. 품질과 다양성은 따로 재야 한다.
“판별기는 강할수록 좋다.” 판별기를 5배 자주 학습시킨 쪽이 가장 심하게 무너졌다. 느리게 한 쪽도 무너졌다. 필요한 것은 강함이 아니라 균형이었다.
“포화 손실은 쓰면 안 된다.” 이 실험에서는 비포화보다 못하지 않았다. 판별기가 크게 앞서는 상황에서 문제가 되는 것이고, 그 상황은 문제와 설정에 따라 온다.
실험의 한계. 2차원 점 데이터와 작은 완전연결망이다. 이미지처럼 차원이 높은 데이터에서는 진짜와 가짜의 분포가 거의 겹치지 않아, 판별기가 훨씬 쉽게 앞서고 포화 손실의 문제도 더 쉽게 나타난다. 설정마다 학습률과 스텝 비율을 하나씩만 시험했다. WGAN-GP 의 흐린 결과는 6,000스텝과 벌점 계수 1.0 이라는 한 설정의 값이고, 더 오래 학습하면 달라질 수 있다. 실제로 봉우리 수 곡선은 끝까지 오르는 중이었다. “만든 봉우리 수”는 2% 라는 문턱에 달려 있다. GAN 이 이미지 생성의 주류에서 물러난 뒤의 방법은 뒤의 확산 모델 편에서 다룬다.
4. 한 문단 요약
GAN 은 가짜를 만드는 생성기와 진짜를 가려내는 판별기를 겨루게 해서 생성 모델을 학습한다. 생성기를 고정하면 판별기는 그 자리의 진짜와 가짜의 비율 로 간다. 실험에서 이론값 0.333 인 자리에 0.336~0.352, 1 인 자리에 1.000 이 나왔다. 어려운 것은 둘을 함께 학습할 때다. 봉우리 8개짜리 데이터에서 기본 설정은 7.6개를 만들었지만, 판별기를 5배 자주 학습시키면 1.2개로 무너지면서 표본의 품질은 98.9% 로 가장 높았다. 판별기를 느리게 하면 2.4개에 품질 17.9% 였고, WGAN-GP 는 8개를 다 덮었지만 품질이 55.3% 였다. 파라미터 2개짜리 GAN 은 평형점 둘레를 돌며 2,000스텝 뒤에도 0.451 만큼 떨어져 있었고, 판별기에 기울기 벌점을 주자 500스텝 안에 평형에 닿았다. GAN 의 학습은 내리막을 내려가는 일이 아니라 두 선수의 균형을 맞추는 일이고, 품질과 다양성은 따로 재야 한다.
참고
- Goodfellow 외 — Generative Adversarial Nets (2014)
- Arjovsky, Chintala, Bottou — Wasserstein GAN (2017)
- Gulrajani 외 — Improved Training of Wasserstein GANs (2017) (WGAN-GP)
- Mescheder, Geiger, Nowozin — Which Training Methods for GANs do actually Converge? (2018) (파라미터 2개짜리 GAN, 기울기 벌점)
- Metz 외 — Unrolled Generative Adversarial Networks (2017) (봉우리 8개 실험의 원형)
- 연재: VAE 편 · 소프트맥스와 교차 엔트로피 편