인지야공/오늘의 AI 이슈/14번째 글
메모리를 절반으로 — 용량이 아니라 대역폭이라는 말의 산수
실행:
python 딥러닝/daily/DAILY_2026_10_03_memory_bandwidth.py(RTX 5080 16GB, 1분 안) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. AI5 칩은 손에 없어서, 같은 원리를 이 PC 의 GPU 로 쟀다. AI5 의 메모리 대역폭은 공개되지 않았다.
1. 무슨 일이 있었나
10월 1일, 일론 머스크가 Tesla 의 차세대 AI 칩 두 종의 메모리를 줄였다고 밝혔다 (Teslanorth, Wccftech, Yahoo Finance).
“We cut our RAM in half for the Tesla AI5 chip (now 72GB of LP5) and 1/3 for AI6 (now 144GB of LP6).”
| 칩 | 전 | 후 | 메모리 종류 |
|---|---|---|---|
| AI5 | 144 GB | 72 GB | LPDDR5 |
| AI6 | 216 GB | 144 GB | LPDDR6 |
머스크가 든 이유는 휴머노이드 로봇 Optimus 를 대량 생산할 만큼 메모리 물량을 확보하고 원가를 크게 낮추는 것이었다. 성능 영향은 “무시할 만하다(negligible)“고 했다. 여러 매체가 그 근거를 용량이 아니라 대역폭이 병목이라는 설명으로 전했다. Teslanorth 는 대역폭은 그대로라고 전했지만, 다른 매체에서는 이를 확인하지 못했다. 같은 기사들에는 Micron 이 휴머노이드 한 대에 DRAM 이 200GB 쯤 필요하다고 본다는 전망도 실렸다.
“용량을 절반으로 줄였는데 성능이 그대로”는 직관에 어긋난다. 이 글은 그 말이 언제 참이고 언제 거짓인지를 셈한다.
2. 핵심 개념 — 창고의 크기와 문의 폭
비유
메모리는 창고, 연산 장치는 공장이다. 창고에서 공장으로 가는 길에는 문이 하나 있다.
- 용량은 창고의 크기다. 물건을 얼마나 쌓아 둘 수 있나.
- 대역폭은 문의 폭이다. 1초에 물건을 얼마나 꺼낼 수 있나.
언어 모델이 토큰 하나를 만들 때는 모든 가중치를 창고에서 한 번씩 꺼내야 한다. 꺼낸 가중치 하나로 곱셈 한 번(곱하고 더하기 2연산)만 하고 버린다. 공장은 놀고 문 앞에 줄이 선다. 그래서 토큰 하나를 만드는 시간은 대략 이렇다.
| 기호 | 뜻 |
|---|---|
| 한 번에 읽어야 하는 바이트. 가중치만이면 파라미터 수 × (비트 수 / 8) | |
| 메모리 대역폭 (바이트/초) | |
| 배치 1로 토큰 하나(또는 판단 한 번)를 만드는 시간 | |
| 판단 주기. 로봇이 1초에 몇 번 판단하나 (Hz) | |
| 주기 를 지키면서 매 주기 읽을 수 있는 최대 바이트 |
둘째 식이 이 이슈의 핵심이다. 대역폭이 정해지면, 주기마다 쓸 수 있는 모델 크기에 천장이 생긴다. 창고가 그 천장보다 크면, 남는 칸은 매 주기 쓰지 못한다.
그러면 배치를 키우면?
가중치를 한 번 꺼내 여러 입력에 동시에 쓰면 문 앞 줄이 짧아진다. 배치 로 돌리면 바이트 하나당 연산이 배가 된다. 연산이 공장의 최대 속도에 닿을 때까지는 시간이 거의 늘지 않는다. 그 경계가 산술 강도와 메모리 대역폭 노트의 루프라인 무릎이다.
| 기호 | 뜻 |
|---|---|
| 산술 강도 | 읽은 바이트 하나당 연산 수. bf16 행렬×행렬에서 배치 면 약 FLOP/바이트 |
| 무릎 | 최고 연산 속도 ÷ 대역폭. 산술 강도가 이보다 낮으면 메모리에, 높으면 연산에 묶인다 |
다만 로봇 한 대는 자기 눈에 들어온 장면 하나를 판단한다. 데이터센터처럼 수백 명의 요청을 묶어 배치를 키우기 어렵다. 로봇의 추론이 배치 1에 가깝다면 대역폭이 더 결정적이다.
3. 직접 재 보기
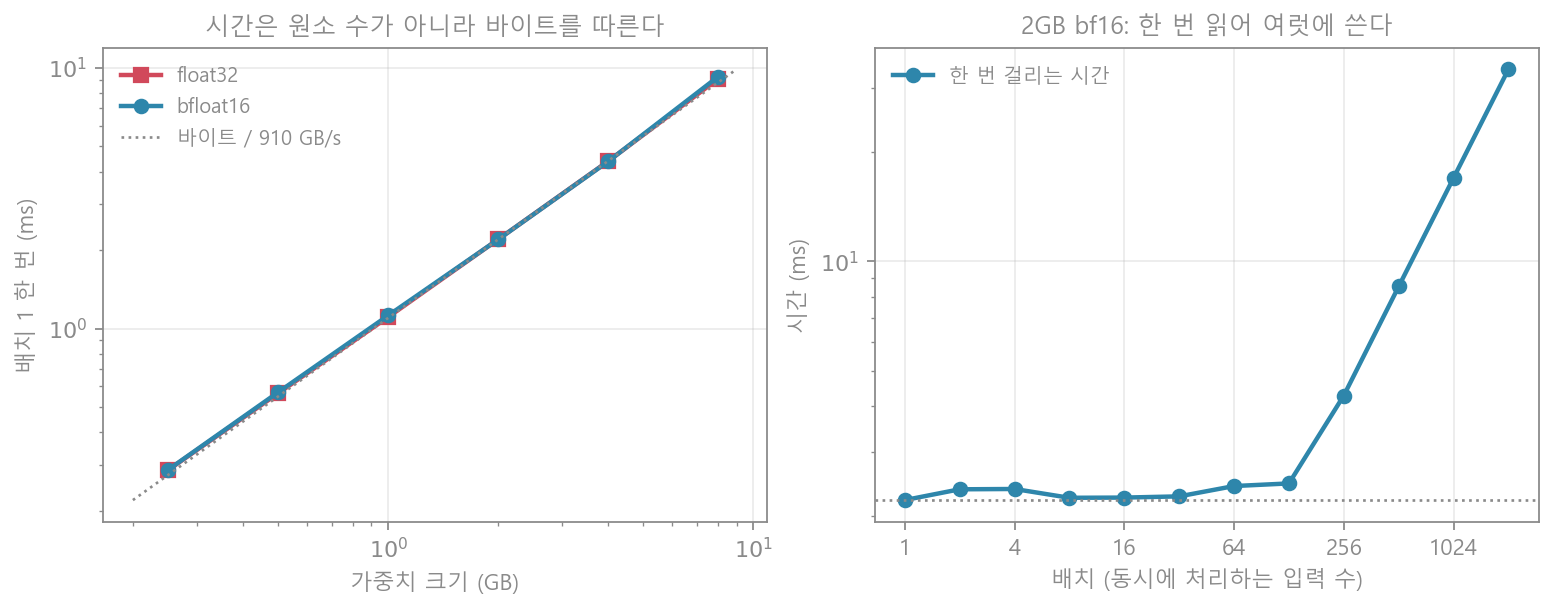
[A] 배치 1: 시간은 읽은 바이트를 따른다
폭 8192 인 행렬에 벡터 하나를 곱했다. 토큰 하나를 만들 때 층마다 하는 일이 이것이다. 행렬 크기를 0.25GB 에서 8GB 까지 늘리며 30번씩 쟀다(중앙값).
| 가중치 크기 | fp32 시간 | bf16 시간 | 유효 대역폭 (bf16) |
|---|---|---|---|
| 0.25 GB | 0.287 ms | 0.287 ms | 869.6 GB/s |
| 1 GB | 1.107 ms | 1.122 ms | 891.1 GB/s |
| 2 GB | 2.198 ms | 2.196 ms | 910.6 GB/s |
| 4 GB | 4.382 ms | 4.375 ms | 914.2 GB/s |
| 8 GB | 9.068 ms | 9.246 ms | 865.2 GB/s |
- 시간이 바이트에 정비례한다. 1GB 이상에서 유효 대역폭의 중앙값은 910.3 GB/s 였다. RTX 5080 의 공개 사양 960GB/s(NVIDIA 발표값을 빌림)의 95% 다.
- 같은 2GB 를 읽는 데 fp32(원소 5억 개)는 2.198 ms, bf16(원소 10억 개)은 2.196 ms 였다. 곱셈 횟수는 두 배인데 시간은 같다. 시간을 정하는 것은 연산이 아니라 바이트다. 양자화 편에서 비트를 줄이면 추론이 빨라지는 이유가 이것이다.
[B] 배치를 키우면
2GB bf16 행렬에 벡터 개를 한꺼번에 곱했다.
| 배치 | 시간 | 연산 속도 | 배치 1 대비 시간 |
|---|---|---|---|
| 1 | 2.209 ms | 0.9 TFLOP/s | ×1.00 |
| 16 | 2.244 ms | 14.3 TFLOP/s | ×1.02 |
| 128 | 2.454 ms | 104.3 TFLOP/s | ×1.11 |
| 256 | 4.280 ms | 119.6 TFLOP/s | ×1.94 |
| 1024 | 16.967 ms | 120.7 TFLOP/s | ×7.68 |
| 2048 | 33.739 ms | 121.4 TFLOP/s | ×15.28 |
- 배치 128 까지는 시간이 11% 만 늘었다. 128배의 일을 거의 같은 시간에 했다.
- 배치 256 부터는 배치가 두 배면 시간도 두 배다. 연산 속도가 약 120 TFLOP/s 에서 멈췄다. 이제 공장이 병목이다.
- 이론상 무릎은 최고 연산 ÷ 대역폭 = 121.4 TFLOP/s ÷ 910.3 GB/s ≈ 133 FLOP/바이트, 곧 bf16 배치 약 133이다. 실측 경계(128과 256 사이)와 맞는다.
배치 1 의 연산 속도 0.9 TFLOP/s 는 최고치의 0.7% 다. 배치 1 추론에서 GPU 연산 장치의 99% 는 놀고 있다.
[C] 한 주기에 읽을 수 있는 바이트
이 GPU 의 유효 대역폭(910.3 GB/s)으로 셈한 :
| 판단 주기 | 한 주기 | 한 주기에 읽을 수 있는 양 |
|---|---|---|
| 10 Hz | 100 ms | 91.03 GB |
| 30 Hz | 33.3 ms | 30.34 GB |
| 100 Hz | 10 ms | 9.10 GB |
직접 확인도 했다. bf16 가중치를 배치 1로 한 번 읽는 데 4GB 는 4.39 ms, 8GB 는 8.88 ms, 12GB 는 13.73 ms 가 걸렸다. 가능한 최대 주기로 바꾸면 227.9 Hz, 112.6 Hz, 72.9 Hz 다.
이제 거꾸로, 메모리를 전부 매 주기 한 번씩 읽으려면 대역폭이 얼마나 필요한가:
| 용량 | 10 Hz | 30 Hz | 100 Hz |
|---|---|---|---|
| 72 GB | 720 GB/s | 2,160 GB/s | 7,200 GB/s |
| 144 GB | 1,440 GB/s | 4,320 GB/s | 14,400 GB/s |
30Hz 기준으로 72GB 는 이 GPU 대역폭의 2.4배, 144GB 는 4.7배가 필요하다. AI5 의 대역폭은 공개되지 않았다. 그래도 구조는 분명하다. 대역폭 × 주기가 72GB 보다 작다면, 매 주기 읽는 모델에게 72GB 와 144GB 의 차이는 보이지 않는다. 머스크의 “무시할 만하다”는 이 조건이 맞을 때 참이다.
참고로 72GB·144GB 에 가중치만 담으면 들어가는 파라미터 수는 이렇다(스크립트에서 계산).
| 비트 | 72 GB | 144 GB |
|---|---|---|
| 16 | 360억 | 720억 |
| 8 | 720억 | 1,440억 |
| 4 | 1,440억 | 2,880억 |
4. 흔한 오해와 한계
“용량은 아무 상관이 없다.” 매 주기 전부 읽는 모델에 한해서다. 용량이 쓸모 있는 경우가 셋 있다.
- 전문가 혼합(MoE). MoE 편처럼 토큰마다 전문가 일부만 읽으면, 읽는 양은 작게 두고 담아 두는 양은 크게 할 수 있다. 용량이 곧 모델의 크기다.
- KV 캐시. KV 캐시 편에서 본 것처럼 긴 문맥과 기억을 담는 데 용량이 든다.
- 여러 모델. 시각·언어·동작 모델을 함께 올려 두고 필요할 때 하나씩 부르는 경우.
로봇의 소프트웨어가 이 중 무엇을 하는지는 공개되지 않았다. “무시할 만하다”가 참인지는 결국 거기에 달려 있다.
“대역폭이 같으면 성능도 같다.” [A]는 배치 1 의 결과다. [B]처럼 배치를 키울 수 있는 일(여러 카메라를 묶어 처리하는 등)에서는 병목이 연산으로 옮겨 간다.
“이 GPU 의 숫자가 AI5 의 숫자다.” 아니다. RTX 5080(GDDR7)과 AI5(LPDDR5)는 메모리 종류부터 다르다. 이 글이 옮겨 쓰는 것은 라는 관계이지 910GB/s 라는 값이 아니다. 보도에 따르면 AI5 는 칩 안에 큰 SRAM 을 두어 자주 쓰는 데이터를 DRAM 보다 훨씬 빠르게 읽는다고 한다. 이 경우 실효 대역폭은 DRAM 대역폭보다 높다.
측정의 한계. 행렬×벡터 하나만 쟀다. 실제 모델에는 어텐션, 활성화 함수, 커널 실행 대기 같은 비용이 더해진다. 그래서 실제 토큰당 시간은 보다 길다. 는 아래쪽 한계로 읽어야 한다.
5. 한 문단 요약
Tesla 는 AI5 칩의 메모리를 144GB 에서 72GB 로 줄이며 성능 영향이 무시할 만하다고 했다. 근거로 든 것은 병목이 용량이 아니라 대역폭이라는 점이다. 배치 1 로 토큰 하나를 만드는 일은 가중치를 한 번씩 다 읽는 일이라서, 시간은 읽은 바이트 ÷ 대역폭으로 정해진다. RTX 5080 에서 같은 2GB 를 읽는 데 fp32 와 bf16 이 2.198 ms 와 2.196 ms 로 같았고, 유효 대역폭은 910 GB/s 였다. 배치를 128 까지 키워도 시간은 11% 만 늘었다. 판단 주기가 면 매 주기 읽을 수 있는 양은 다. 30Hz 로 72GB 를 매번 다 읽으려면 2,160 GB/s, 144GB 면 4,320 GB/s 가 필요하다. 대역폭 × 주기가 용량보다 작으면 남는 용량은 매 주기 쓰이지 않는다. 용량이 다시 중요해지는 것은 MoE, 긴 KV 캐시, 여러 모델처럼 담아 두되 매번 다 읽지는 않는 경우다.
참고
- Teslanorth — Tesla slashed AI5 chip memory to hit Optimus volume, Musk says (2026-10-01)
- Wccftech — Elon Musk slashes memory requirements for Tesla’s AI5 chip by half (2026-10-01)
- Yahoo Finance — Musk says cutting Optimus memory was Tesla’s ‘only way’ to scale
- Williams, Waterman, Patterson — Roofline: An Insightful Visual Performance Model (2009)
- 연재: 산술 강도와 메모리 대역폭 노트 · 양자화 편 · KV 캐시 편 · MoE 편