인지야공/수학·공학 노트/8번째 글
저계수 행렬과 SVD — 큰 행렬을 작게 쪼개기
실행:
python 딥러닝/mathnotes/M2_svd.pyLoRA 편이 “적응은 저계수”라 했다. 그 저계수와 SVD를 정리한다.
1. 특이값 분해(SVD)
어떤 행렬 이든 세 조각으로 쪼갤 수 있다.
| 기호 | 뜻 |
|---|---|
| 회전(직교) 행렬 — 방향 | |
| 대각의 특이값 — 각 방향의 크기 | |
| rank-1 조각 하나. 이걸 큰 것부터 더하면 이 된다 |
즉 행렬은 rank-1 조각들의 합이고, 특이값이 각 조각의 중요도다.
2. 저계수 근사 — 큰 것 몇 개만
특이값이 큰 몇 개가 행렬의 에너지 대부분을 담으면, 그 몇 개만 남겨도 원래와 거의 같다. 상위 개만 쓰는 것이 rank- 근사다.
직접 재 보기
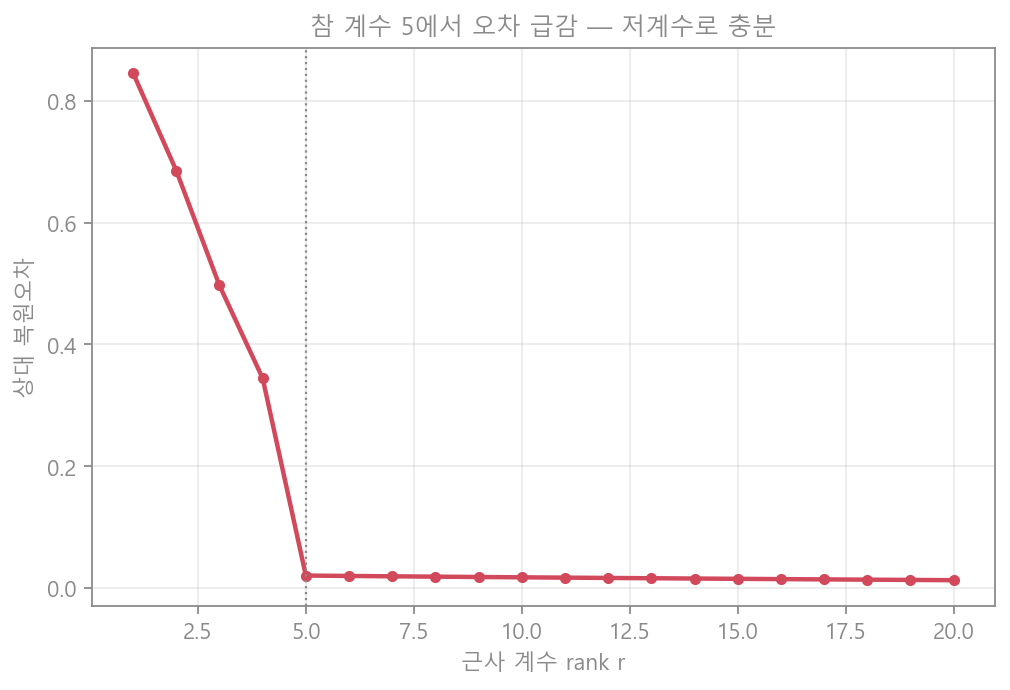
참 계수 5인 행렬(+약간의 잡음)을 SVD 했다.
| 특이값 | |
|---|---|
| 상위 5개 | 82, 76, 73, 55, 53 |
| 그 다음 | 0.8, 0.7, … (뚝 떨어짐) |
| 근사 계수 | 3 | 5 | 8 |
|---|---|---|---|
| 상대 복원오차 | 0.50 | 0.02 | 0.02 |
참 계수 5에서 오차가 급감한다. rank-5 근사는 개 수를 개로 줄인다 (약 1/7). 특이값이 빨리 줄어드는 행렬일수록 저계수로 크게 압축된다.
3. 어디에 쓰나
- LoRA(LoRA 편): 미세조정의 가중치 변화 가 저계수라, (: , : )로 흉내 내 파라미터를 확 줄인다.
- 압축·추천: 이미지·평점 행렬을 저계수로 근사해 저장·예측한다.
- 주성분분석(PCA): 데이터의 큰 특이값 방향이 곧 주성분이다.
4. 한 줄 요약
SVD는 행렬을 rank-1 조각들의 합으로 쪼개고, 큰 특이값 몇 개가 에너지 대부분을 담는다. 그래서 저계수 근사로 큰 행렬을 작게 줄일 수 있고(오차 2%에 1/7), LoRA·압축·PCA가 모두 이 원리다.
연결
- LoRA — 저계수 업데이트로 미세조정