인지야공/딥러닝 기초 정리/34번째 글
기계적 해석가능성 — 프로브에서 회로로
실행:
python NN_20_interpretability.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 중첩 편과 명세 게이밍 편을 잇는 매듭이다.
명세 게이밍 편에서 “통제는 관측에 달렸다”고 했다. 그러면 모델 속을 어떻게 들여다보나. 기계적 해석가능성은 신경망의 활성에서 개념(특징)을 찾아내고, 그것이 정말 그 개념인지 인과로 확인하는 분야다. 세 도구 — 프로브, 스티어링, 그리고 중첩 편의 중첩 — 을 직접 잰다.
1. 프로브 — 활성에서 개념을 읽는다
모델의 은닉 활성 안에 어떤 개념이 들어 있는지 보려면, 그 활성에서 개념을 선형으로 읽을 수 있나를 본다. 개념 라벨을 향해 선형 프로브(작은 선형 분류기)를 학습해, 정확도가 높으면 그 개념은 활성에 선형으로 표현된 것이다(잠재 반복 vs 토큰 사슬 편에서 쓴 그 프로브다).
직접 재 보기 A
특징 16개를 은닉 6차원에 욱여넣도록 학습한 토이 모델에서, 각 특징을 은닉 활성에서 프로브로 읽었다(무작위=50%인 균형정확도).
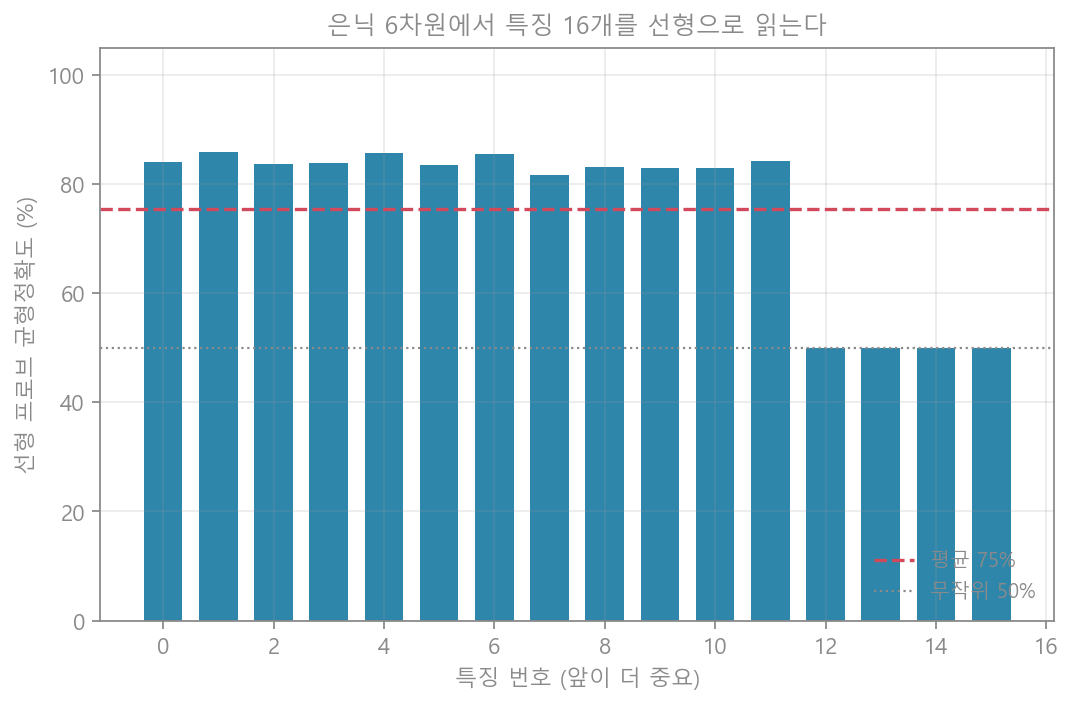
- 평균 균형정확도 75% — 은닉 6차원에서 특징 16개를 선형으로 읽어낸다.
- 그런데 중요한 특징(앞쪽)은 또렷하고, 덜 중요한 특징은 50%(무작위)로 사라졌다. 자리가 모자라니 모델이 중요한 것부터 담고 나머지를 버린 것 — 중첩 편의 “중요도가 살아남을 특징을 정한다”가 그대로 보인다.
2. 스티어링 — 방향을 더하면 인과가 드러난다
프로브가 높다고 그 방향이 진짜 그 개념이라는 보장은 없다(상관일 수 있다). 확인하려면 개입한다 — 그 개념의 방향을 활성에 직접 더하고(스티어링), 출력이 그 개념으로 바뀌는지 본다. 바뀌면 인과다.
직접 재 보기 B
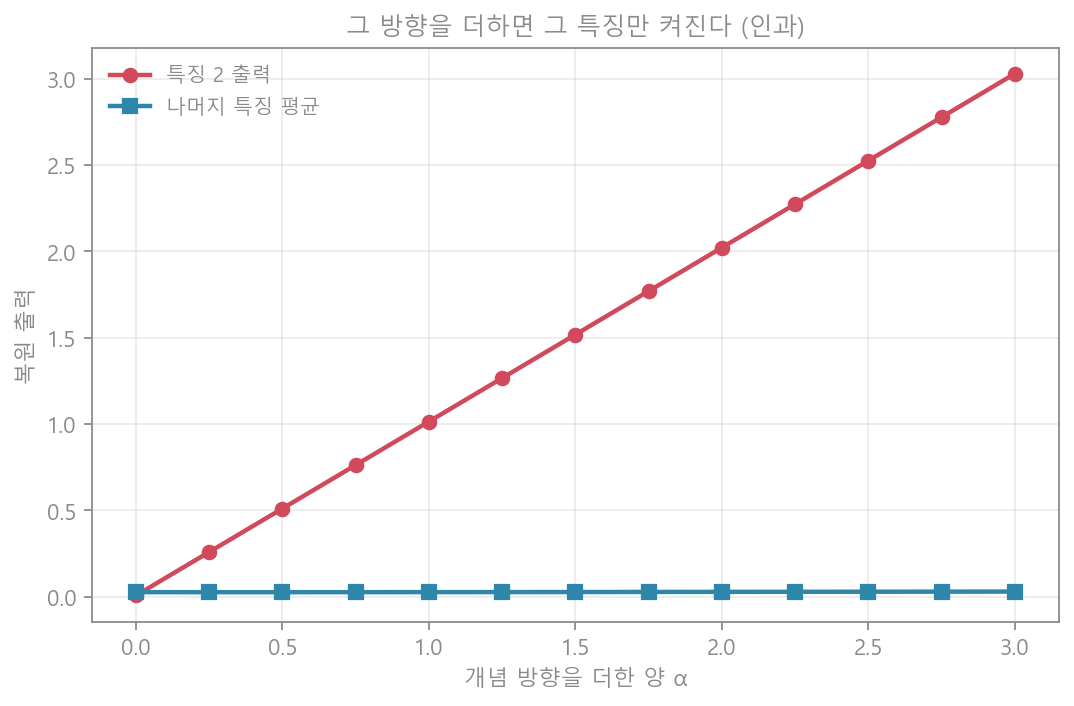
빈 활성에 특징 2의 방향을 배 더하고 출력을 봤다.
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 특징 2 출력 | 0.01 | 1.01 | 2.02 | 3.03 |
| 나머지 특징 평균 | 0.03 | 0.03 | 0.03 | 0.03 |
그 방향을 더한 만큼 특징 2 출력만 정확히 올랐고, 나머지는 꿈쩍하지 않았다. 상관이 아니라 인과다 — 이 방향이 곧 “특징 2”라는 개념이다. 실제 LLM 에서 “정직함”·“아첨” 같은 방향을 찾아 더하거나 빼서 행동을 조종하는 연구가 이 원리다.
3. 중첩 — 뉴런보다 많은 개념이 겹쳐 산다
특징 16개를 6차원에 담았다. 6개의 직교 방향밖에 없는데 어떻게 16개를? 중첩 편의 답 — 비직교로 겹쳐(중첩) 담는다. 특징이 희소하면(동시에 몇 개만 켜지면) 겹쳐도 서로 잘 안 부딪힌다.
직접 재 보기 C
특징 방향들의 간섭(방향 간 코사인 유사도)을 봤다. 직교면 비대각이 0, 겹치면 0이 아니다.
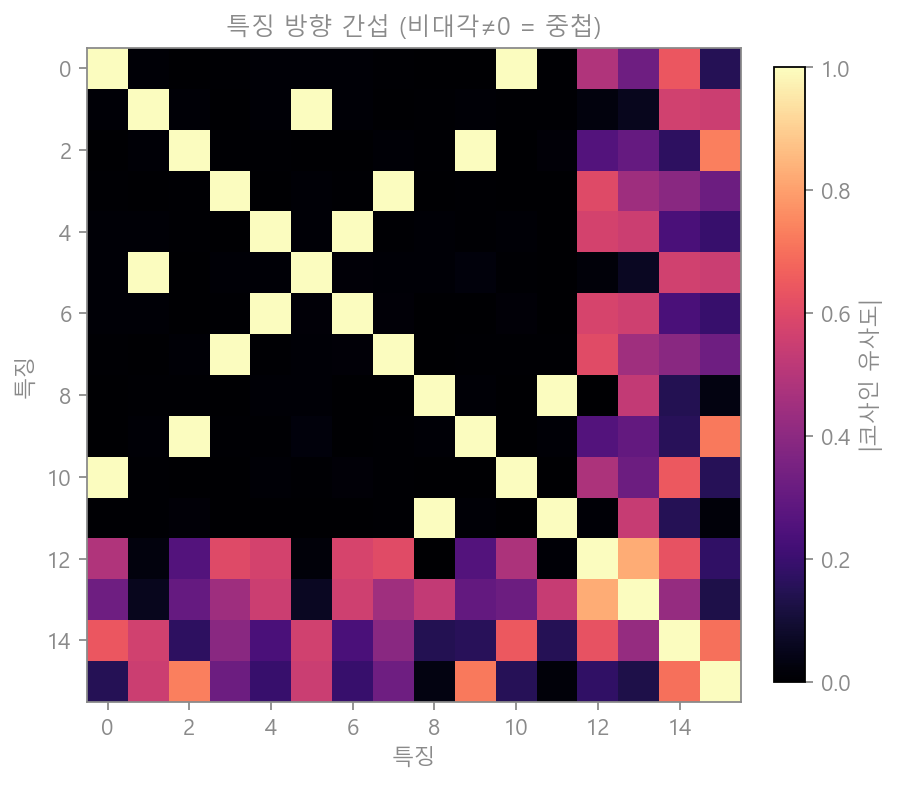
- 비대각 간섭 평균 0.216 — 방향들이 직교가 아니라 서로 겹쳐 있다(중첩).
- 은닉 뉴런 하나가 평균 6.8개 특징에 관여 — 한 뉴런이 여러 개념을 겸하는 다의성(polysemanticity)이다.
이 중첩·다의성이 해석을 어렵게 만드는 근본 이유다. 뉴런 하나를 열어 봐도 여러 개념이 섞여 있어 “이 뉴런 = 이 개념”이 아니다. 그래서 최근 해석가능성은 희소 오토인코더(SAE)로 겹친 특징을 다시 풀어내(단의미 특징으로 분해), 개별 개념의 방향을 찾고 회로를 그린다.
4. 흔한 오해와 한계
- “프로브가 높으면 그 개념을 쓴다” — 아니다. 프로브는 상관만 본다. 그 방향을 개입(스티어링)해 출력이 바뀌어야 인과다(2절).
- “뉴런 하나 = 개념 하나” — 아니다. 중첩·다의성 때문에 뉴런은 여러 개념을 겸한다(3절).
- “해석하면 안전하다” — 해석은 관측을 늘릴 뿐, 그 자체로 정렬을 보장하진 않는다(명세 게이밍 편). 다만 관측이 없으면 통제도 없다.
- 이 글의 실험 — Anthropic의 중첩 토이 모델을 축소한 것이다. 75%·6.8 같은 수는 이 설정의 값이고, 요점은 프로브(상관)→스티어링(인과)→중첩/다의성이라는 구조다.
5. 한 문단 요약
기계적 해석가능성은 모델 속 개념을 찾고 인과로 확인한다. 선형 프로브는 은닉 활성에서 개념을 읽어내는데(6차원에서 특징 16개, 균형정확도 75%), 자리가 모자라면 중요한 특징부터 담고 나머지는 무작위로 사라진다(중첩 편의 중요도). 프로브는 상관이라, 개념의 방향을 활성에 더하는 스티어링으로 그 특징만 정확히 켜지는 것을 보여야 인과가 확인된다. 그리고 뉴런보다 개념이 많아 방향들이 겹쳐(중첩, 간섭 0.216) 저장되고 뉴런 하나가 여러 개념을 겸해(6.8개) 해석을 어렵게 한다 — 그래서 희소 오토인코더로 다시 풀어낸다. 이것으로 딥러닝 기초 정리의 한 바퀴, 구조 → 학습 → 규모 → 정렬 → 해석이 닫힌다.