인지야공/딥러닝 기초 정리/20번째 글
전문가 혼합(MoE) — 큰데 싸게, 그리고 저절로 나뉜다
실행:
python NN_16_moe.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 트랜스포머 층 해부 편의 FFN을 여러 전문가로 쪼개는 이야기다.
스케일링 법칙 편은 “키우면 좋아진다”고 했다. 그런데 키우면 계산도 커진다. MoE(전문가 혼합)는 이 고리를 끊는다 — 파라미터(용량)는 키우되 토큰당 계산은 그대로 둔다. 어떻게 가능한지, 그리고 아무도 안 가르쳤는데 전문가가 저절로 나뉘는 것을 잰다.
1. 희소성 — 총량은 크고 계산은 활성만
보통(밀집) 층은 토큰 하나에 모든 파라미터를 쓴다(트랜스포머 층 해부 편의 FFN). MoE는 그 큰 FFN을 작은 전문가 여럿으로 쪼개고, 작은 라우터가 토큰마다 몇 명만 고른다.
| 기호 | 뜻 |
|---|---|
| 라우터 (각 전문가 점수) | |
| 게이트(softmax) 가중치 | |
| 점수 상위 명만 (나머지는 계산 안 함) | |
| 번째 전문가(작은 FFN) |
직접 재 보기 A
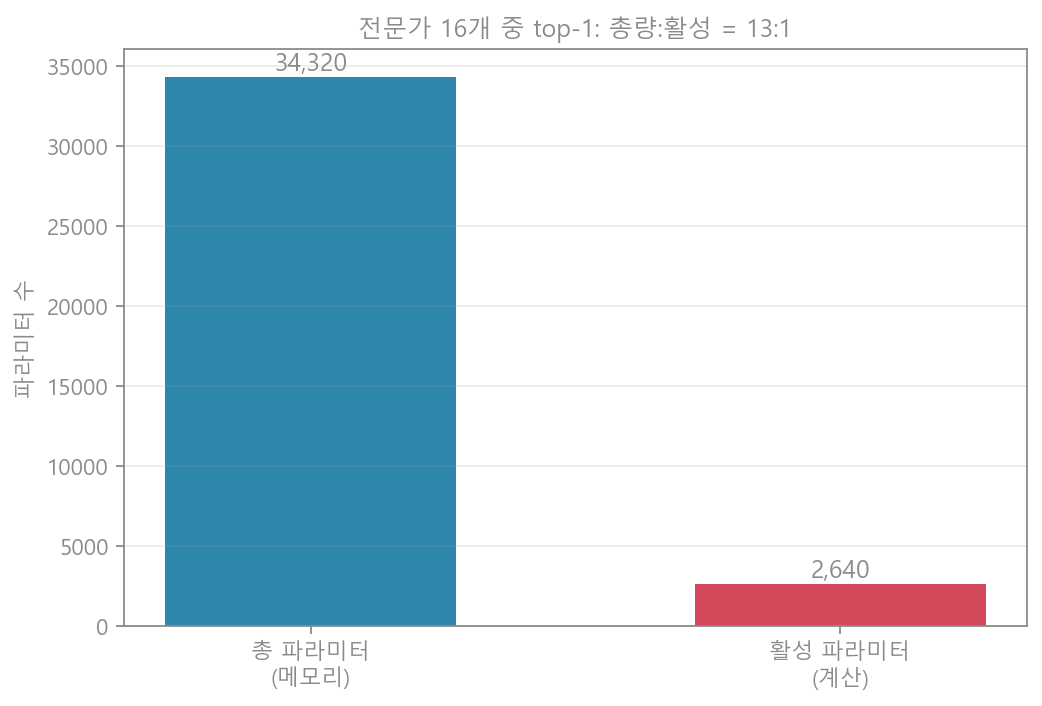
전문가 16개(각 폭 32), top-1 로 재니 총 34,320 / 활성 2,640 = 13 : 1. 메모리는 16명을 다 들고 있어야 하지만 계산은 한 명만 한다. KV 캐시 편이 추론에서 메모리로 계산을 아꼈다면, MoE는 반대로 메모리를 더 써서 용량을 사고 계산은 아낀다.
2. 특화 — 아무도 안 가르쳤는데 나뉜다
MoE의 아름다운 점은 라우터가 저절로 전문가를 나눈다는 것이다. 입력이 여러 종류(군집)에서 오면, 라우터는 비슷한 입력을 같은 전문가로 보내고 각 전문가는 그 종류에 특화한다.
직접 재 보기 B
입력이 8개 군집에서 나오고 군집마다 다른 규칙을 갖는 과제로 MoE(전문가 16)를 학습시킨 뒤, 어떤 입력이 어떤 전문가로 갔는지 봤다.
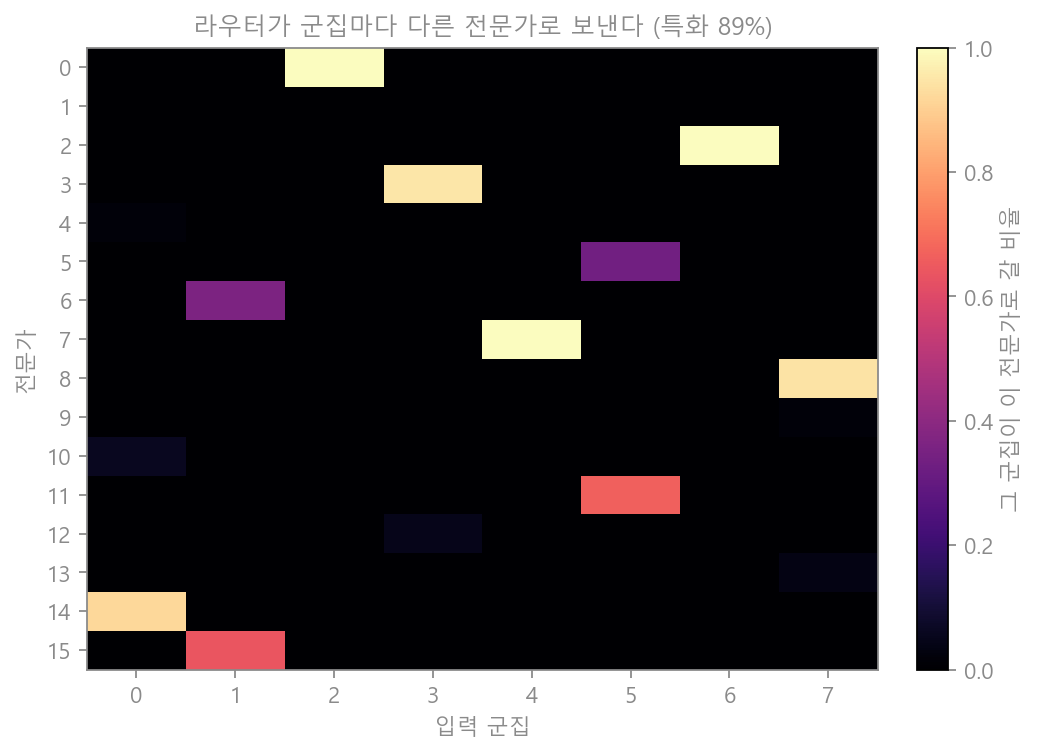
히트맵의 밝은 칸이 “그 군집이 그 전문가로 간다”는 뜻이다. 각 군집이 한 전문가에 몰린 비율이 평균 89% — 아무도 “군집 3은 전문가 5로”라고 안 가르쳤는데 라우터가 스스로 나눴다. 16명 중 일부만 쓰이고(희소) 각자 한 종류를 맡는다. 이 특화가 MoE가 용량을 효율적으로 쓰는 방식이다.
대가는 09-16 데일리에서 본 부하 균형이다 — 그냥 두면 인기 전문가에 쏠려 나머지가 죽으므로, 균형 손실로 고르게 쓰도록 떠민다.
3. 큰데 싸게 — 전문가를 늘리면
MoE의 핵심 주장: 활성 계산은 그대로 둔 채 전문가(=총 파라미터)만 늘리면 좋아진다. top-1이라 계산은 언제나 전문가 하나인데, 전문가가 많을수록 각자 더 좁게 특화해 전체 용량이 는다.
직접 재 보기 C
전문가 수 만 1→16으로 늘렸다(각 전문가 폭 고정 = 활성 계산 그대로).
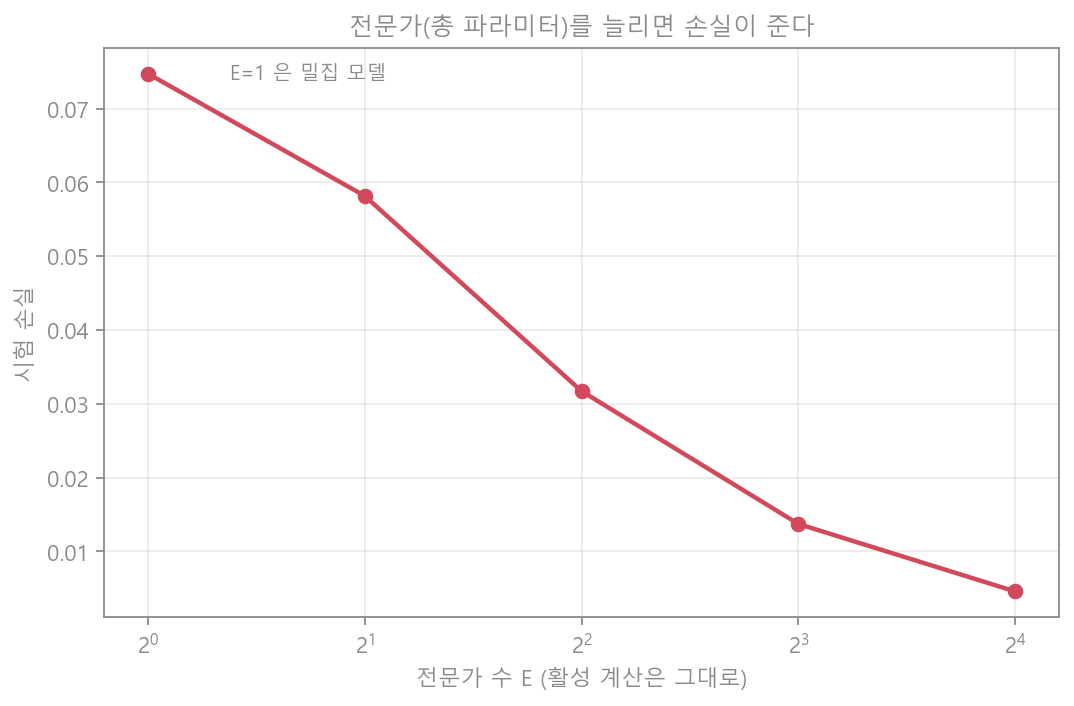
| 전문가 수 | 1 | 2 | 4 | 8 | 16 |
|---|---|---|---|---|---|
| 총 파라미터 | 2,145 | 4,290 | 8,580 | 17,160 | 34,320 |
| 활성(계산) | 그대로 | 그대로 | 그대로 | 그대로 | 그대로 |
| 시험 손실 | 0.0747 | 0.0582 | 0.0317 | 0.0137 | 0.0046 |
은 그냥 밀집 모델이다. 전문가를 16개로 늘리자 활성 계산은 한 명 그대로인데 손실이 16배(0.075→0.0046) 줄었다. 총 파라미터(메모리)를 늘려 계산을 늘리지 않고 성능을 산 것 — 이것이 “큰데 싸게”의 정체다. GLM-5.2 (744B/40B), Mixtral, DeepSeek 같은 요즘 큰 모델이 MoE를 쓰는 이유다.
4. 흔한 오해와 한계
- “MoE는 공짜 점심” — 아니다. 계산은 아끼지만 메모리는 총량을 다 들고 있어야 하고(전문가 전부 상주), 전문가 간 통신·부하 균형 부담이 있다. 계산 대신 메모리·대역폭으로 비용이 옮겨 갈 뿐이다.
- “전문가는 사람이 나눈다” — 아니다. 2절처럼 라우터가 학습으로 저절로 나눈다. 무엇을 맡을지는 사람이 지정하지 않는다.
- “top-1이 항상 최선” — 아니다. top-2가 흔하다. 여러 전문가를 섞으면 표현력이 늘지만 계산도 그만큼 는다.
- 이 글의 실험 — 합성 과제의 축소 모형이다. 13:1, 89%, 16배 같은 수는 이 설정의 값이고, 요점은 희소성·특화 창발·용량↑ 계산 고정이라는 구조다.
5. 한 문단 요약
MoE는 큰 FFN을 전문가 여럿으로 쪼개고 라우터가 토큰마다 top-만 켠다. 그래서 총 파라미터(메모리)는 크고 계산은 활성만(재 보니 16명 중 1명, 13:1). 놀랍게도 라우터는 아무도 안 가르쳤는데 입력 군집마다 다른 전문가로 보내며 89% 특화를 스스로 만들었다. 그리고 활성 계산을 그대로 둔 채 전문가를 1→16개로 늘리자 손실이 16배(0.075→0.0046) 줄었다 — 메모리를 더 써서 용량을 사고 계산은 아끼는 것이다. KV 캐시 편이 추론의 메모리 산수였다면, MoE는 모델 용량의 메모리 산수다. 대신 부하 균형이라는 대가가 따른다.
참고
- Shazeer 외 — Outrageously Large Neural Networks (MoE, 2017)
- Fedus 외 — Switch Transformers (2022) — top-1 라우팅·부하 균형
- DeepSeek-V3 Technical Report (2024) — 세분화된 전문가·공유 전문가
- 연재: 트랜스포머 층 해부 · 스케일링 법칙 · KV 캐시