인지야공/딥러닝 기초 정리/18번째 글
양자화 — 비트를 줄여도 되는 이유
실행:
python NN_17_quantization.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. KV 캐시 편에서 본 “추론은 메모리에 묶인다”를 이어, 그 메모리를 줄인다.
KV 캐시 편에서 생성은 계산이 아니라 메모리 대역폭에 묶인다고 했다. 그렇다면 가중치를 더 적은 비트로 저장하면 읽을 게 줄어 빨라지고 메모리도 아낀다. 이것이 양자화다. 놀랍게도 32비트를 4비트로 줄여도 성능이 거의 안 변한다. 왜 되는지, 어디서 무너지는지를 잰다.
1. 양자화란 — 실수를 정수 눈금에 맞추기
가중치는 보통 32/16비트 실수다. 양자화는 이를 정수 눈금에 올린다. 대칭 양자화는 이렇다.
| 기호 | 뜻 |
|---|---|
| 비트 수 (예: 4 → 정수 ) | |
| 스케일 — 실수 한 칸의 크기 | |
| 가장 가까운 눈금으로 반올림한 값 |
비트면 눈금이 칸뿐이다. 반올림하면서 생기는 양자화 오차가 성능을 얼마나 갉아먹느냐가 관건이다.
직접 재 보기 A
학습된 모델의 가중치를 비트 수를 줄여가며 양자화하고 시험 손실을 쟀다.
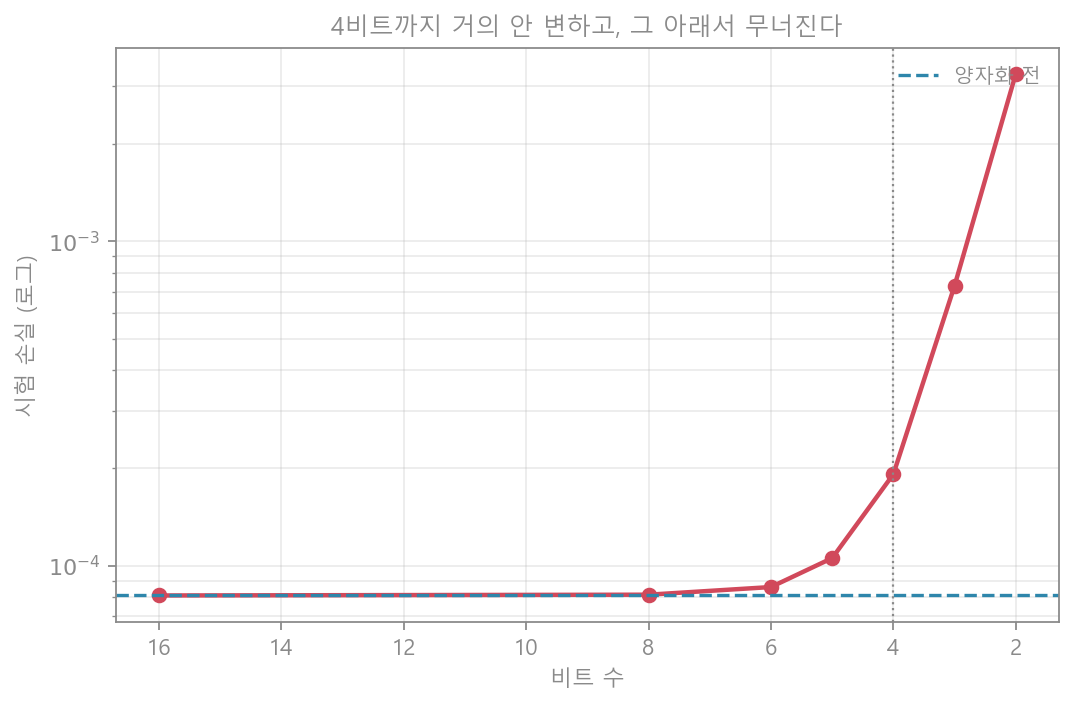
| 비트 | 16 | 8 | 6 | 4 | 3 | 2 |
|---|---|---|---|---|---|---|
| 손실 (배율) | 1.0× | 1.0× | 1.1× | 2.4× | 9.0× | 40.6× |
8비트는 원본과 사실상 같고, 4비트도 2.4배뿐이다. 그 아래(3·2비트)서 급격히 무너진다. 신경망은 가중치의 작은 반올림 오차에 놀랄 만큼 둔감하다 — 층이 많아 오차가 평균되고, 학습이 애초에 정확한 값이 아니라 대략적 방향을 쓰기 때문이다. 그래서 4비트 근처가 실무의 달콤한 지점이다.
2. 왜 하나 — 메모리가 준다
직접 재 보기 B
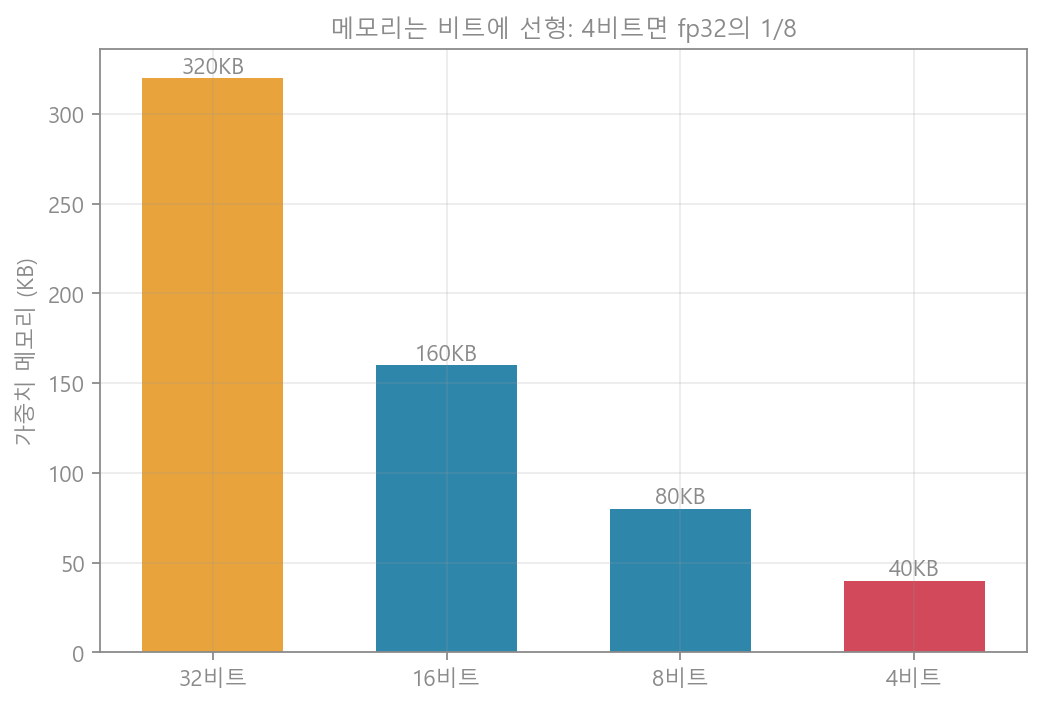
메모리는 비트 수에 정비례한다. fp32 → 4비트면 1/8. 70B 모델이라면 fp16 140GB가 4비트로 35GB가 된다 — KV 캐시 편에서 본 메모리 병목을 그만큼 덜고, 읽을 바이트가 줄어 생성도 빨라진다. 큰 모델을 소비자 GPU에 올리는 것이 대부분 이 4비트 양자화 덕이다.
3. 함정 — 이상치 하나가 다 망친다
문제가 하나 있다. 스케일 는 가장 큰 값()에 맞춰 정해진다. 그런데 가중치에 유독 큰 이상치가 하나 섞여 있으면, 가 그 이상치에 끌려 커지고 — 나머지 작은 값들은 몇 안 되는 눈금에 뭉개진다.
해법은 스케일을 더 잘게 잡는 것이다. 텐서 전체에 스케일 하나(per-tensor) 대신, 출력 채널마다 스케일을 따로(per-channel) 잡으면 이상치가 자기 채널 안에만 갇힌다.
직접 재 보기 C
한 출력 채널에 8배 큰 이상치를 심고, 두 방식을 비교했다.
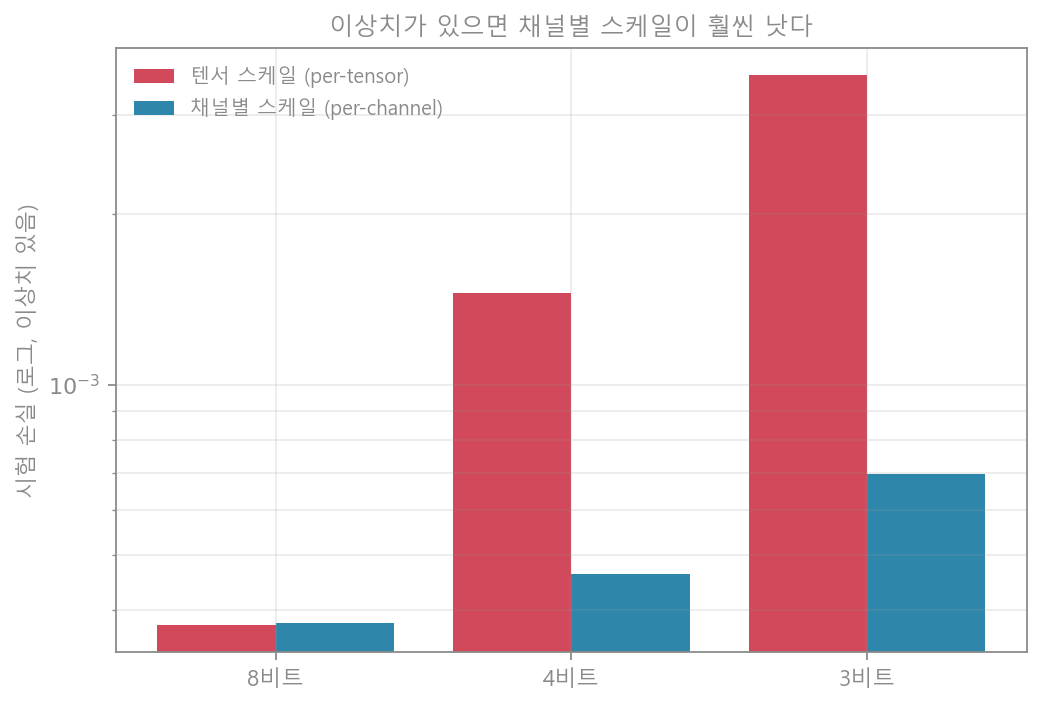
| 비트 | 텐서 스케일 | 채널별 스케일 |
|---|---|---|
| 8 | 0.00038 | 0.00038 (같음) |
| 4 | 0.00145 | 0.00046 (3.1배 낫다) |
| 3 | 0.00353 | 0.00070 (5.1배 낫다) |
8비트에서는 눈금이 넉넉해 차이가 없지만, 4·3비트에서 채널별 스케일이 3~5배 낫다. 이상치를 자기 채널에 가두니 다른 채널이 뭉개지지 않는다. 실제 LLM 양자화(GPTQ·AWQ 등)가 씨름하는 것이 바로 이 이상치 채널이다 — 큰 모델일수록 소수 채널에 거대한 값이 몰려, 이를 어떻게 다루느냐가 저비트 양자화의 핵심이다.
4. 흔한 오해와 한계
- “비트를 줄이면 항상 나빠진다” — 4비트까지는 거의 안 나빠진다(1절). 신경망의 둔감함 덕이다.
- “그냥 반올림하면 끝” — 아니다. 이상치 때문에 스케일을 어떻게 잡느냐가 저비트에서 결정적이다(3절). 실무는 채널별·그룹별 스케일, 이상치 분리 등을 쓴다.
- “학습이랑 같다” — 이 글은 학습 후 양자화(PTQ)다. 더 낮은 비트가 필요하면 양자화를 감안해 다시 학습 (QAT)하기도 한다.
- 이 글의 실험 — 작은 회귀 모델의 축소 재현이다. “4비트 문턱, 이상치엔 채널별”이라는 구조가 요점이고, 정확한 문턱은 모델·과제마다 다르다.
5. 한 문단 요약
양자화는 가중치를 적은 비트의 정수 눈금에 올려 메모리를 줄인다. 신경망은 반올림 오차에 둔감해, 재 보니 8비트는 손실 그대로, 4비트도 2.4배뿐이고 그 아래서 무너진다. 메모리는 비트에 선형이라 4비트면 1/8 — KV 캐시 편의 메모리 병목을 그만큼 덜고 생성도 빨라진다. 다만 스케일이 최댓값에 맞춰지므로 이상치 하나가 나머지를 뭉갠다; 출력 채널마다 스케일을 따로 잡으면 4비트 오차가 3배 줄었다. 그래서 저비트 LLM 양자화의 실제 싸움은 이상치 채널을 어떻게 가두느냐다. 큰 모델을 작은 하드웨어에 올리는 마법의 대부분이 이 4비트 양자화다.