인지야공/딥러닝 기초 정리/47번째 글
적대적 예제 — 눈에 안 보이는 변화가 답을 뒤집는다
실행:
python NN_41_adversarial.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 함께 보면 좋은 글: 캘리브레이션 편
캘리브레이션 편에서 모델이 무작위 잡음에 97.2%로 확신하는 것을 봤다. 이번에는 반대쪽이다 — 제대로 맞히던 입력을 아주 조금만 건드려 답을 뒤집을 수 있을까.
1. 무엇을 하는 공격인가 — 그림으로 먼저
입력 하나를 점 하나로 보면, 모델의 결정 경계는 그 점 주변 어딘가를 지난다. 공격은 허용된 상자 안에서 경계 쪽으로 가장 빨리 가는 방향을 찾는 일이다. 상자는 “픽셀마다 최대 까지만 바꾼다”는 제약이다.
③이 요점이다. 상자의 크기는 같은데, 어느 모서리로 가느냐에 따라 경계를 넘기도 하고 안 넘기기도 한다. 공격은 그 모서리를 찾는 최적화 문제다.
| 기호 | 뜻 |
|---|---|
| 원래 입력과 정답 | |
| 더할 변화(섭동) | |
| 모든 픽셀이 이내로만 바뀐다 | |
| 손실. 이걸 크게 만드는 것이 공격의 목표다 |
푸는 방법도 학습과 똑같다 — 그래디언트를 따라 올라가면 된다(PGD: 조금 올라가고 상자 안으로 되돌리기를 반복). 학습이 손실을 내리는 일이었다면, 공격은 입력에 대해 손실을 올리는 일이다.
2. 직접 재 보기 A — 얼마나 조금이면 되나
도형 12종 분류기(깨끗한 정확도 85.0%)에 PGD 공격을 걸고 만 바꿨다.
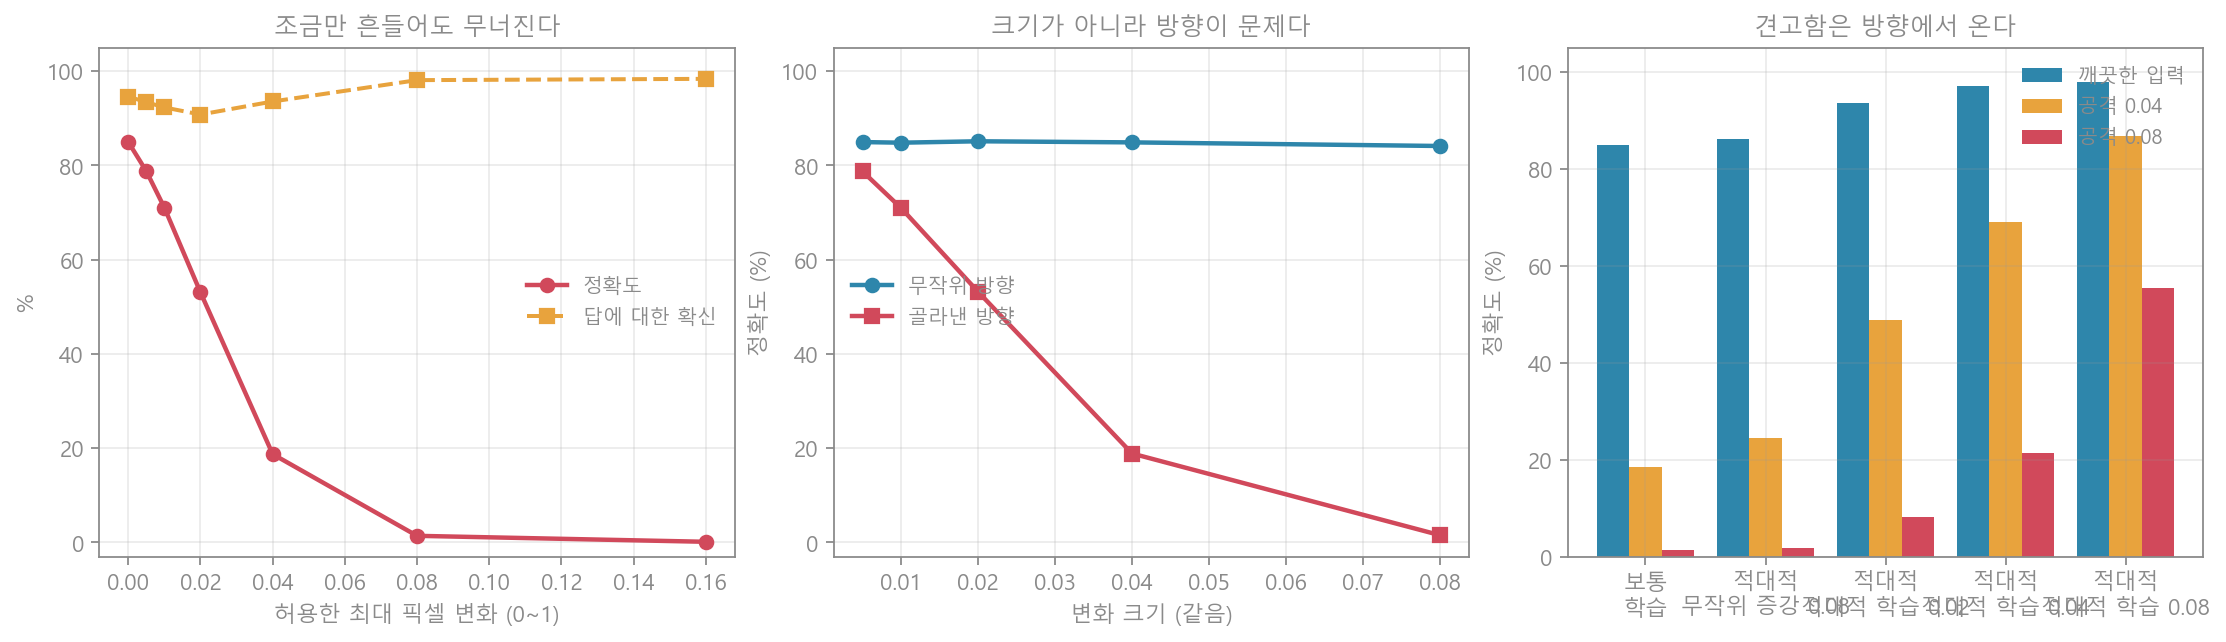
| 최대 픽셀 변화 | 0 | 0.005 | 0.01 | 0.02 | 0.04 | 0.08 |
|---|---|---|---|---|---|---|
| 정확도 | 85.0% | 78.8% | 71.0% | 53.1% | 18.7% | 1.4% |
| 답에 대한 평균 확신 | 94.6% | 93.4% | 92.3% | 90.8% | 93.6% | 98.1% |
0~1 밝기 중 4%만 흔들면 85%가 18.7%로 무너진다. 8%면 1.4%, 사실상 전멸이다.
더 불편한 것은 두 번째 줄이다. 틀리면서 확신은 오히려 올라간다(0.08에서 98.1%). 모델은 자기가 속았다는 신호를 전혀 내보내지 않는다. 캘리브레이션 편에서 무작위 잡음에 97.2%로 확신하던 것과 같은 성질이고, 그래서 확신 값으로 공격을 거를 수 없다.
변화를 키우면서 그림과 확률이 어떻게 바뀌는지 그대로 찍었다.
왼쪽 그림은 거의 변하지 않는데, 오른쪽 확률 막대는 어느 순간 다른 클래스로 통째로 넘어간다.
3. 직접 재 보기 B — 크기가 아니라 방향이다
“그 정도 흔들면 원래 틀리는 것 아닌가?” 같은 크기를 무작위 방향으로 줘 보면 답이 나온다.
| 변화 크기 | 0.005 | 0.01 | 0.02 | 0.04 | 0.08 |
|---|---|---|---|---|---|
| 무작위 방향 | 85.0% | 84.8% | 85.1% | 84.9% | 84.1% |
| 골라낸 방향 | 78.7% | 71.0% | 53.2% | 18.9% | 1.5% |
| 차이 | 6.2%p | 13.9%p | 31.9%p | 66.0%p | 82.6%p |
무작위로 흔들면 0.08에서도 84.1%로 멀쩡하다. 같은 크기인데 결과가 완전히 다르다.
방향 하나가 얼마나 특별한지 직접 재 보면, 같은 크기(0.02)를 줬을 때 정답 점수가 떨어진 양이 골라낸 방향 4.214 대 무작위 방향 0.428 — 10배다.
이유는 차원에 있다. 입력이 256차원이라 방향의 가짓수가 어마어마한데, 정답을 깎는 쪽으로 정렬된 방향은 그중 아주 좁다. 무작위로 고르면 걸릴 일이 거의 없고(고차원 기하 노트), 그래디언트는 그 좁은 방향을 정확히 짚어 준다. 적대적 예제는 이상한 잡음이 아니라 가장 해로운 쪽으로 줄 세운 잡음이다.
4. 직접 재 보기 C — 방어는 방향에서 온다
그렇다면 학습할 때부터 흔들어 주면 될까. 무작위로 흔든 것과 가장 나쁜 쪽으로 흔든 것(적대적 학습)을 갈라 봤다.
| 학습 방식 | 깨끗한 입력 | 공격 | 공격 |
|---|---|---|---|
| 보통 학습 | 85.0% | 18.5% | 1.4% |
| 무작위 증강 0.08 | 86.2% | 24.5% | 1.8% |
| 적대적 학습 0.02 | 93.6% | 48.8% | 8.1% |
| 적대적 학습 0.04 | 97.1% | 69.0% | 21.4% |
| 적대적 학습 0.08 | 98.0% | 86.8% | 55.5% |
무작위 증강은 거의 소용이 없다(18.5% → 24.5%). 같은 크기로 흔들었는데도 그렇다. 반면 가장 나쁜 쪽으로 흔들어 학습시키면 같은 공격에서 86.8%가 된다. 3절의 결론이 방어에도 그대로 적용된다 — 중요한 것은 흔들었다는 사실이 아니라 어느 쪽으로 흔들었느냐다.
한 가지 정직하게 덧붙일 것이 있다. 교과서는 보통 적대적 학습이 깨끗한 정확도를 깎는다고 하는데, 이 실험에서는 오히려 85.0%에서 98.0%로 올랐다. 과제가 작고 잡음이 많아 적대적 탐색이 강력한 정규화로 작동했기 때문이다. 데이터가 크고 깨끗한 실제 과제(ImageNet 등)에서는 그 대가가 분명히 나타난다 — 이 표만 보고 “적대적 학습은 공짜”라고 읽으면 안 된다.
5. 흔한 오해와 한계
- “모델이 헷갈릴 만큼 망가뜨린 것” — 아니다. 밝기의 4%이고, 무작위로 같은 크기를 주면 멀쩡하다(3절).
- “확신이 낮아지니 걸러낼 수 있다” — 반대였다. 공격이 셀수록 확신이 올라갔다(0.08에서 98.1%).
- “잡음을 섞어 학습하면 막힌다” — 거의 안 막힌다(4절, 24.5%).
- “적대적 학습은 손해가 없다” — 이 과제에서만 그랬다. 4절 마지막 문단대로 큰 과제에서는 대가가 있다.
- 이 글의 실험 — 16×16 도형과 작은 MLP다. 4%·86.8% 같은 수는 이 설정의 값이고, 요점은 좁은 방향이 존재한다, 그래디언트가 그걸 찾는다, 방어도 같은 방향을 봐야 한다는 구조다. 또한 공격자가 모델 내부를 안다고 가정했다(화이트박스).
6. 한 문단 요약
제대로 맞히던 입력을 밝기의 4%만 흔들자 정확도가 85.0%에서 18.7%로, 8%에서는 1.4%로 무너졌다. 그런데 모델의 확신은 오히려 98.1%까지 올라, 속았다는 신호가 전혀 없었다. 핵심은 크기가 아니라 방향이다 — 같은 크기를 무작위로 주면 84.1%로 멀쩡했고, 정답 점수가 깎이는 양이 10배 차이였다. 256차원 안에서 “해로운 방향”은 아주 좁은데 그래디언트가 그것을 정확히 짚는다. 방어도 같은 이야기다. 무작위로 흔들어 학습시키면 18.5%가 24.5%로 거의 그대로지만, 가장 나쁜 쪽으로 흔들어 학습시키면 86.8%가 된다. 적대적 예제는 모델의 버그라기보다, 고차원에서 결정 경계가 어디에 놓여 있는지를 드러내는 성질이다.