인지야공/딥러닝 기초 정리/5번째 글
토크나이저와 임베딩 — 텍스트가 숫자가 되기까지
실행:
python NN_13_tokenizer_embedding.py(검증 환경: torch 2.8.0+cu129) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 위치 인코딩 편의 위치 인코딩이 더해지기 전, 텍스트가 벡터가 되는 첫 단계다.
모델을 학습시키는 법은 정규화와 잔차·최적화 편에서 다룬다. 그런데 애초에 텍스트를 어떻게 숫자로 넣는가? 모델은 숫자만 먹는다. 글자를 토큰으로 자르고(토크나이저), 토큰을 벡터로 바꾸는(임베딩) 이 첫 단계를 잰다.
1. 왜 글자도 단어도 아닌가
두 극단이 있다.
- 글자 단위: 어휘가 아주 작지만(수백 개), 시퀀스가 너무 길어진다. 어텐션 계산은 길이의 제곱이라(어텐션 편) 치명적이다.
- 단어 단위: 시퀀스는 짧지만, 어휘가 폭발하고(수십만) 처음 보는 단어를 전혀 처리 못 한다.
그 사이를 잡는 것이 서브워드(subword), 대표적으로 BPE(Byte-Pair Encoding) 다. 자주 쓰는 조각은 한 토큰, 드문 것은 잘게 — 흔한 단어는 통째로, 희귀어는 조각으로 나눈다.
BPE 알고리즘
1. 텍스트를 가장 작은 단위(글자 또는 바이트)로 쪼갠다.
2. 지금 가장 자주 '붙어 나오는 인접 쌍'을 찾는다.
3. 그 쌍을 하나의 새 토큰으로 합친다(= 어휘에 추가).
4. 원하는 어휘 크기가 될 때까지 2~3을 반복한다.
핵심은 “가장 자주 붙는 쌍부터 합친다” 이다. 빈도가 압축을 이끈다.
직접 재 보기 A
한국어 말뭉치에 BPE 를 직접 돌렸다(글자에서 시작).
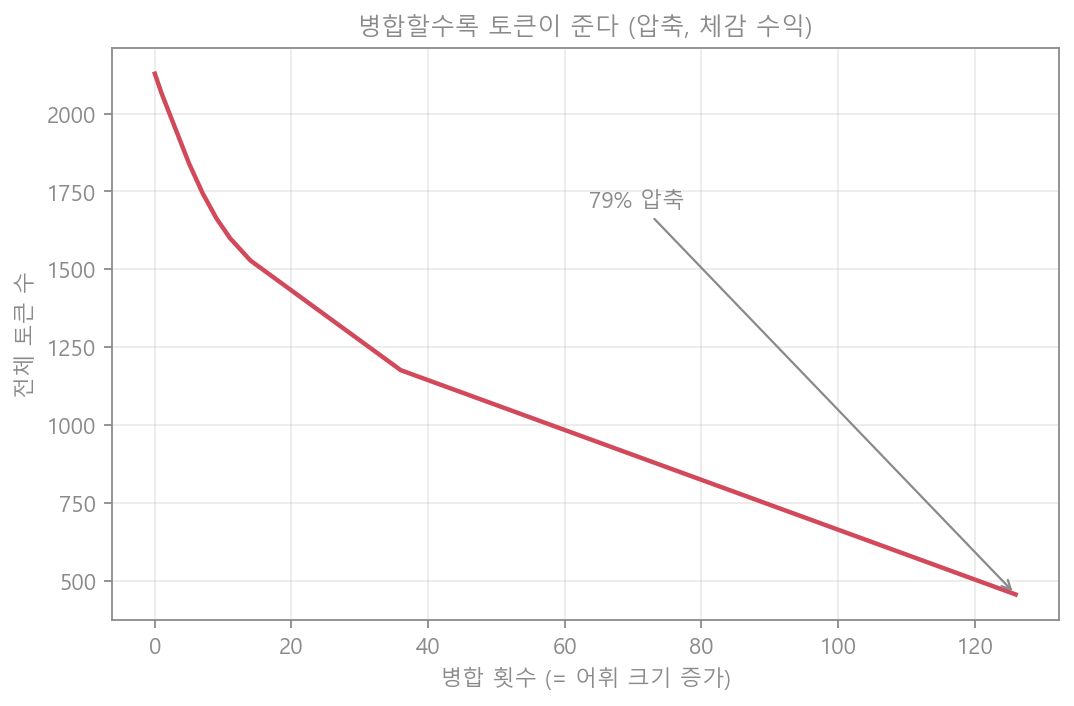
- 문자 토큰 2,128개 → 456개, 78.6% 압축 (126번 병합, 작은 말뭉치라 쌍이 소진되어 멈춤).
- 곡선은 체감 수익이다 — 처음 몇 병합이 가장 크게 줄이고, 갈수록 완만해진다.
먼저 합쳐진 조각을 보면, 규칙이 아니라 빈도만으로 의미 단위가 저절로 생긴다.
| 순서 | 합쳐진 쌍 | 결과 |
|---|---|---|
| 1 | 는 + </w> | 는_ (조사) |
| 2 | 다 + . | 다. (문장 끝) |
| 8 | 토 + 큰 | 토큰 |
| 9 | 학 + 습 | 학습 |
(</w> 는 단어 끝 표시.) “토큰”, “학습” 같은 단어와 “는_” 같은 조사가 아무도 안 가르쳤는데 튀어나왔다.
2. 어휘 크기 — 짧은 시퀀스 vs 큰 표
어휘를 키우면(=병합을 더 하면) 좋기만 할까? 아니다. 저울의 양쪽이 있다.
- 시퀀스가 짧아진다 → 어텐션 계산(길이²)이 싸진다. 좋다.
- 임베딩 표가 커진다 → 어휘 × 차원 만큼 파라미터가 늘고, 출력 소프트맥스도 무거워진다. 나쁘다.
직접 재 보기 B
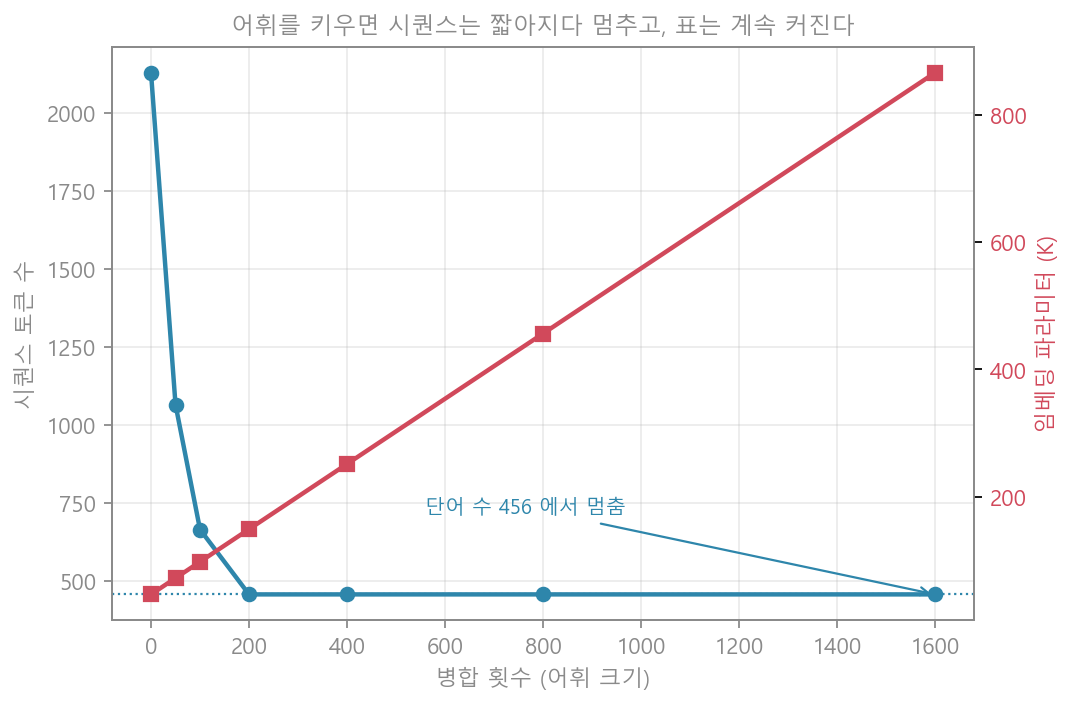
| 병합 | 0 | 100 | 200 | 800 | 1600 |
|---|---|---|---|---|---|
| 시퀀스 토큰 수 | 2,128 | 664 | 456 | 456 | 456 |
| 임베딩 파라미터 | 47K | 98K | 149K | 456K | 866K |
시퀀스는 200병합에서 456(=단어 수)에 닿고 멈춘다. BPE 는 단어 경계를 넘지 않기 때문이다 — 아무리 어휘를 키워도 토큰 수는 단어 수 밑으로 못 내려간다. 그런데 임베딩 표는 그 뒤로도 계속 커진다(149K → 866K). 그러니 “무조건 큰 어휘”는 낭비다. 시퀀스가 충분히 짧아지는 지점 근처에서 멈춰야 한다 — 실제 큰 모델이 어휘를 보통 3만~10만 사이에서 고르는 이유다.
3. 한국어 — 바이트로 자르면 길어진다
요즘은 어떤 언어든 처리하려고 글자 대신 UTF-8 바이트에서 BPE 를 시작하는 경우가 많다. 그런데 여기서 한글이 불리해진다. 영어 글자는 1바이트, 한글 한 글자는 3바이트이기 때문이다.
직접 재 보기 C
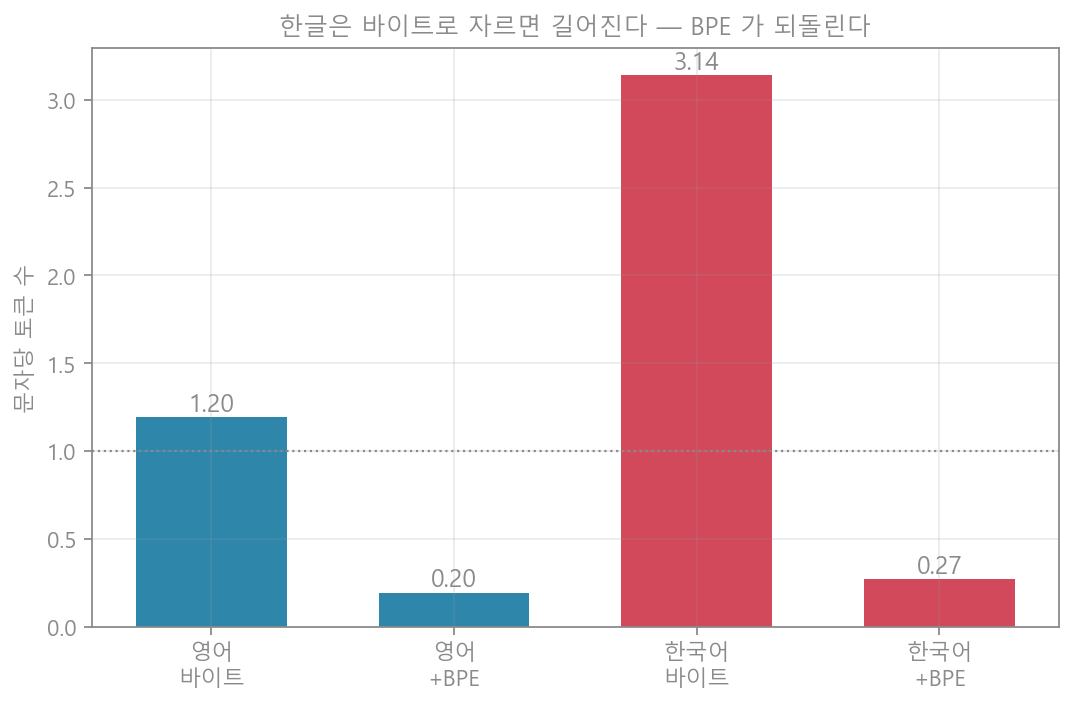
같은 내용을 문자당 몇 토큰으로 자르는지 쟀다.
| 영어 | 한국어 | |
|---|---|---|
| 바이트로 자름 | 1.20 | 3.14 |
| 바이트 + BPE | 0.20 | 0.27 |
바이트로만 자르면 한국어는 문자당 3.14토큰으로 영어(1.20)의 2.6배다. 같은 글을 써도 토큰이 2.6배 — 문맥 길이도, 계산도, API 요금도 그만큼 더 든다. 다행히 BPE 가 한글 조각(자주 쓰는 바이트 묶음)을 배워 0.27까지 되돌렸다. 이것이 한국어 서비스에 좋은 토크나이저가 중요한 이유다 — 토크나이저가 한글을 얼마나 잘 압축하느냐가 곧 비용이다.
4. 임베딩 — 토큰을 벡터로
토큰은 아직 정수 id(예: “학습” = 42)일 뿐이다. 모델이 쓰려면 벡터여야 한다. 임베딩은 그 변환이다 — 짜리 학습되는 표에서 id 에 해당하는 줄을 꺼낸다.
| 기호 | 뜻 |
|---|---|
| 임베딩 표 ( 행, 각 행이 차원 벡터) | |
| 토큰 id | |
| id 만 1인 원-핫 벡터 |
즉 “표에서 꺼내기(lookup)“는 원-핫 벡터와 표의 행렬 곱과 정확히 같다. 조회는 그 곱의 지름길일 뿐이다.
직접 재 보기 D
nn.Embedding 의 조회와 원-핫 곱을 직접 대조했다.
최대 오차 0.0 — 같은 연산이다. 이 표 는 학습으로 갱신되며, 학습이 끝나면 비슷한 뜻의 토큰이 가까운 벡터에 놓인다. 여기에 위치 인코딩 편의 위치 인코딩이 더해져야 비로소 “몇 번째 토큰인지”까지 담긴다.
5. 정리
| 단계 | 하는 일 | 핵심 |
|---|---|---|
| BPE | 글자 → 서브워드 토큰 | 자주 붙는 쌍부터 합쳐 흔한 건 통째로, 드문 건 조각으로 |
| 어휘 크기 | 시퀀스 길이 ↔ 표 크기 저울질 | 시퀀스는 단어 수에서 멈추고 표는 계속 커진다 |
| 바이트 BPE | 다국어 처리 | 한글은 3바이트라 압축이 특히 중요 |
| 임베딩 | 토큰 id → 벡터 | 원-핫 × 학습되는 표 (조회는 그 지름길) |
한 문단으로: 모델은 숫자만 먹으니 텍스트를 토큰으로 자르고 벡터로 바꿔야 한다. 글자는 시퀀스가 너무 길고 단어는 어휘가 폭발하므로, BPE 가 자주 붙는 쌍부터 합쳐 그 사이를 잡는다(재 보니 한국어 2,128 → 456토큰, 78.6% 압축, “학습”·“토큰” 같은 단위가 저절로 생김). 어휘를 키우면 시퀀스는 단어 수에서 멈추는데(BPE 는 단어 경계를 안 넘는다) 임베딩 표는 계속 커지니 저울질이 필요하다. 한글은 UTF-8 3바이트라 바이트로 자르면 영어의 2.6배로 길어지고, 좋은 토크나이저가 이를 0.27토큰/문자까지 되돌린다 — 한국어 비용의 핵심이다. 마지막으로 임베딩은 토큰 id 를 학습되는 표에서 꺼내는 것으로, 원-핫 행렬 곱과 오차 0 으로 같다. 여기까지가 텍스트가 트랜스포머에 들어가기 직전의 모습이다.