인지야공/수학·공학 노트/3번째 글
정규분포 다루기 — 잡음의 덧셈과 재매개변수화
실행:
python 딥러닝/mathnotes/M7_gaussian.py확산 모델 편의 바탕이다.
1. 정규분포끼리 더하면 — 분산이 더해진다
정규분포 두 개를 독립으로 뽑아 더하면, 결과도 정규분포다. 이때 더해지는 것은 표준편차가 아니라 분산이다.
표준편차로 보면 피타고라스 정리와 같은 모양이 된다(). 실제로 재 봤다.
| 더한 두 잡음 | sd 1 + sd 1 | sd 0.5 + sd 2 | sd 3 + sd 4 | sd 0.1 + sd 0.02 |
|---|---|---|---|---|
| 실측 표준편차 | 1.4151 | 2.0607 | 5.0002 | 0.1020 |
| 1.4142 | 2.0616 | 5.0000 | 0.1020 |
3과 4를 더했더니 7이 아니라 5다. 작은 잡음은 큰 잡음 옆에서 거의 사라진다(0.1과 0.02를 더해도 0.102).
2. 그래서 확산의 닫힌 형식이 나온다
확산 모델은 데이터에 잡음을 T번 조금씩 더한다. 한 걸음은 이렇다.
두 걸음을 이어 붙이면, 잡음 항 두 개가 1절의 규칙으로 하나로 합쳐진다.
번 반복해도 마찬가지라, 하나면 아무 시점이나 단번에 만들 수 있다.
| 기호 | 뜻 |
|---|---|
| 단계에서 원래 신호를 남기는 비율() | |
| 들의 누적곱. 까지 남은 신호의 비율 | |
| 표준 정규 잡음 |
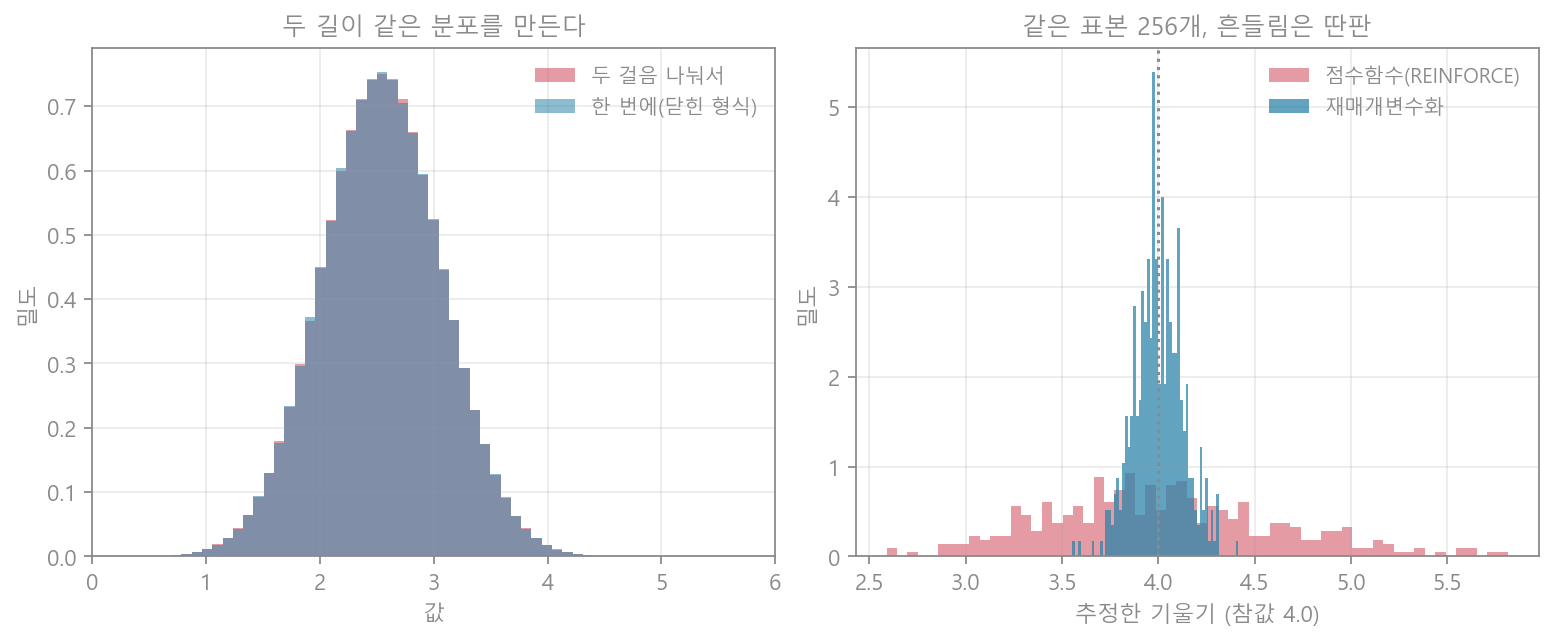
로 두 길을 200만 번씩 비교했다.
| 평균 | 표준편차 | |
|---|---|---|
| 두 걸음 나눠서 | 2.5455 | 0.5290 |
| 한 번에(닫힌 형식) | 2.5455 | 0.5290 |
소수점 넷째 자리까지 같다. 이 한 줄 덕분에 확산 모델 학습이 실용적이 된다 — 학습할 때 를 아무거나 뽑아 그 시점의 잡음 낀 데이터를 즉시 만들 수 있고, 400단계를 순서대로 밟을 필요가 없다.
3. 재매개변수화 — 난수를 밖에서 뽑는다
문제가 하나 있다. “난수를 뽑는 일”에는 미분이 안 흐른다. 에서 를 학습하려면 어떻게 해야 할까. 답은 난수를 밖에서 뽑아 식에 넣는 것이다.
오른쪽 식에서 은 그냥 상수처럼 주어진 숫자고, 와 는 평범한 곱셈·덧셈으로 들어간다. 그래서 역전파가 그대로 흐른다. 이것이 재매개변수화(reparameterization)다.
대안도 있다 — 확률을 직접 미분하는 점수함수 추정기(REINFORCE, RLHF와 DPO 편 RLHF에서 정책 경사가 쓰는 방식)다. 둘 다 평균적으로는 맞는 값을 주지만, 흔들림이 다르다. (참값 )를 400번씩 추정해 봤다.
| 표본 수 | 16 | 256 | 4096 |
|---|---|---|---|
| 재매개변수화 (평균 / 표준편차) | 3.975 / 0.502 | 3.995 / 0.130 | 3.997 / 0.032 |
| 점수함수 (평균 / 표준편차) | 3.990 / 2.298 | 3.973 / 0.563 | 4.009 / 0.148 |
| 분산 비 | 21.0배 | 18.7배 | 21.7배 |
둘 다 평균은 4.0 근처로 맞지만, 점수함수 쪽이 21배 더 흔들린다. 같은 정확도를 얻으려면 표본이 21배 필요하다는 뜻이다. VAE와 확산 모델이 재매개변수화를 쓰는 이유이고, 거꾸로 미분 불가능한 것(이산 토큰 뽑기 등)을 다룰 때는 어쩔 수 없이 점수함수 쪽을 쓰며 분산 줄이기(기준선 빼기 등)에 공을 들이는 이유다.
4. 한 줄 요약
정규분포는 더할 때 분산이 더해져(3+4=5) 번의 잡음을 한 번에 계산하게 해 주고, 재매개변수화는 난수를 밖에서 뽑아 넣어 기울기가 흐르게 하면서 흔들림을 21배 줄여 준다. 확산 모델의 학습식과 VAE가 모두 이 두 줄 위에 서 있다.