인지야공/수학·공학 노트/11번째 글
가우시안 메커니즘 — 프라이버시를 사는 값
실행:
python 딥러닝/mathnotes/M17_dp_gaussian.py차등 프라이버시 편에서 노이즈를 키우면 이 줄던 그 관계를 기초부터 정리한다.
1. 민감도 — 노이즈의 단위
차등 프라이버시의 출발점은 “한 사람이 바뀌면 답이 최대 얼마나 바뀌는가”다. 그것을 민감도라 한다.
| 기호 | 뜻 |
|---|---|
| 이웃 데이터셋 — 딱 한 사람만 다른 두 데이터 | |
| 민감도. 한 사람이 바꿀 수 있는 답의 최대 변화 | |
| 답에 더할 가우시안 노이즈의 크기 | |
| 프라이버시 예산. 작을수록 안전 | |
| 그 보장이 깨질 아주 작은 확률 (여기서는 ) |
같은 데이터라도 무엇을 묻느냐에 따라 사야 할 노이즈가 달라진다. 사람 1000명의 나이(20~69)를 두고 세 가지를 물으면:
| 질문 | 민감도 |
|---|---|
| “몇 명인가” | 1 |
| “나이의 합은” | 49 (= 69 − 20) |
| “평균 나이는” | 0.049 (= 49 / 1000) |
평균은 으로 나뉘므로 사람이 많을수록 싸다. 차등 프라이버시가 큰 데이터에서 쉽고 작은 데이터에서 어려운 이유가 이 한 줄이다.
2. 직접 재 보기
ε는 ‘구분 가능성’이다
정의만 보면 추상적이지만, 실제로 두 세계를 만들어 보면 간단하다. 민감도 1짜리 질문에서 참 답이 0인 세계와 1인 세계를 놓고, 각각 노이즈를 섞어 40만 번씩 공개했다. 공격자는 관측값 하나를 보고 어느 세계인지 맞힌다.
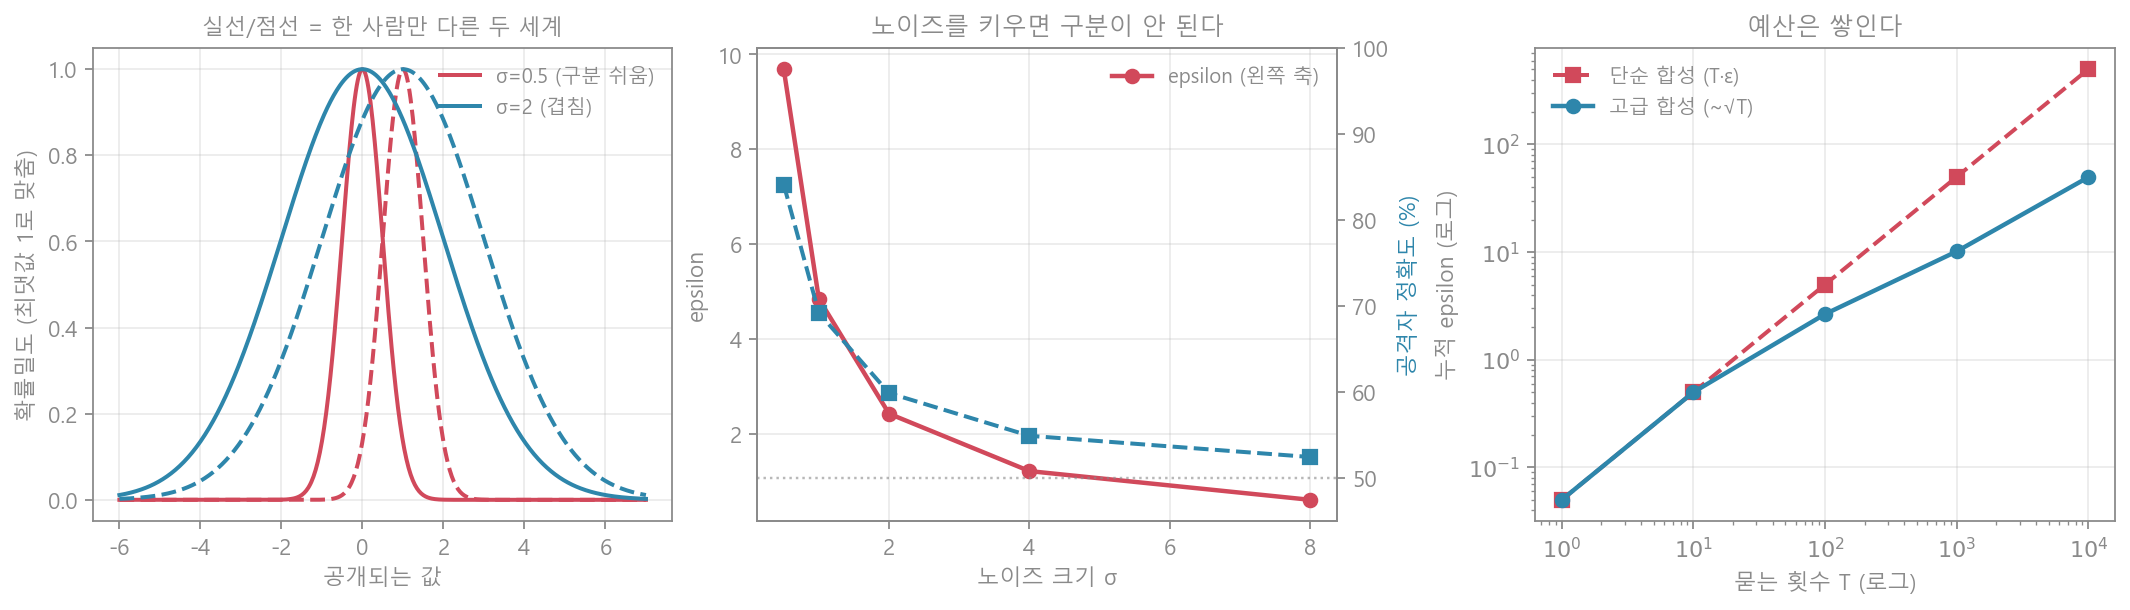
| 노이즈 | 이론 | 공격자 정확도 |
|---|---|---|
| 0.5 | 9.69 | 84.1% |
| 1.0 | 4.84 | 69.2% |
| 2.0 | 2.42 | 59.9% |
| 4.0 | 1.21 | 54.9% |
| 8.0 | 0.61 | 52.5% |
를 16배 키우니 공격자가 84.1%에서 52.5% — 거의 찍기(50%)로 내려왔다. 그리고 은 9.69에서 0.61로, 정확히 에 반비례해 줄었다.
이 무엇인지에 대한 가장 쓸 만한 직관이 이것이다. “내가 이 데이터에 있었는지 없었는지를 남이 얼마나 알아낼 수 있는가”의 상한. 이면 두 세계가 완전히 같아 아무것도 알 수 없고, 크면 구분이 쉬워진다.
예산은 쌓인다
한 번 물을 때마다 조금씩 새어 나가므로, 여러 번 물으면 누적된다. 한 번에 를 쓴다고 하자.
| 묻는 횟수 | 단순 합성 | 고급 합성 | 절약 |
|---|---|---|---|
| 100 | 5.0 | 2.7 | 1.9배 |
| 1,000 | 50.0 | 10.2 | 4.9배 |
| 10,000 | 500.0 | 49.6 | 10.1배 |
단순 합성은 에 비례한다. 1만 번이면 으로, 아무 보호도 아니다. 고급 합성은 대략 로 자라 훨씬 낫다.
직관은 간단하다. 매번 같은 방향으로 새는 게 아니라 노이즈가 서로 상쇄되므로, 손실이 가 아니라 로 쌓인다. 표본 오차에서 이 나온 것과 같은 이유다.
3. 왜 중요한가
- 차등 프라이버시 편이 T=600 스텝을 돌리고도 쓸 만한 을 얻은 것이 이 계산 덕분이다. 단순 합성이었다면 600스텝만으로 예산이 바닥났다. 학습은 같은 데이터를 수백~수천 번 보는 일이라, DP-SGD에서는 합성이 곧 전부다.
- 단독으로는 뜻이 없다. 항상 “몇 번 물었을 때”와 함께 읽어야 한다. 논문에서 같은 값이 나오는 것은 수천 스텝을 합성한 결과라서다.
- 민감도를 줄이는 것이 노이즈를 줄이는 것보다 낫다. 차등 프라이버시 편에서 그래디언트를 클리핑한 것이 바로 민감도를 인위적으로 로 묶은 것이다. 를 반으로 줄이면 같은 에 노이즈도 반이다.
- 작은 데이터에서는 어렵다. 평균의 민감도가 이므로, 이 작으면 답 자체가 노이즈에 묻힌다. “프라이버시를 지키면서 소수 집단을 분석하기”가 본질적으로 어려운 이유이고, 긴 꼬리 편와 정면으로 부딪히는 지점이다.
4. 한 줄 요약
은 한 사람이 바뀐 두 세계를 공격자가 얼마나 구분할 수 있는가의 상한이다. 노이즈 를 0.5에서 8로 키우자 공격자 정확도가 84.1%에서 52.5%(찍기는 50%)로, 은 9.69에서 0.61로 반비례해 줄었다. 사야 할 노이즈의 단위는 민감도 — 한 사람이 답을 바꿀 수 있는 최대치이고, 평균처럼 으로 나뉘는 질문은 싸다. 그리고 예산은 쌓인다. 1만 번 물으면 단순 합성으로는 이지만 고급 합성으로는 49.6 이다.
연결
- 차등 프라이버시 · 정규분포 다루기 · 표본 오차 · 엔트로피와 KL 발산