인지야공/딥러닝 기초 정리/30번째 글
잠재 반복 vs 토큰 사슬 — 추가 계산을 세로로 넣을 것인가 가로로 넣을 것인가
실행:
python 07_latent_vs_token.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 앞 글(루프 트랜스포머)을 먼저 읽으면 좋다.⚠ 이 글의 3장 결론(“정확도로는 두 방식을 구분할 수 없다”)은 뒤에 뒤집혔다. 여기서 쓴 과제가 분리를 볼 수 없게 만들어져 있었다 — 노드마다 나가는 화살표가 하나라 BFS 전선이 언제나 폭 1이었고, 토큰 사슬 쪽에는 집합 채널을 쥐여 줬다. 고쳐 다시 잰 것이 중첩이다.
루프 트랜스포머 편의 결론은 “깊이를 파라미터가 아니라 시간으로 살 수 있다” 였다. 그런데 시간으로 사는 방법이 하나가 아니다. 추가 계산을 어느 방향으로 넣느냐에 따라 둘로 갈린다.
(A)는 같은 블록을 잠재공간에서 더 돌린다. 토큰은 한 개도 안 나온다. (B)는 한 단계 결과를 토큰으로 뱉고 그 토큰을 다시 읽어 다음 단계를 한다 — 생각의 사슬(CoT)이다.
보도된 바로는 GPT-6 아스트라가 (A) 쪽, Claude 페이블 5.1 이 (B) 쪽이다. 다만 어느 회사도 구조를 확인해 준 적이 없다. 그러니 이 글은 두 모델 해설이 아니라, 두 방향을 축소 모형으로 맞대 보고 그 지문이 공개 수치에 남는지 보는 글이다.
1. 무엇을 재야 공정한가
“어느 쪽이 낫나”를 재려면 나머지를 전부 같게 맞춰야 한다. 그래서 이렇게 고정했다.
| 고정한 것 | 값 |
|---|---|
| 과제 | 루프 트랜스포머 편과 같은 그래프 도달 가능성, 노드 16개 |
| 블록 | 완전히 같은 부품 (Pre-LN, , 헤드 4개) |
| 단계 수 | 양쪽 다 번 |
다른 것은 단 하나, 단계 사이에 무엇을 넘기느냐뿐이다.
이 병목이 공짜인지 아닌지가 이 실험의 전부다.
파라미터
| 파라미터 | 한 단계에 무엇을 보나 | |
|---|---|---|
| (A) 잠재 반복 | 60,546 | 16칸 (그래프) |
| (B) 토큰 사슬 · 1블록 | 52,546 | 32칸 (그래프 16 + 상태 16) |
| (B) 토큰 사슬 · 2블록 | 102,530 | 32칸 |
(A)가 (B) 1블록보다 8K 많은 것은 매 바퀴 입력을 다시 섞어 넣는 때문이다(루프 트랜스포머 편의 input injection). (B)는 상태를 입력 토큰 칸으로 받으므로 그 자리가 따로 필요 없는 대신 문맥이 2배로 길어진다.
학습
두 방식은 배우는 것이 다르다.
- (A) 는 루프 트랜스포머 편과 같다. 매 바퀴 출력을 최종 정답으로 감독하되, 아직 바퀴를 못 돈 시점은 뺀다. 중간 정답은 안 알려준다.
- (B) 는 한 홉만 가르친다. . 시험할 때는 자기가 뱉은 토큰을 다시 먹으며 스스로 굴러간다(롤아웃).
홉(hop) 은 화살표 하나를 건너는 것이다(네트워크에서 라우터 하나를 거치는 그 홉). 그러니 “홉 집합”은 0번에서 화살표를 번 이하로 따라가 닿는 노드들이고, 위 줄은 “번 만에 닿는 곳들을 줄 테니 번 만에 닿는 곳들을 내놔라” 는 뜻이다. 최종 답을 통째로 가르치지 않고 딱 한 칸 전진하는 것만 가르쳤다. 자세한 정의와 예제는 루프 트랜스포머 편 3장에 있다.
(B)의 학습·시험 방식이 곧 teacher forcing 으로 배우고 자기 출력으로 달리는 실제 LM 의 모습이다. 그리고 이 어긋남이 다음 장의 결과를 만든다.
2. 결과 1 — 토큰으로 눌러 넘기는 값
먼저 (B)에게 한 단계만 시켜 봤다. 딱 한 홉만 퍼뜨리면 된다. 쉬운 일이다.
| (B) 토큰 사슬 | 칸 단위 정확도 | 16칸 전부 맞힘 | 12단계 롤아웃 |
|---|---|---|---|
| 1블록 | 97.64% | 62.31% | 0.0% |
| 2블록 | 100.00% | 100.00% | 100.0% |
1블록은 한 단계만 보면 97.6% 로 그럴듯한데, 굴리면 0% 가 된다.
이유는 곱셈이다. 16칸을 전부 맞힐 확률이 0.623 이면, 12단계를 연달아 다 맞힐 확률은
이고 실제로 0% 로 나온다. 게다가 되돌릴 방법이 없다. 중간 상태가 이미 argmax 로
확정돼 토큰이 되어 나갔으니, 다음 단계는 그 틀린 값을 사실로 알고 시작한다.
“아까 그거 좀 애매했는데” 같은 정보가 넘어가지 않는다 — 16비트에는 그게 안 들어간다.
(A)에는 이 문제가 없다. 애매한 칸은 애매한 채로, 0.5 근처의 실수로 다음 바퀴에 넘어간다. 뒤 바퀴가 다른 칸의 정보를 받아 거기서 고칠 수 있다.
2블록을 주면 한 단계가 100% 가 되고 12단계도 100% 가 된다. 즉 토큰으로 눌러 넘기는 대가는 “단계마다 계산을 더 해서 상태를 되살리는 것”으로 치를 수 있다. 공짜는 아니지만 못 살 것도 아니다. 아래부터는 공정하게 2블록을 (B)의 대표로 쓴다.
3. 결과 2 — 같은 답, 다른 청구서
반경 12 문제를 주고 단계 수 을 1부터 14까지 늘려 가며 재 봤다.
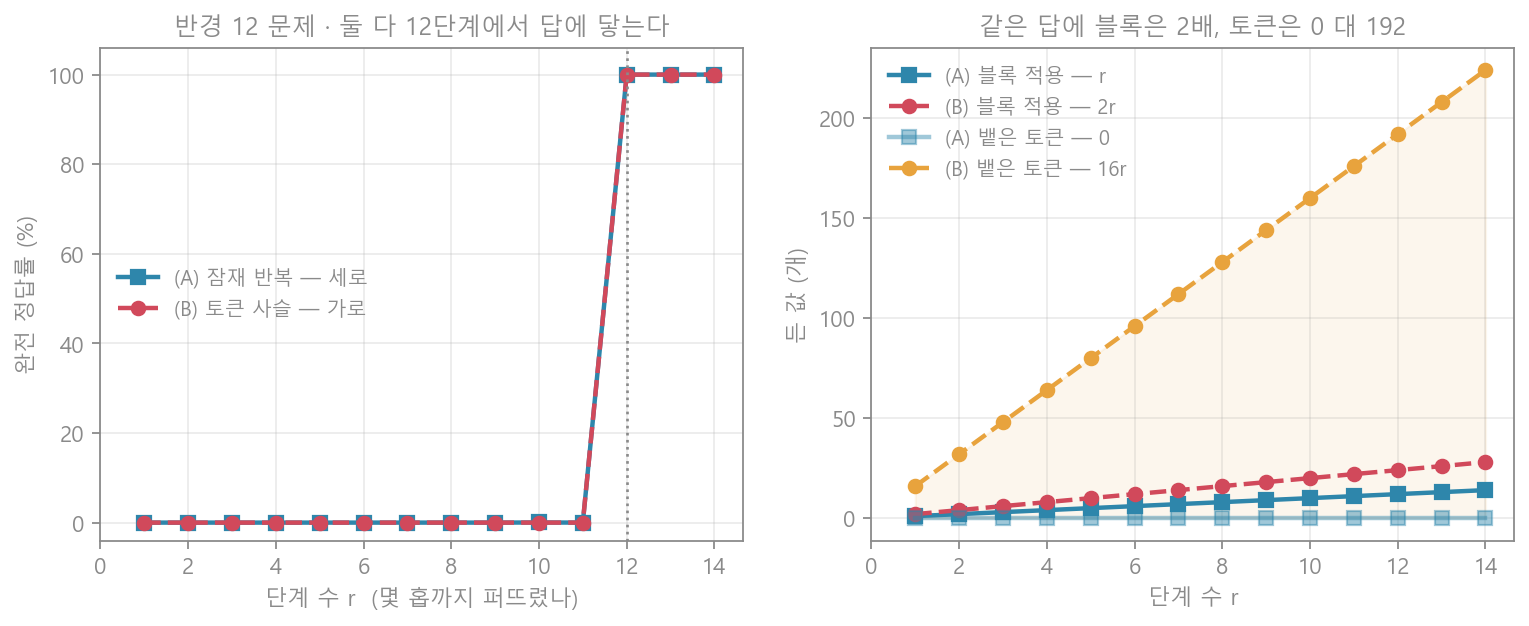
| 1–9 | 10 | 11 | 12 | 13 | 14 | |
|---|---|---|---|---|---|---|
| (A) 잠재 반복 | 0% | 0.02% | 0% | 100% | 100% | 100% |
| (B) 토큰 사슬 | 0% | 0% | 0% | 100% | 100% | 100% |
둘 다 정확히 12단계에서 100% 로 뛴다. 그 전에는 둘 다 0% 다 — 12홉을 퍼뜨려야 답이 완성되는 문제이니 원리적으로 당연하다. 반경을 바꿔 가며 봐도 같다.
| 도달 반경 | 2 | 4 | 8 | 12 |
|---|---|---|---|---|
| (A) 잠재 반복 (14바퀴) | 99.98% | 100% | 100% | 100% |
| (B) 토큰 사슬 (14단계) | 100% | 100% | 100% | 100% |
정확도로는 두 방식을 구분할 수 없다. 같은 블록으로 같은 절차를 밟으니 당연하다. 갈리는 것은 값이다. 에서 청구서를 뽑으면,
⚠ 중첩 편에서 뒤집힘 (2026-09-12) — 이 굵은 문장이 틀렸다. 정확히 말하면 “이 과제에서는 구분할 수 없다”까지만 맞다.
이론(Zhu et al.)은 바로 이 과제에서 연속 사고가 단계, 이산 CoT 가 단계라고 증명한다. 차이가 0으로 나온 것은 내 과제가 분리를 볼 수 없게 만들어져 있었기 때문이다 — 노드마다 나가는 화살표가 하나라 BFS 전선이 언제나 폭 1이었고(겹쳐 들 것이 없다), 그 위에 (B)에게 집합 채널을 쥐여 줬다.
분기를 넣고 다시 재니 갈렸다. 반경을 4로 고정했는데도 (B-경로)만 8 → 12 → 16 → 20 단계로 밀리고 천장이 97.6% → 73.4% 로 내려앉는다. → 중첩
| (A) 잠재 반복 | (B) 토큰 사슬 | ||
|---|---|---|---|
| 블록 적용 | 12 번 | 24 번 | 2배 |
| 칸 × 블록 | 192 | 768 | 4배 (문맥이 2배 길어서) |
| 뱉은 토큰 | 0 개 | 192 개 | — |
블록이 2배인 것은 (B)에 2블록을 줬기 때문이고, 칸×블록이 4배인 것은 거기에 상태를 입력 칸으로 받느라 문맥이 2배가 곱해져서다. 그리고 마지막 줄 —
출력 토큰은 실제 API 에서 입력 토큰의 5배 값이다. (아스트라·페이블 둘 다 100만 토큰당 입력 $10 / 출력 $50) 그러니 마지막 줄이 곧 청구서다. 같은 답을 같은 단계에 내면서, 한쪽은 출력 토큰을 한 개도 안 쓴다.
4. 결과 3 — 중간 생각을 읽을 수 있는가
여기가 진짜 차이다. (B)는 읽을 것도 없다 — 중간 상태가 이미 토큰으로 밖에 나와 있다. (A)는 64차원 벡터뿐이다. 거기에 “홉 집합”이 들어 있는지 선형 프로브로 캐 봤다. 프로브는 행렬 하나 곱해 맞히기다. 선형으로 읽히면 정보가 또렷이 들어 있다는 뜻이다.
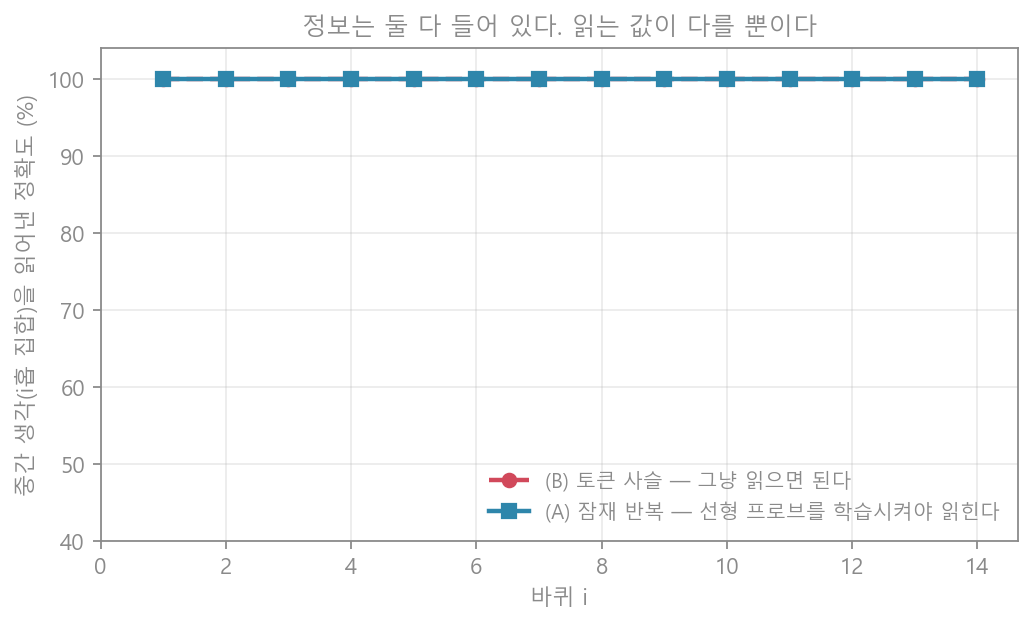
| 바퀴 | 1 | 2 | 4 | 6 | 8 | 10 | 12 | 14 |
|---|---|---|---|---|---|---|---|---|
| (A) 프로브로 읽은 홉 집합 | 100% | 100% | 100% | 100% | 100% | 100% | 100% | 100% |
| (B) 토큰을 그냥 읽기 | 100% | 100% | 100% | 100% | 100% | 100% | 100% | 100% |
정보는 둘 다 완벽하게 들어 있다. (A)의 잠재 상태 에는 “홉 이내에 닿는 노드 집합”이 선형으로 읽힐 만큼 또렷이 박혀 있다. 숨긴 것이 아니다.
그런데 이 표가 말하지 않는 것이 있다. 저 100% 를 얻으려면 무엇이 필요했는가.
①이 급소다. 예상하지 못한 생각은 프로브도 못 잡는다 — 찾을 것을 모르니 ②의 라벨을 만들 수가 없다. 모델이 “사용자를 어떻게 다룰까”를 생각하고 있는지 보려면 그 라벨을 먼저 만들어야 하는데, 그러려면 그걸 생각하고 있다는 걸 이미 알아야 한다.
(B)는 그냥 읽으면 된다. 무엇을 찾을지 몰라도 읽힌다.
“정보가 있다”와 “읽을 수 있다”는 다르다. 잠재 추론이 닫는 것은 정보가 아니라 창문이다.
5. 실제 두 모델의 지문
축소 모형이 예측하는 것은 명확하다. 세로로 넣은 쪽은 토큰을 적게 쓰고 한 토큰이 무겁다. 가로로 넣은 쪽은 토큰이 가볍고 많이 쓴다. 공개 수치가 그 모양인지 본다.
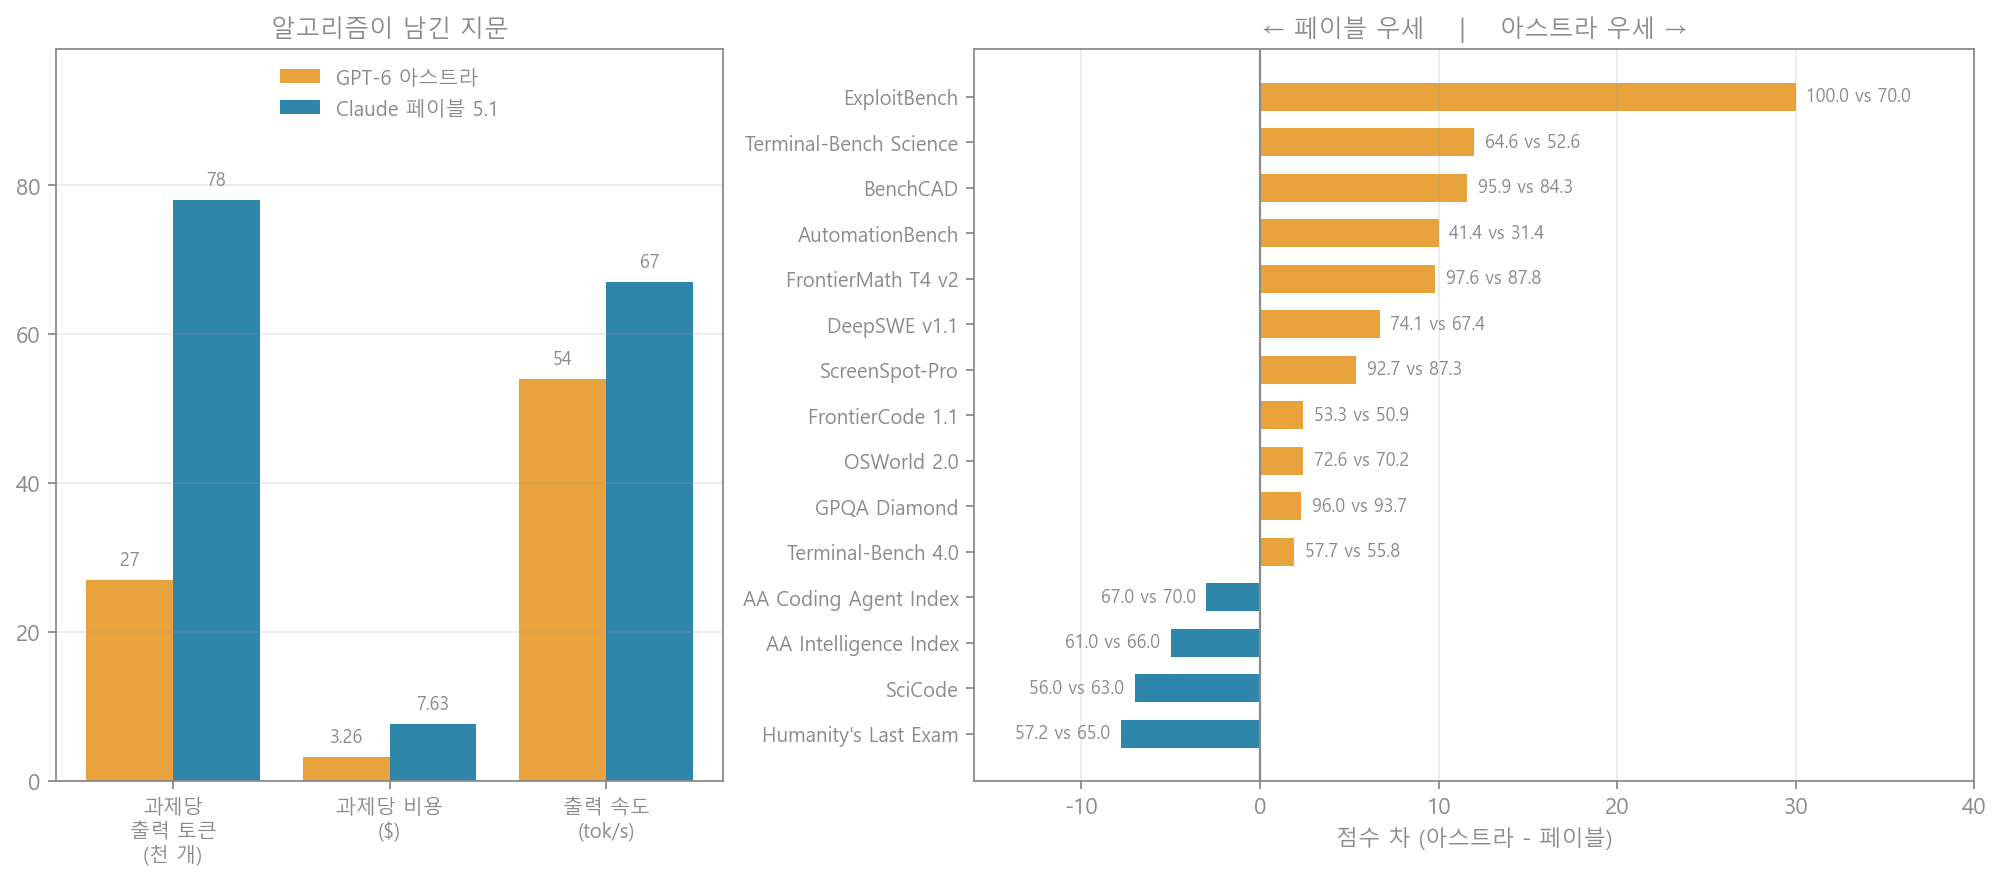
| GPT-6 아스트라 | Claude 페이블 5.1 | ||
|---|---|---|---|
| 과제당 출력 토큰 | 27,000 | 78,000 | 2.9배 |
| 과제당 비용 | $3.26 | $7.63 | 2.3배 |
| 출력 속도 | 54 tok/s | 67 tok/s | ← 반대 방향 |
단가는 똑같다(입력 $10 / 출력 $50 per 1M). 비용 차이는 순수하게 몇 토큰을 썼는가에서만 나온다. 그리고 방향이 정확히 반대다.
토큰을 적게 쓰면서 토큰당 속도까지 빠르면 그냥 효율이 좋은 것이다. 적게 쓰는 대신 느리다는 조합이 “한 토큰 뒤에 계산을 더 쌓았다”는 지문에 가깝다.
벤치마크 분화도 이 축과 맞물린다.
| 아스트라가 앞서는 곳 | 차이 | 페이블이 앞서는 곳 | 차이 |
|---|---|---|---|
| ExploitBench | +30.0 | Humanity’s Last Exam | −7.8 |
| Terminal-Bench Science | +12.0 | SciCode | −7.0 |
| BenchCAD | +11.6 | AA Intelligence Index | −5.0 |
| AutomationBench | +10.0 | AA Coding Agent Index | −3.0 |
| FrontierMath T4 v2 | +9.8 | ||
| DeepSWE v1.1 | +6.7 | ||
| ScreenSpot-Pro | +5.4 |
아스트라는 정답이 딱 떨어지고 긴 탐색이 필요한 쪽(수학, 익스플로잇, 화면 조작)에서 벌고, 페이블은 넓게 알고 길게 끌고 가는 쪽에서 앞선다. 다만 —
여기서부터는 해석이다. 벤치마크 점수 차이는 구조 말고도 학습 데이터, RL 레시피, 하네스 설정에서 전부 나온다. 위 표는 “구조가 이렇게 만들었다”의 증거가 아니라 “구조 가설과 모순되지 않는다” 정도로만 읽어야 한다. (수치 출처: Artificial Analysis · DataCamp 정리 기준. 설정에 따라 달라진다.)
6. 그래서 무엇과 무엇을 맞바꾸는가
| (A) 잠재 반복 — 세로 | (B) 토큰 사슬 — 가로 | |
|---|---|---|
| 단계 사이에 넘기는 것 | 1024개 실수 | 16비트 |
| 오차 복구 | 뒤 바퀴가 고칠 수 있다 | 불가능 (argmax 로 확정) |
| 단계당 계산 | 블록 1개면 된다 | 더 필요 (상태 되살리기) |
| 문맥 길이 | 안 늘어난다 | 단계마다 늘어난다 |
| 출력 토큰 | 0 | 단계 × 길이 |
| 중간 생각 읽기 | 프로브를 학습시켜야 | 그냥 읽으면 된다 |
| 예상 못 한 생각 | 안 보인다 | 보인다 |
| 학습 데이터 | 중간 정답 필요 없음 | 단계별 감독이 있으면 쉬움 |
한 줄로 줄이면 이렇다.
(A)는 대역폭을 사고 관측 가능성을 판다. (B)는 관측 가능성을 사고 토큰으로 값을 치른다.
⚠ 중첩 편에서 고침 (2026-09-12) — 위 표 첫 줄(“1024개 실수 대 16비트”)을 나는 정밀도 차이로 읽었다. 실제로 작동한 것은 폭이었다.
중첩 편에서 (B)에게 24비트 집합 채널을 준 쪽은 잠재 반복과 완전히 똑같이 4단계·100%를 냈다. 이산인데도 그렇다. 갈린 것은 연속이냐 이산이냐가 아니라 채널이 집합을 한 번에 담을 수 있느냐였다. 연속 상태가 이기는 이유는 실수여서가 아니라 넓어서다.
그러니 “대역폭을 산다”는 요약은 방향이 맞았는데, 그 대역폭이 비트 정밀도가 아니라 동시에 담는 원소 수라는 것을 나는 그때 몰랐다.
축소 모형의 한계
정직하게 적어 둔다.
- 과제가 너무 착하다. 도달 가능성은 한 홉이 한 단계로 딱 떨어지고 답이 고정점이다. 실제 추론은 단계 구분이 이렇게 깔끔하지 않다. → 중첩 편 주석: 생각보다 훨씬 심각했다. 나가는 화살표가 하나뿐이라 BFS 전선이 늘 폭 1 이었고, 그래서 이 과제는 중첩에 대해 아무것도 말할 수 없는 과제였다.
- (B)의 토큰이 너무 좋다. 16비트가 상태를 정확히 표현한다. 자연어 CoT 는 중간 생각을 옮겨 적는 과정에서 손실이 더 크다 — 그래서 실제로는 (B)가 더 불리하다. → 중첩 편 주석: 이 항목은 내가 쓸 때 생각한 것보다 더 맞았다. 문제는 손실이 아니라 16비트가 집합이라는 것이었다. 이론이 말하는 이산 CoT 의 약점을 내가 손으로 없애 준 셈이다.
- 규모가 6만 파라미터다. 큰 모델에서 어느 쪽이 먼저 무너지는지는 여기서 못 본다.
- 읽을 수 있다 ≠ 진짜 생각이다. (B)의 테이프가 읽히는 것과, 그게 모델이 실제로 쓴 근거인지는 별개다. CoT 충실성(faithfulness) 은 따로 재야 하는 문제다.
7. 한 문단 요약
추가 계산을 세로(같은 블록을 잠재공간에서 더)로 넣든 가로(토큰으로 뱉고 다시 읽기)로 넣든, 같은 블록·같은 단계 수라면 정확도는 똑같았다 — 반경 12 문제를 둘 다 정확히 12단계에서 100% 로 풀었다. 갈린 것은 값이다. 가로 쪽은 상태를 16비트로 눌러 넘기느라 단계마다 계산을 더 사야 했고(1블록으로는 12단계 롤아웃이 0% 로 무너졌다), 같은 답에 출력 토큰 192개를 썼다 — 세로 쪽은 0개다. 대신 가로 쪽의 중간 생각은 그냥 읽으면 됐고, 세로 쪽은 정보가 100% 들어 있는데도 무엇을 찾을지 미리 알고 프로브를 학습시켜야 읽혔다. 공개 수치에서 아스트라는 토큰을 2.9배 적게 쓰면서 토큰당 속도는 오히려 느리고, 페이블은 반대다. 구조가 남기는 지문의 모양이 그렇다.
⚠ 중첩 편에서 뒤집힘 (2026-09-12) — 이 문단의 “정확도는 똑같았다”는 이 과제에서만 참이다. 분기가 있는 그래프에서 다시 재면 이산 CoT 쪽만 단계가 밀리고 천장이 내려앉는다. 아래 고친 기록을 보라.
고친 기록
이 연재는 틀린 것을 지우지 않고 고친 자리를 표시해 둔다. 무엇이 왜 틀렸는지가 결과만큼 값지기 때문이다.
2026-09-12 · 중첩 편에서 세 곳 (3장, 6장, 7장)
| 무엇을 썼나 | 무엇이 맞나 | |
|---|---|---|
| 3장 결론 | 정확도로는 두 방식을 구분할 수 없다 | 이 과제에서만 그렇다. 분기를 넣으면 이산 쪽만 8 → 20 단계로 밀리고 천장이 97.6% → 73.4% 로 내려앉는다 |
| 6장 표 | 1024개 실수 대 16비트 = 정밀도 차이 | 폭 차이다. 24비트 이산 채널도 집합만 담으면 잠재와 똑같이 행동한다 |
| 6장 한계 1·2 | 과제가 착하고 토큰이 좋다 | 방향은 맞았는데 정도를 몰랐다. 전선 폭이 늘 1이라 애초에 잴 수 없는 과제였다 |
교훈 — “차이가 없다”는 결론은 “차이를 만들 수 있는 조건이 있었는가”를 확인한 뒤에만 쓸 수 있다.
나는 두 방식을 같은 조건에 놓았다고 믿었다. 실제로는 차이가 나타날 자리 자체를 없앤 조건이었다. 이런 실험에서 음성 결과(차이 없음)는 양성 결과보다 훨씬 조심해야 한다 — 측정이 잘 된 것과 측정할 것이 없었던 것이 똑같이 0으로 보이기 때문이다.
구체적으로 빠뜨린 절차는 이것이다. 이론이 이득의 출처라고 말하는 양을 먼저 재 본다.
여기서는 “겹쳐 들 전선의 폭”이었고, 그걸 찍어 봤으면 평균 1.00, 최대 1 이 나와 실험을
시작하기 전에 설계를 고쳤을 것이다.
5장의 공개 수치(아스트라 27K vs 페이블 78K 토큰)와 4장의 프로브 관측 가능성 논의는 그대로 유효하다. 뒤집힌 것은 3장의 “정확도가 같다”와 6장의 대역폭 해석이다.
참고
- Geiping et al., Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach (arXiv:2502.05171) — (A) 쪽 구조
- Hao et al., Training Large Language Models to Reason in a Continuous Latent Space (Coconut, arXiv:2412.06769) — CoT 를 잠재공간으로 옮기는 다른 갈래
- Wei et al., Chain-of-Thought Prompting Elicits Reasoning in Large Language Models (arXiv:2201.11903) — (B) 쪽의 출발점
- Turpin et al., Language Models Don’t Always Say What They Think (arXiv:2305.04388) — 읽힌다고 충실한 것은 아니다
- Korbak et al., Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety (arXiv:2507.11473) — CoT 를 안전장치로 쓸 때의 전제
- 루프 트랜스포머 — (A) 구조를 따로 재 본 앞 글