인지야공/수학·공학 노트/14번째 글
리틀의 법칙 — 처리량과 지연은 따로 고를 수 없다
실행:
python 딥러닝/mathnotes/M18_littles_law.py추론 서빙 편의 “처리량과 지연의 거래”를 정리한다.
1. L = λW
대기행렬에서 가장 쓸모 있는 한 줄이다.
| 기호 | 뜻 |
|---|---|
| 시스템 안에 평균 몇 개가 들어 있는가 | |
| 도착률 — 초당 몇 개가 들어오는가 | |
| 하나가 시스템에 머무는 평균 시간 (대기 + 처리) |
놀라운 점은 가정이 거의 없다는 것이다. 도착이 어떤 분포든, 처리 순서가 무엇이든, 서버가 몇 대든 성립한다. 시스템이 안정적이기만 하면 된다.
쓸모는 셋 중 둘을 알면 나머지를 안다는 데 있다. 큐에 평균 40개가 쌓여 있고 초당 200개를 처리한다면, 지금 들어온 요청은 평균 초 뒤에 나간다. 스톱워치를 댈 필요가 없다.
2. 직접 재 보기
서버 하나짜리 큐를 20만 건씩 시뮬레이션했다(도착 간격과 처리 시간이 지수분포).
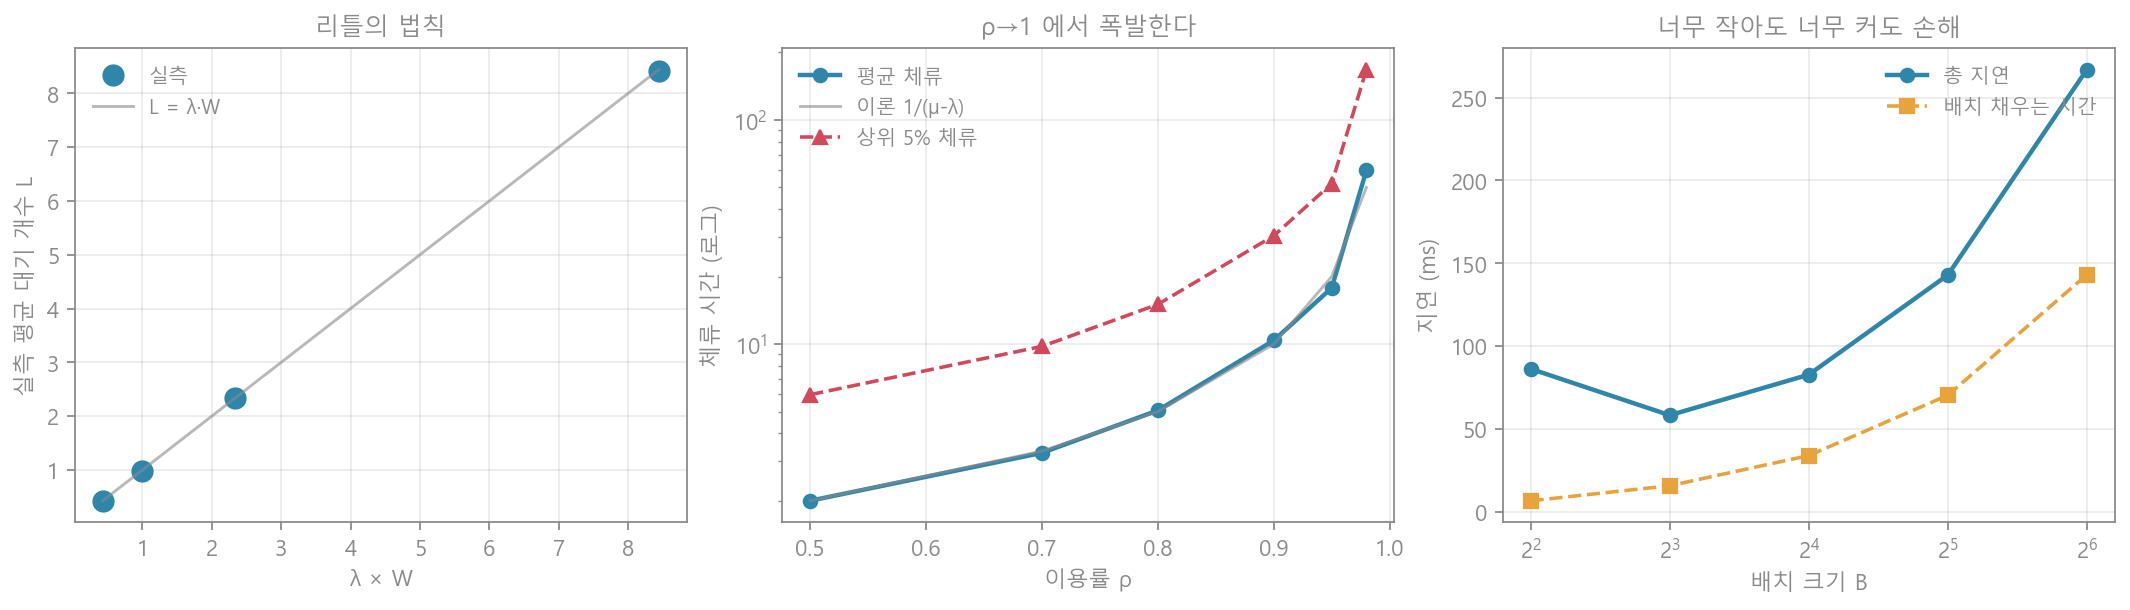
| 도착률 | 실측 | 차이 | |
|---|---|---|---|
| 0.3 | 0.427 | 0.429 | 0.0021 |
| 0.5 | 0.988 | 0.990 | 0.0015 |
| 0.7 | 2.342 | 2.342 | 0.0001 |
| 0.9 | 8.413 | 8.443 | 0.0294 |
소수 둘째 자리까지 같다. 남는 차이는 20만 건이라는 유한한 관측 구간에서 오는 것이고, 가 1에 가까울수록(마지막 줄) 큐가 길어져 수렴이 느리다. 식 자체는 근사가 아니라 항등식이다.
이용률이 1에 가까워지면 폭발한다
서버 능력 대비 도착률의 비 가 이용률이다. 체류 시간은 이렇게 된다.
| 이용률 | 평균 체류 | 이론값 | 상위 5% 체류 | 처리량 |
|---|---|---|---|---|
| 0.50 | 2.00 | 2.00 | 5.95 | 0.502 |
| 0.80 | 5.06 | 5.00 | 15.05 | 0.801 |
| 0.90 | 10.38 | 10.00 | 30.43 | 0.901 |
| 0.95 | 17.80 | 20.00 | 51.99 | 0.948 |
| 0.98 | 59.59 | 50.00 | 167.84 | 0.981 |
를 0.5에서 0.98로 올려 얻은 것은 처리량 0.50 → 0.98 (2배가 채 안 된다). 대신 치른 값은 체류 시간 2.0 → 59.6 (30배)다. 상위 5%는 167.8로 더 나쁘다.
가 원인이다. 가 0.9에서 0.99로 갈 때 이 항은 10에서 100이 된다. 서버를 꽉 채워 쓰는 것이 왜 위험한지가 여기 있다 — 이용률 마지막 몇 %를 짜내려다 지연이 한 자릿수 늘어난다.
배치는 양쪽을 동시에 건드린다
추론 서빙에서 배치를 키우는 것은 GPU를 효율적으로 쓰는 표준 수단이다. 배치 하나를 처리하는 데 고정비 10ms + 요청당 1.2ms가 들고 초당 220개가 들어온다고 하자.
| 배치 | 최대 처리량 | 이용률 | 배치 채우는 시간 | 총 지연 |
|---|---|---|---|---|
| 1 | 89.3/s | 감당 못함 | — | — |
| 2 | 161.3/s | 감당 못함 | — | — |
| 4 | 270.3/s | 0.814 | 6.8ms | 86.4ms |
| 8 | 408.2/s | 0.539 | 15.9ms | 58.4ms |
| 16 | 547.9/s | 0.401 | 34.1ms | 82.9ms |
| 64 | 737.3/s | 0.298 | 143.2ms | 266.9ms |
양쪽 끝이 다 나쁘다. 가 작으면 고정비 10ms를 요청마다 물어 처리량이 도착률을 못 따라가고 큐가 무한히 쌓인다. 가 크면 처리량은 남아도는데 배치가 차기를 기다리는 시간(B=64에서 143ms)이 지연을 지배한다. 여기서는 이 58.4ms로 최소였다.
“배치를 키우면 처리량이 오른다”는 맞다. 다만 그것이 공짜로 오지 않는다는 것이 이 표다.
3. 왜 중요한가
- 추론 서빙 편의 처리량-지연 곡선이 이 산수 위에 있다. LLM 서빙에서 배치 크기, 연속 배칭, 프리필/디코드 분리가 전부 이 세 값(, , )을 어디에 둘지의 문제다.
- SLO를 정할 때 평균이 아니라 꼬리를 봐야 한다. 위 표에서 의 평균은 59.6인데 상위 5%는 167.8이다. “평균 응답시간 60ms”라고 적어 놓고 스무 명 중 한 명에게 168ms를 주고 있는 셈이다.
- 용량 계획의 기본도 같다. 목표 지연이 있으면 의 상한이 정해지고, 거기서 필요한 서버 수가 나온다. 이용률 70~80%를 목표로 잡는 관행이 곡선의 무릎에서 나온 것이다.
- 산술 강도 노트와 짝이다. 루프라인이 “한 번 처리하는 데 얼마나 걸리나”()를 정하고, 리틀의 법칙이 “그래서 줄이 얼마나 길어지나”()를 정한다. 양자화로 를 올리면 같은 에서 가 내려가 지연이 곱절로 좋아진다.
4. 한 줄 요약
는 도착 분포도 처리 순서도 가리지 않고 성립하며, 시뮬레이션에서 소수점까지 맞았다. 쓸모는 이용률에 있다. 이므로 이용률을 0.5에서 0.98로 올리면 처리량은 2배도 안 느는데 체류 시간은 2.0에서 59.6 으로 30배(상위 5%는 167.8)가 된다. 배치 추론에서는 너무 작으면 고정비 때문에 처리량이 모자라고 너무 크면 채우는 시간이 지연을 먹어, 이 조건에서는 B=8이 58.4ms로 최소였다. 처리량과 지연은 따로 고를 수 없다.
연결
- 추론 서빙 · 산술 강도와 메모리 대역폭 · KV 캐시 · 스펙큘러티브 디코딩