인지야공/수학·공학 노트/18번째 글
지프의 법칙 — 긴 꼬리는 예외가 아니라 기본값이다
실행:
python 딥러닝/mathnotes/M15_zipf.py토크나이저의 불평등 편과 긴 꼬리 편이 같은 분포 위에 서 있다는 것을 정리한다.
1. 거듭제곱 법칙
긴 꼬리 편에서 클래스 빈도를 인위적으로 기울였다. 그런데 현실의 데이터는 기울이지 않아도 기울어져 있다. 단어, 검색 질의, 도시 인구, 책 판매량이 모두 같은 모양을 띤다.
| 기호 | 뜻 |
|---|---|
| 순위. 가장 흔한 것이 1위 | |
| 그 순위 항목이 나온 빈도 | |
| 지수. 클수록 소수 상위가 독식한다 |
핵심은 오른쪽이다. 로그를 씌우면 직선이 된다. 그래서 로그-로그 그래프에서 직선으로 보이면 거듭제곱 법칙이고, 기울기의 절댓값이 다.
이면 “순위가 2배가 되면 빈도가 절반”이다. 2등은 1등의 1/2, 10등은 1/10이다.
2. 직접 재 보기
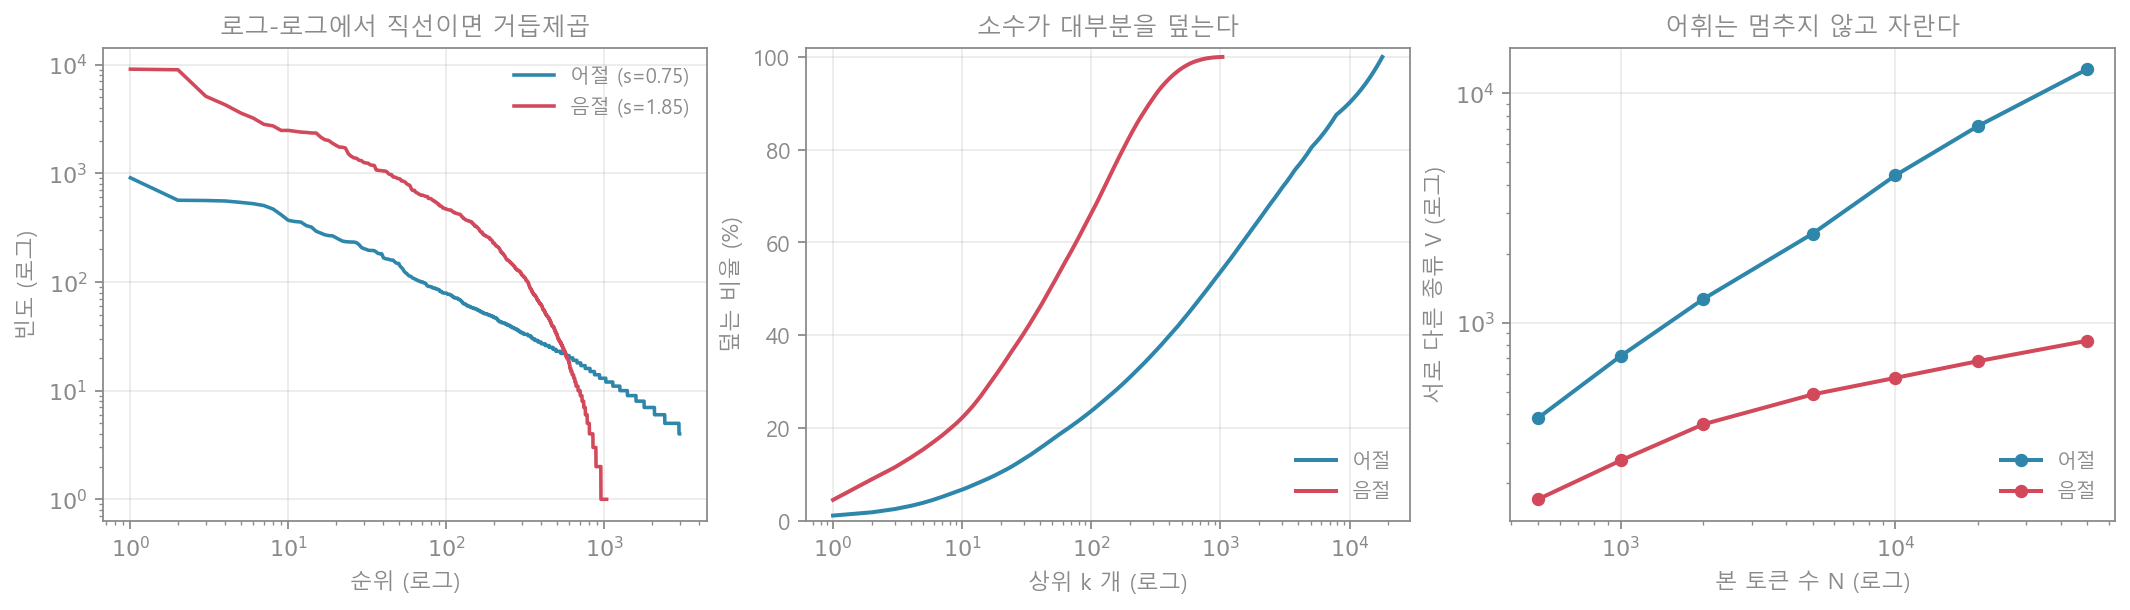
남의 말뭉치 대신 이 블로그의 글 118편을 셌다. 코드블록·수식·링크 주소를 걷어내고 남은 한국어만 쓴다. 그리고 같은 글을 어절(띄어쓰기 단위)과 음절(글자 하나) 두 방식으로 센다.
| 전체 개수 | 서로 다른 종류 | 지수 | 가장 흔한 여섯 | |
|---|---|---|---|---|
| 어절 | 80,405 | 17,921 | 0.748 | 이, 를, 한, 는, 가, 로 |
| 음절 | 201,279 | 1,035 | 1.848 | 다, 이, 는, 가, 로, 에 |
둘 다 로그-로그에서 직선이다. 그런데 기울기가 전혀 다르다. 같은 글인데 무엇을 한 토큰으로 세느냐가 분포의 모양을 바꾼다.
가 작으면(어절, 0.748) 꼬리가 두껍다 — 흔한 것이 독식하지 않고 드문 것이 많다. 가 크면(음절, 1.848) 꼬리가 얇다. 이 차이가 그대로 다음 표로 이어진다.
| 상위 10개 | 상위 100개 | 상위 1000개 | 딱 한 번 나온 것 | |
|---|---|---|---|---|
| 어절 | 6.7% | 23.7% | 53.6% | 56.0% |
| 음절 | 22.2% | 66.3% | 100.0% | 8.1% |
음절은 1000개로 전부를 덮는다. 어절은 1000개로 절반밖에 못 덮는다. 그리고 어절 종류의 56%는 글 전체에서 딱 한 번 나온다. 이것이 마르지 않는 꼬리다.
어휘는 멈추지 않고 자란다
말뭉치를 키우면 새 단어가 언제 멈출까. 답은 멈추지 않는다 이고, 자라는 속도도 거듭제곱이다.
는 서로 다른 종류의 수, 은 본 토큰의 수다. 이것을 힙스의 법칙이라 한다.
| 본 토큰 수 | 어절 종류 | 음절 종류 |
|---|---|---|
| 1,000 | 716 | 251 |
| 10,000 | 4,389 | 575 |
| 50,000 | 12,753 | 835 |
음절은 로 금세 포화한다 — 한글 음절은 애초에 유한하니 당연하다. 어절은 이라 5만 개를 봐도 1만 2천 종이 나오고, 계속 는다. 조사가 붙어 “모델이 / 모델을 / 모델은”이 전부 다른 것으로 세어지기 때문이다.
3. 왜 중요한가
- 토크나이저의 불평등 편의 거래가 정확히 이 표에 있다. 토큰 단위를 잘게 쪼개면 어휘 종류가 줄고(17,921 → 1,035) 꼬리도 마르지만, 같은 글이 80,405개에서 201,279개로 2.5배 길어진다. 어휘를 아끼면 길이를 내고, 길이를 아끼면 어휘를 낸다. 한국어가 영어보다 비싼 이유의 절반이 여기다 — 교착어라 어절 종류가 폭발한다.
- 긴 꼬리 편의 긴 꼬리가 인위적인 설정이 아니다. 그 글에서 100:1로 기울인 것은 현실을 흉내 낸 것이고, 실제 언어는 그보다 더 기울어져 있다. 클래스 불균형은 고쳐야 할 결함이 아니라 데이터의 기본 모양이다.
- “데이터를 더 모으면 해결된다”가 왜 안 되는지도 힙스의 법칙이 말해 준다. 가 0이 아닌 한 새것은 계속 나온다. 말뭉치를 10배로 늘려도 어휘는 배가 되어 꼬리가 같이 자란다. 드문 것을 다 덮는 순간은 오지 않는다.
- 그래서 실무의 선택지는 “꼬리를 없애기”가 아니라 꼬리를 다루기다 — 서브워드로 쪼개 모르는 것을 조합으로 만들거나(토크나이저의 불평등 편), 결정 경계를 옮기거나(긴 꼬리 편).
4. 한 줄 요약
순위-빈도가 로그-로그에서 직선이면 거듭제곱 법칙이고, 기울기가 지수 다. 이 블로그 118편에서 어절은 로 꼬리가 두껍고(종류 17,921개, 그중 56%가 단 한 번 등장), 같은 글을 음절로 쪼개면 에 종류 1,035개로 꼬리가 마르는 대신 길이가 2.5배가 된다. 어휘는 말뭉치의 거듭제곱()으로 계속 자라므로 꼬리를 다 덮는 순간은 오지 않는다. 긴 꼬리는 고칠 결함이 아니라 출발점이다.
연결
- 토크나이저의 불평등 · 긴 꼬리 · 토크나이저와 임베딩 · 로짓과 오즈