인지야공/딥러닝 기초 정리/4번째 글
그래프 신경망 — 이웃의 평균을 배운다
실행:
python NN_56_gnn.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
CNN 편에서 합성곱은 같은 필터를 모든 위치에 댔다. 격자에서는 “이웃”이 분명하다. 위·아래·왼쪽·오른쪽이다. 그런데 논문 인용망, 친구 관계, 분자 구조, 도로망은 격자가 아니다. 노드마다 이웃 수가 다르고 순서도 없다. 그래프 신경망은 합성곱의 생각을 이런 구조로 옮긴다. 이웃의 정보를 모아 나를 갱신한다.
1. 이웃과 섞는다 — 그림으로 먼저
가장 단순한 그래프 합성곱(GCN)은 한 층에서 이렇게 한다. 나와 이웃의 벡터를 평균내고, 모든 노드에 같은 가중치를 곱한다.
| 기호 | 뜻 |
|---|---|
| 인접 행렬. 노드 와 가 연결되어 있으면 | |
| 자기 자신도 이웃으로 친다 | |
| 각 노드의 이웃 수(자신 포함)를 대각에 둔 행렬 | |
| 정규화한 인접 행렬. 곱하면 이웃과의 가중 평균이 된다 | |
| 번째 층의 노드 표현 (노드 수 × 차원) | |
| 모든 노드가 공유하는 가중치 — CNN의 필터와 같은 역할 |
를 곱하는 것이 핵심이다. 이웃이 10명인 노드라면 자기 포함 11개 벡터의 (차수로 보정한) 평균을 받는다. 층을 개 쌓으면 칸 떨어진 노드까지의 정보가 섞여 들어온다. CNN에서 층을 쌓을수록 수용장이 넓어지던 것과 같다.
2. 직접 재 보기
노드 1,200개를 4개 커뮤니티로 나눈 그래프를 만들었다(확률적 블록 모형, 평균 이웃 10개). 각 노드의 특징은 커뮤니티 중심 + 큰 잡음이라 특징만으로는 잘 안 갈린다. 동질성 는 이웃 중 같은 커뮤니티의 비율이다. 라벨은 클래스당 20개, 모두 80개만 주고 나머지 1,120개를 맞힌다.
[A] 라벨이 80개뿐일 때 (동질성 0.80)
| 모델 | 시험 정확도 (5개 시드) |
|---|---|
| MLP (특징만) | 82.6% (±1.2) |
| GCN 1층 | 98.8% (±0.1) |
| GCN 2층 | 99.7% (±0.1) |
| GCN 3층 | 99.5% (±0.0) |
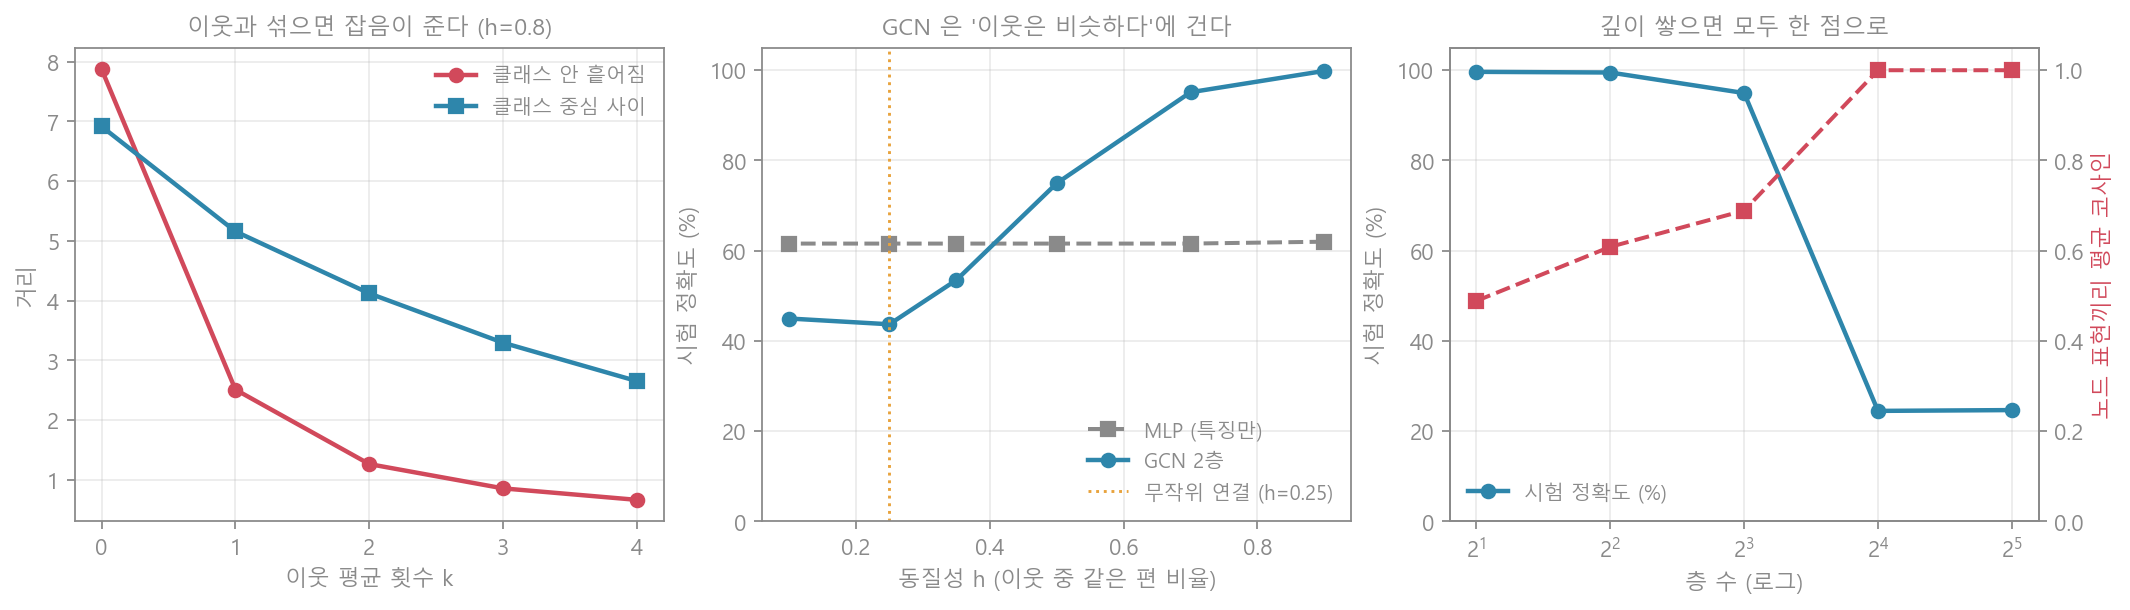
이웃을 한 번만 섞어도 82.6%가 98.8%가 된다. 왜 그런지는 학습 없이 특징에 를 곱하기만 해 보면 보인다.
| 이웃 평균 횟수 | 클래스 안 흩어짐 | 클래스 중심 사이 | 비율 |
|---|---|---|---|
| 0 | 7.873 | 6.915 | 0.88 |
| 1 | 2.512 | 5.159 | 2.05 |
| 2 | 1.266 | 4.121 | 3.26 |
| 4 | 0.667 | 2.654 | 3.98 |
평균을 한 번 내면 클래스 안의 흩어짐이 3분의 1로 준다(7.873 → 2.512). 이웃 10명의 잡음이 서로 지워지기 때문이다. 클래스 중심끼리도 조금 가까워지지만(6.915 → 5.159) 그보다 훨씬 덜 준다. 그래서 “흩어짐 대비 거리”가 0.88에서 2.05로 뛴다. 처음엔 겹쳐 있던 클래스가 한 번의 평균으로 갈라진다. 표본 오차 노트에서 개를 평균내면 잡음이 분의 1이 되던 것과 같은 산수다.
[B] 이웃이 나와 다른 편이면
동질성 를 바꿔 가며 같은 실험을 했다(3개 시드). 클래스가 4개라 무작위로 연결하면 다.
| 동질성 | MLP | GCN 2층 | 차이 |
|---|---|---|---|
| 0.90 | 62.0% | 99.9% | +37.9%p |
| 0.70 | 61.6% | 95.1% | +33.5%p |
| 0.50 | 61.6% | 74.9% | +13.4%p |
| 0.35 | 61.6% | 53.5% | −8.1%p |
| 0.25 | 61.6% | 43.7% | −17.9%p |
| 0.10 | 61.6% | 45.0% | −16.6%p |
(이 그래프는 [A]와 다른 시드로 만들어 MLP 값이 다르다. MLP는 그래프를 안 보니 와 무관하다.)
가 0.35 아래로 내려가면 GCN이 그래프를 안 보는 MLP보다 못해진다. 이웃과 평균내는 순간 내 특징이 남의 특징에 섞이기 때문이다. GCN은 “이웃은 나와 비슷하다”는 가정에 건 모델이고, 그 가정이 틀리면 그래프는 정보가 아니라 잡음이 된다.
(45.0%)이 무작위인 0.25(43.7%)보다 조금 나은 것도 눈여겨볼 만하다. 이웃이 체계적으로 다른 편이면 “내 이웃과 다르다”는 것도 정보이기 때문이다. 이질적 그래프용 GNN은 이 점을 이용해 나와 이웃을 섞지 않고 따로 다룬다.
[C] 층을 깊게 쌓으면
동질성 0.80 그래프에서 GCN 층 수를 늘렸다.
| 층 수 | 시험 정확도 | 노드 표현끼리 평균 코사인 유사도 |
|---|---|---|
| 2 | 99.6% | 0.489 |
| 4 | 99.5% | 0.609 |
| 8 | 94.9% | 0.689 |
| 16 | 24.5% | 1.000 |
| 32 | 24.7% | 1.000 |
16층에서 모든 노드의 표현이 완전히 같은 방향(코사인 1.000)이 되고, 정확도는 찍기(25%)로 떨어졌다.
이것이 모델이 학습을 못 해서인지, 이웃 평균 자체 때문인지는 학습 없이 만 곱해 보면 가를 수 있다.
| 를 곱한 횟수 | 0 | 1 | 2 | 4 | 8 | 16 | 32 |
|---|---|---|---|---|---|---|---|
| 특징끼리 평균 코사인 | 0.088 | 0.322 | 0.498 | 0.722 | 0.934 | 0.998 | 1.000 |
가중치 없이 평균만 16번 내도 0.998이다. 이웃 평균을 계속 반복하면 연결된 그래프의 모든 노드가 같은 값으로 수렴한다. 이것을 과잉 평활화(oversmoothing)라 부른다. [A]에서 한두 번의 평균은 잡음을 지웠지만, 너무 많이 하면 신호까지 지운다.
3. 흔한 오해와 한계
1. “그래프를 넣으면 항상 낫다” — [B]에서 동질성이 0.35 아래면 GCN이 MLP보다 못했다. 그래프 구조가 과제와 맞는지 (비슷한 것끼리 연결되어 있는지)부터 확인해야 한다.
2. “깊을수록 멀리 본다” — 맞지만 대가가 있다. [C]에서 8층까지는 버텼고 16층에서 무너졌다. 실제로 쓰이는 GCN이 보통 2~3층인 이유다.
3. [C]의 붕괴가 전부 과잉 평활화는 아니다 — 16층 GCN에는 잔차 연결도 정규화도 없다. 그런 깊은 망은 그 자체로 학습이 어렵다(뒤의 가중치 초기화 편·정규화와 잔차 편에서 다룬다). 다만 학습 없이 평균만 16번 내도 코사인이 0.998이 되므로, 이 망이 무엇을 학습하든 입력 단계에서 이미 노드들이 거의 구분되지 않는다. 잔차 연결을 붙이면 원래의 나를 매 층 남겨 두어 평활화를 늦출 수 있다.
4. 이 그래프는 합성 데이터다 — 확률적 블록 모형은 커뮤니티가 뚜렷하고 차수가 고르다. 실제 그래프는 차수가 멱법칙을 따라(몇몇 노드가 이웃을 수천 개 가짐) 평균이 소수에게 쏠리기 쉽다. 지프의 법칙 노트의 긴 꼬리가 여기서도 나타난다.
4. 한 문단 요약
그래프 신경망은 CNN의 “같은 필터를 이웃에 댄다”를 격자가 아닌 구조로 옮긴다. GCN 한 층은 나와 이웃의 벡터를 평균내고 () 모두가 공유하는 가중치를 곱한다. 라벨이 1,200개 중 80개뿐일 때, 특징만 보는 MLP는 82.6%, GCN 2층은 99.7% 였다. 평균 한 번에 클래스 안 흩어짐이 7.87에서 2.51로 줄어 잡음이 지워졌기 때문이다. 이 이득은 “이웃은 나와 비슷하다”는 가정에서 나온다. 이웃이 무작위로 연결되자() GCN은 MLP보다 17.9%p 낮았다. 그리고 평균을 너무 많이 반복하면 신호까지 지운다. 16층에서 모든 노드의 표현이 코사인 1.000으로 모여 정확도가 찍기(24.5%)가 됐다. 학습 없이 평균만 16번 내도 0.998이었다.