인지야공/수학·공학 노트/7번째 글
한 번에 풀기의 벽 — 층을 늘려도 안 되는 것
실행:
python 딥러닝/mathnotes/M8_circuit_depth.py,python 딥러닝/mathnotes/M8b_verify.py추론 시간 계산 편·루프 트랜스포머 편의 바탕이다. 여기 적은 가설은 재 보니 틀렸고, 틀린 채로 싣는다.
⚠ 고친 기록 (2026-09-23) — 처음 올린 3절에서 벽의 정체를 “조합이 너무 많아 못 외운다”로 단정했는데, 검증해 보니 그것도 틀렸다. 학습량을 조합 수의 8.9배까지 늘려도 학습 손실이 무작위 수준에서 내려오지 않았다 — 외울 데이터가 모자란 게 아니라 학습 자체가 안 되는 것이었다. 3절을 실측으로 다시 썼다 (
python 딥러닝/mathnotes/M8b_verify.py).
1. 세우고 싶었던 가설
트랜스포머의 순전파 한 번은 깊이가 층 수로 고정된 회로다. 층이 개면 정보가 거칠 수 있는 변환도 단계뿐이다. 그러니 단계를 순서대로 밟아야 하는 문제는 층이 개쯤 있어야 풀리고, 층을 늘리면 풀 수 있는 길이도 늘어난다 — 자연스러운 가설이고, 실제로 이론 쪽에서 자주 인용되는 얘기다.
과제는 순열 합성으로 잡았다. 5개짜리 순열(, 원소 120개)을 개 이어 붙여 합성한 결과를 맞히는 문제다. 이 문제는 지름길이 없는 것으로 알려져 있다 — 순서를 바꾸면 답이 달라지고, 중간을 건너뛸 수 없다.
2. 직접 재 보기 — 가설이 틀렸다
층 수를 1·2·4·8로 바꿔 가며, 길이별로 처음부터 따로 학습시켜 쟀다(깊은 망은 워밍업 없이는 학습이 깨져 최적화 편대로 워밍업을 넣었다).
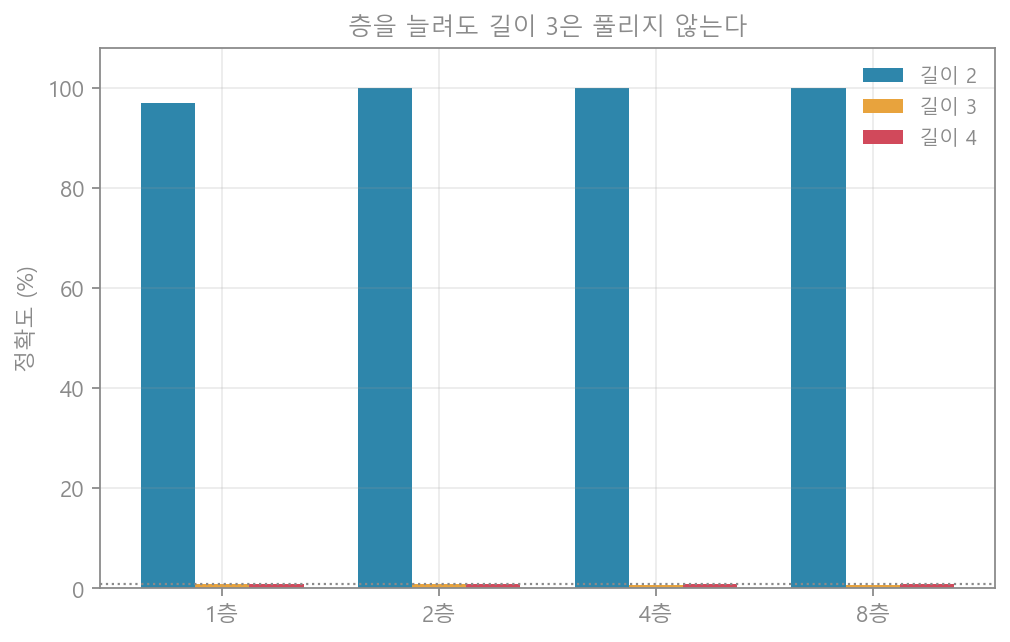
| 층 수 (파라미터) | 길이 2 | 길이 3 | 길이 4 |
|---|---|---|---|
| 1층 (0.23M) | 96.9% | 0.8% | 1.0% |
| 2층 (0.43M) | 100.0% | 0.9% | 0.8% |
| 4층 (0.82M) | 100.0% | 0.7% | 0.9% |
| 8층 (1.62M) | 100.0% | 0.8% | 0.8% |
무작위로 찍으면 0.83%()다. 층을 8배, 파라미터를 7배로 늘려도 길이 3은 꿈쩍도 하지 않았다. 깊이가 벽이었다면 8층은 적어도 길이 3~4까지는 갔어야 한다. 가설은 틀렸다.
3. 그럼 벽은 무엇이었나 — 두 번째 가설도 틀렸다
처음에는 조합의 수를 범인으로 지목했다. 길이 2는 서로 다른 입력이 가지뿐이라 통째로 외울 수 있고, 길이 3은 가지라 못 외운다 — 그럴듯했다. 학습에서 본 것은 100만 개뿐이었으니까.
그렇다면 학습량을 조합 수보다 훨씬 많이 주면 풀려야 한다. 재 봤다.
| 길이 3 (조합 1,728,000가지) | 표본 1.02M (조합의 0.6배) | 표본 5.12M (3.0배) | 표본 15.36M (8.9배) |
|---|---|---|---|
| 2층 정확도 | 0.6% | 0.9% | 1.7% |
| 2층 학습 손실 | 4.788 | 4.788 | 4.094 |
| 8층 정확도 | 0.8% | 0.9% | 1.0% |
| 8층 학습 손실 | 4.786 | 4.788 | 4.787 |
가설이 또 틀렸다. 조합 수의 8.9배를 먹여도 1.7%(무작위 0.8%)다. 그리고 결정적인 것은 정확도가 아니라 학습 손실이다. 은 아무것도 모르고 균등하게 찍을 때의 손실인데, 8층 모델은 1,536만 개를 보고도 거기서 한 발짝도 못 내려왔다. 시험을 못 본 게 아니라 교과서조차 외우지 못한 것이다.
대조군을 보면 차이가 분명하다.
| 길이 2 (조합 14,400가지) | 표본 0.26M | 표본 1.02M |
|---|---|---|
| 정확도 | 14.2% | 100.0% |
| 학습 손실 | 3.634 | 0.028 |
길이 2에서는 손실이 4.79에서 0.028까지 떨어진다. 같은 모델, 같은 옵티마이저인데 길이가 하나 늘었을 뿐 학습이 아예 시작되지 않는다.
그러니 벽은 깊이도, 데이터 양도 아니다. 경사하강이 이 함수의 해를 찾지 못한다. 순열 합성()은 군론에서 비가해군(non-solvable)이라 부르는 구조이고, 고정 깊이 신경망이 이런 합성을 배우기 어렵다는 것은 이론 쪽에서도 지적돼 온 바다. 길이 2가 풀린 것은 합성을 이해해서가 아니라 14,400칸짜리 곱셈표를 외웠기 때문이고, 그 표가 커지는 순간 외울 대상도 배울 규칙도 손에 잡히지 않는다.
4. 그래서 사고 사슬이 이긴다
같은 과제를 한 걸음씩 풀면 어떻게 될까. 모델에게 외우게 할 것은 두 원소의 합성표 하나(14,400가지)뿐이고, 긴 문제는 그것을 여러 번 적용해서 푼다. 추론 시간 계산 편에서 이대로 재 보니 길이 8까지 100%였다.
이것이 사고 사슬(chain-of-thought)의 정체다 — 모델을 더 똑똑하게 만드는 것이 아니라, 외워야 할 것을 하나로 줄이고 나머지를 반복으로 처리하는 것이다. 그래서 루프 트랜스포머 편·잠재 반복 vs 토큰 사슬 편의 주제와 같은 자리에 선다. 계산을 파라미터로 살 것인가, 시간으로 살 것인가.
5. 한 줄 요약
“순차 문제는 층을 쌓으면 된다”는 가설은 틀렸다 — 1층에서 8층까지 길이 3은 0.8%로 똑같았다. 이어서 세운 “조합이 많아 못 외운다”는 가설도 틀렸다 — 조합 수의 8.9배를 줘도 학습 손실이 에서 내려오지 않았다. 벽은 깊이도 데이터도 아니고 학습 가능성이다. 길이 2가 풀린 것은 규칙을 배워서가 아니라 14,400칸 곱셈표를 외운 것이고, 길이 3부터는 외울 수도 배울 수도 없다. 그래서 외울 것을 한 단계로 줄이고 반복하게 하면 (사고 사슬) 길이 8까지 100%가 된다.
연결
- 추론 시간 계산 · 루프 트랜스포머 · 잠재 반복 vs 토큰 사슬 · 최적화