인지야공/딥러닝 기초 정리/50번째 글
근사 최근접 이웃 — 검색을 빠르게 하는 대가
실행:
python NN_44_ann_search.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 함께 보면 좋은 글: RAG 편 RAG · 고차원의 기하 노트
RAG 편에서 “질문과 뜻이 가까운 문서를 찾는다”고 했다. 그런데 문서가 수억 개라면 가까운 것을 어떻게 찾는가. 전부 비교할 수는 없다.
1. 나눠서 일부만 — 그림으로 먼저
발상은 도서관과 같다. 책을 주제별 서가에 꽂아 두고, 찾을 때 가장 그럴듯한 서가 몇 개만 뒤진다. 벡터에서는 서가가 군집이고, 군집의 대표점(중심)과 질문을 먼저 비교해 어느 서가를 열지 고른다.
③에 이 방법의 본질이 있다. 안 연 서가에 정답이 있으면 그냥 놓친다. 그래서 이 검색은 근사(approximate)이고, 성능을 말할 때 속도와 재현율을 함께 봐야 한다.
| 기호 | 뜻 |
|---|---|
| 문서 수 | |
| 나눠 둔 군집의 수 | |
| 질문마다 실제로 여는 군집의 수 | |
| 재현율 | 정확한 top- 중 몇 개를 실제로 찾았는가 |
비용은 대략 번의 비교다. 앞항은 어느 서가를 열지 고르는 비용, 뒷항은 연 서가를 뒤지는 비용이다.
2. 직접 재 보기 A — 전부 비교하면 얼마나 드나
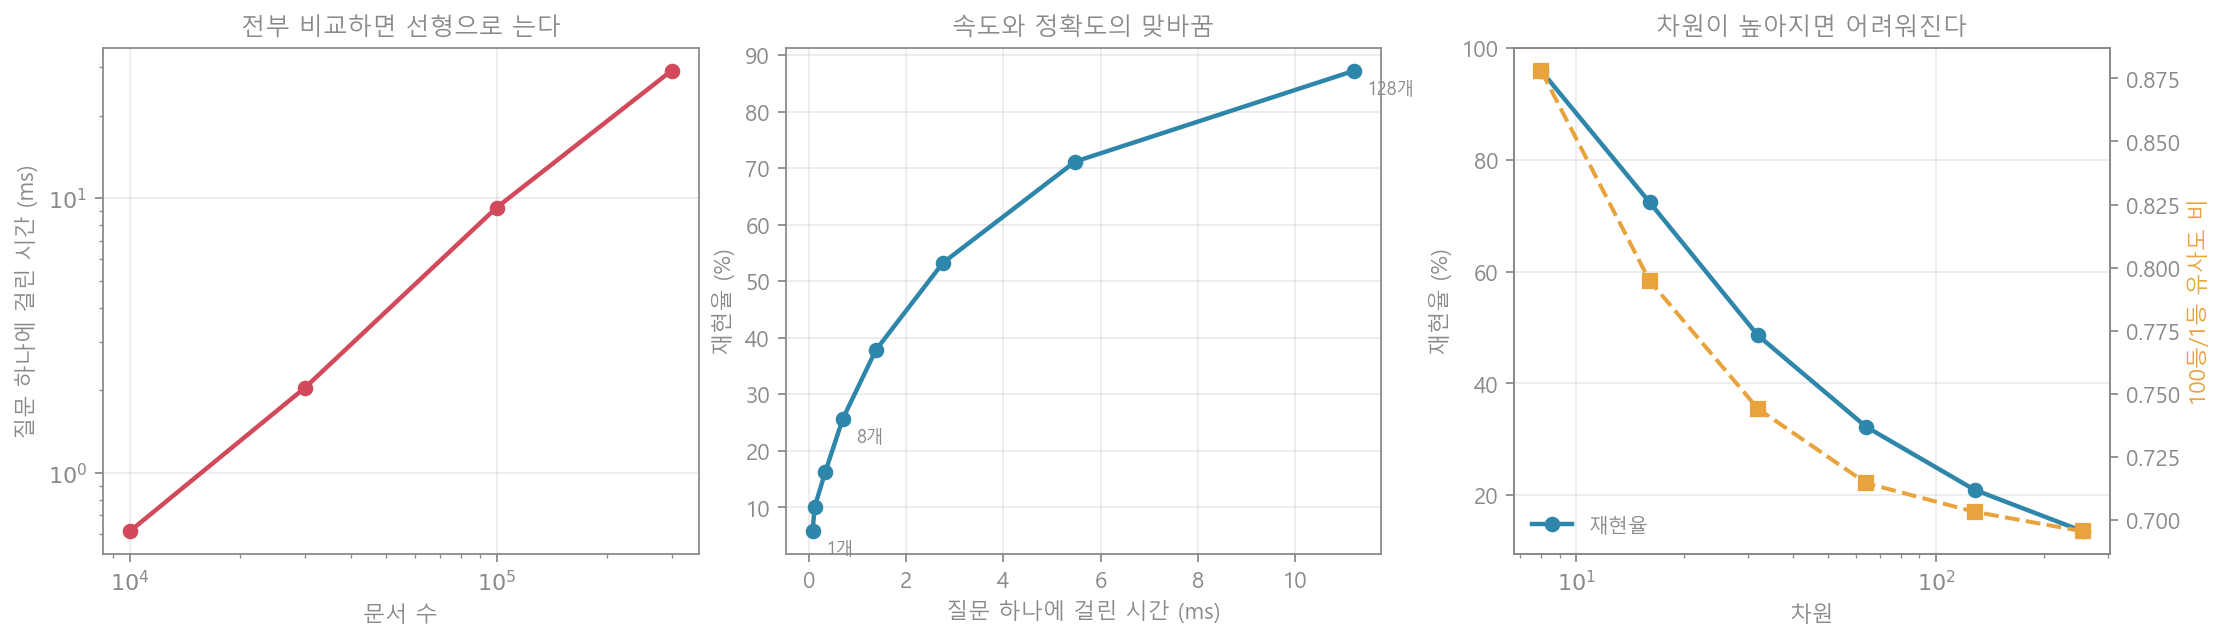
64차원 벡터를 문서로 두고, 정확한 top-10을 찾는 시간을 쟀다.
| 문서 수 | 10,000 | 30,000 | 100,000 | 300,000 |
|---|---|---|---|---|
| 질문 하나에 걸린 시간 | 0.613 ms | 2.039 ms | 9.240 ms | 29.121 ms |
문서 수에 그대로 비례한다(30배 문서 → 47배 시간). 30만 개에 29ms면 초당 34질문이다. 문서가 수억 개인 서비스에서는 이 방식이 성립하지 않는다.
주의할 점은 이것이 느린 코드의 문제가 아니라는 것이다. 정확한 답을 보장하려면 모든 문서를 한 번은 봐야 한다 — 알고리즘의 하한이다. 빨라지려면 정확함을 포기해야 한다.
3. 직접 재 보기 B — 몇 %만 보고 얼마나 찾나
20만 개를 512개 군집으로 나누고(군집당 평균 391개), 여는 군집 수만 바꿨다.
| 여는 군집 | 1개 | 4개 | 8개 | 16개 | 32개 | 64개 | 128개 |
|---|---|---|---|---|---|---|---|
| 실제로 본 문서 비율 | 0.2% | 0.8% | 1.6% | 3.1% | 6.2% | 12.5% | 25.0% |
| 재현율 | 5.8% | 16.2% | 25.6% | 37.8% | 53.2% | 71.2% | 87.3% |
| 질문당 시간 | 0.076 ms | 0.335 ms | 0.695 ms | 1.377 ms | 2.754 ms | 5.477 ms | 11.217 ms |
읽는 법이 두 가지다.
좋은 소식: 전체의 1.6%만 보고도 top-10 중 4분의 1을 찾는다. 시간은 0.695ms다. 2절에서 10만 개를 전부 비교하는 데 9.2ms가 걸렸으니, 20만 개라면 그보다 더 든다 — 20배 이상 빠른 셈이다.
나쁜 소식: 마지막 재현율이 비싸다. 25.6%에서 87.3%로 가려면 본 문서를 1.6%에서 25%로, 시간을 0.695ms에서 11.2ms로 16배 늘려야 한다. 재현율 곡선은 뒤로 갈수록 눕는다.
여는 군집이 늘면서 실제로 무엇이 달라지는지 2차원으로 그려 봤다.
별(질문)에서 가까운 군집부터 열린다. 처음 몇 개로 대부분을 건지고, 나머지 몇 개를 위해 훨씬 넓은 영역을 더 열어야 한다. RAG 편에서 “정답률은 검색 재현율을 넘지 못한다”고 했는데, 그 재현율이 바로 여기서 속도와 맞바꿔진다.
4. 직접 재 보기 C — 차원이 높아지면 어려워진다
같은 설정(군집 256개 중 8개 열기)에서 차원만 바꿨다.
| 차원 | 8 | 16 | 32 | 64 | 128 | 256 |
|---|---|---|---|---|---|---|
| 재현율 | 96.0% | 72.4% | 48.6% | 32.2% | 21.0% | 13.5% |
| 100등/1등 유사도 비 | 0.878 | 0.795 | 0.744 | 0.715 | 0.703 | 0.696 |
8차원에서 96%였던 것이 256차원에서 13.5%가 된다. 알고리즘도 데이터 개수도 그대로다.
둘째 줄이 이유를 말해 준다. 차원이 올라갈수록 1등과 100등의 유사도 차이가 줄어든다(0.878 → 0.696). 곧 “가까움”이 흐려져서, 군집의 경계가 정답을 가를 힘을 잃는다. 고차원 기하 노트에서 본 “고차원에서는 아무 두 벡터나 거의 직교한다”는 성질의 실무적 대가다.
그래서 실제 벡터 검색은 군집만 쓰지 않는다. 그래프 기반(HNSW: 가까운 것끼리 이어 둔 길을 따라간다), 양자화(PQ: 벡터를 쪼개 코드로 압축해 메모리와 비교 비용을 줄인다) 같은 장치를 겹쳐 쓴다. 다만 어느 쪽이든 재현율과 속도를 맞바꾼다는 성질은 그대로다.
5. 흔한 오해와 한계
- “벡터 검색은 빠르다” — 근사이기 때문에 빠르다. 정확한 검색은 문서 수에 비례한다(2절).
- “재현율 95%면 충분하다” — 그 5%를 어디서 잃는지가 중요하다. 흔한 질문이 아니라 드문 질문에서 집중적으로 잃으면 체감 품질은 훨씬 나쁘다.
- “차원이 높을수록 표현력이 좋아 검색도 낫다” — 검색은 오히려 어려워진다(4절).
- “인덱스를 만들면 끝” — 군집을 만드는 데도 시간이 든다(20만 개·512군집에 23초). 문서가 계속 늘면 재구축·갱신 비용이 따로 생긴다.
- 이 글의 실험 — 인위적으로 덩어리진 64차원 데이터와 단순한 IVF다. 87.3%·27배 같은 수는 이 설정의 값이고(실제 HNSW는 같은 재현율을 더 싸게 낸다), 요점은 정확함을 포기해야 빨라진다, 마지막 재현율이 가장 비싸다, 차원이 이 거래를 나쁘게 만든다는 구조다.
6. 한 문단 요약
정확한 최근접 이웃 검색은 모든 문서를 한 번씩 봐야 하므로 시간이 문서 수에 비례한다 (30만 개에 질문당 29ms). 그래서 실무는 근사를 쓴다 — 미리 군집으로 나눠 두고 가까운 서가 몇 개만 연다. 20만 개를 512군집으로 나눴을 때 전체의 1.6%만 열면 0.695ms에 재현율 25.6%, 25%를 열면 11.2ms에 87.3%였다. 즉 재현율은 시간으로 사는 것이고, 마지막 몇 %가 가장 비싸다. 게다가 이 거래는 차원이 높아질수록 나빠진다. 같은 설정에서 차원을 8에서 256으로 올리자 재현율이 96.0%에서 13.5%로 떨어졌는데, 1등과 100등의 유사도 차이가 0.878에서 0.696으로 흐려졌기 때문이다. RAG 편에서 “RAG의 천장은 검색 재현율”이라고 했다면, 이 글은 그 재현율의 가격표다.