인지야공/오늘의 AI 이슈/3번째 글
역전파 없이 1,000층? — 라그랑주 승수가 오차를 '파도'로 바꾸는 법
실험:
python 딥러닝/daily/2026-09-15_pc_alm_credit.py(numpy, 약 30초) 글의 수치는 전부 그 스크립트를 돌려 얻은 것이고, 사건 내용은 논문 원문과 2026년 9월 14일 보도로 교차 확인했다. 실험은 논문의 재현이 아니다. MNIST 학습은 하지 않았고, 핵심 주장(평형 = 역전파, 확산 vs 탄도, T=2L)만 떼어 잰 축소 모형이다.
1. 무슨 일이 있었나
사카나 AI(Sakana AI)가 PC-ALM(Augmented Lagrangian Predictive Coding, 증강 라그랑지안 예측 부호화)을 공개 해설 글과 코드로 소개했고, 2026년 9월 14일 보도가 이어졌다. 보도의 제목은 “1,000층 신경망을 역전파 없이 학습”이었다.
사실관계를 두 겹으로 나눠 둔다. 무엇이 어디에 적혀 있는지가 다르다.
| 출처 | 내용 |
|---|---|
| 논문 arXiv:2605.31022 v1 (2026-05-29, Jeffrey Seely · Julian Gould) | 알고리즘, 선형 망에서 평형이 정확한 역전파라는 명제, 확산 vs 탄도 분석. 실험은 MNIST·Fashion-MNIST, 잔차 MLP, 깊이 8~128, 폭 8~128 |
| 논문 그림 2의 요지 | 추론 예산 이면 폭·깊이·활성함수 전 범위에서 PC-ALM 이 역전파(BP)와 같은 성능 |
| 9/14 보도가 전한 기준 칸 (폭 32, 깊이 32, ReLU, Fashion-MNIST) | 테스트 정확도 BP 78.66%, 기존 PC 68.13%, PC-ALM 77.75%. BP 기울기와의 코사인 0.604 → 0.909 |
| 9/14 해설·보도의 1,000층 주장 | MNIST, 폭 32, ReLU, 5 에폭의 1,000층 잔차 MLP 가 BP 와 약 2%p 안쪽 |
그러니 “1,000층”은 5월 논문 본문(최대 128층)에는 없고, 9월 해설 글에서 새로 보인 결과다. 쉬운 데이터(MNIST) 하나에서의 결과라는 점도 같이 적어 둔다.
이 글은 “왜 이게 되는가”를 본다. 뼈대는 세 조각이다 — 예측 부호화의 오차는 물처럼 번진다, 라그랑주 승수가 그것을 파도로 바꾼다, 파도가 끝까지 가는 데 딱 스텝이 걸린다.
2. 출발점 — 역전파는 무엇을 계산하나
층짜리 사슬 망을 생각한다. (강의 05편의 순전파·역전파와 같은 이야기다.)
역전파는 출력에서 입력 쪽으로 한 층씩 오차 신호 를 넘긴다.
| 기호 | 뜻 |
|---|---|
| 번째 층의 활성값(벡터) | |
| 번째 층의 가중치 행렬 | |
| 활성함수에 들어가기 전 값 | |
| 활성함수 (tanh, ReLU 등) | |
| 손실 | |
| 층이 받는 신용(credit) — “이 층 값을 바꾸면 손실이 얼마나 변하나” | |
| 를 조금 바꿨을 때 이 변하는 비율(야코비 행렬) | |
| 성분별 곱 |
문제는 이 계산의 모양이다. 순전파를 끝낸 뒤, 전체를 멈추고, 맨 끝에서 맨 앞까지 한 번에 쓸어내려야 한다. 뇌는 이렇게 하지 않는 것으로 보이고, 층마다 다른 칩에 나눠 동시에 계산하려는 하드웨어에도 불편하다. 그래서 각 층이 이웃하고만 대화해서 같은 답을 내는 방법 — 국소 학습 — 을 오래 찾아 왔다. 예측 부호화가 대표 후보다.
3. 예측 부호화(PC) — 에너지를 낮추면 오차가 번진다
비유. 층마다 “아래층이 나를 이렇게 예측했는데 실제 나는 이렇다”는 어긋남을 들고 있다. 출력에 정답을 걸어 두면 맨 끝층이 어긋나고, 그 층이 움직이면 바로 아래층과의 어긋남이 생기고, 또 그 아래층이 움직이고… 어긋남이 이웃에서 이웃으로 번진다. 충분히 번진 뒤 각 층이 자기 어긋남만 보고 가중치를 고친다.
수식으로는 활성값 를 자유 변수로 풀어놓고 에너지를 정의한다.
| 기호 | 뜻 |
|---|---|
| 예측 오차 — 실제 와 아래층이 예측한 값의 차이 | |
| 예측 오차에 매기는 벌점의 세기 | |
| 추론 한 스텝의 크기 | |
| 추론 스텝 수(가중치를 한 번 고치기 전에 를 몇 번 움직이나) |
추론은 를 번 하는 것이다. 에 대한 기울기는 자기 오차 와 바로 위층 오차 만 쓴다 — 국소적이다.
손으로 두 스텝
스칼라 사슬 3층, 가중치 모두 1, 활성함수 없음, 입력 1, 정답 0, 로 두면 순전파는 , 출력 오차 1 이다.
| 스텝 | 맨 끝층 | 가운데 | 첫 층 |
|---|---|---|---|
| 0 | 1 | 1 | 1 |
| 1 | (출력 오차가 끌어내림) | 1 | 1 |
| 2 | ( 가 끌어내림) | 1 | |
| 3 | … | … |
거리 층 떨어진 곳에 처음 도착하는 신호의 크기가 다. 면 두 층 건너 0.0625, 세 층 건너 0.0156. 신호는 한 스텝에 한 층씩 가긴 가지만 가면서 급격히 옅어지고, 쓸 만한 크기로 쌓이려면 오래 기다려야 한다.
더 근본적인 문제가 있다. PC 에서 층이 넘기는 신용은 — 어긋남 그 자체다. 그런데 아래층이 따라 움직이면 어긋남이 줄어든다. 신용을 넘기는 순간 자기 몫이 깎인다. 그래서 신용을 들고 있으려면 가 순전파 값에서 계속 벗어나 있어야 하고, 그 벗어난 자리에서 계산한 기울기는 BP 와 어긋난다. (PC 가 BP 에 가까워지는 것은 오차가 아주 작은 극한에서다.)
4. PC-ALM — 라그랑주 승수가 ‘기억’이 된다
PC-ALM 은 문제를 제약 최적화로 다시 쓴다. “예측 오차를 조금 벌점 주자”가 아니라 ” 이어야 한다(= 순전파 그대로)“를 제약으로 걸고, 고전적인 증강 라그랑지안 방법을 쓴다.
| 기호 | 뜻 |
|---|---|
| 층의 라그랑주 승수(쌍대 변수) — 층마다 하나, 와 같은 크기 | |
| 쌍대 스텝 크기. 이면 기존 PC 와 똑같다 | |
| 이제 층이 넘기는 신용 | |
| 가중치 학습률 |
논문 알고리즘은 원·쌍대 스텝을 번 번갈아 한 뒤 원 변수 스텝을 한 번 더 한다. 달라진 것은 한 줄뿐이다. 그런데 이 한 줄이 3절의 두 문제를 모두 푼다.
- 는 지나간 어긋남의 누적합이다. 아래층이 따라와서 가 0 이 돼도 는 줄지 않는다. 신용을 넘겨도 자기 몫이 깎이지 않는다.
- 그래서 평형에서는 — 가 정확히 순전파 값으로 돌아오고 — 신용은 전부 가 들고 있다.
논문의 명제 3(선형 망, 가중치 고정, 반복 행렬의 스펙트럼 반경 < 1): 반복은 유일한 평형으로 수렴하고, 거기서 ① 는 순전파, ② 는 역전파 신용(부호만 반대, ), ③ 가중치 기울기는 BP 기울기와 정확히 같다.
직접 재 보기 A — 평형은 정말 역전파인가
깊이 , 폭 16 인 선형 사슬(가중치는 무작위 직교 행렬), , , (에너지 곡률의 역수)로 두고, 추론 스텝 를 늘려 가며 가중치 기울기를 BP 기울기와 비교했다.
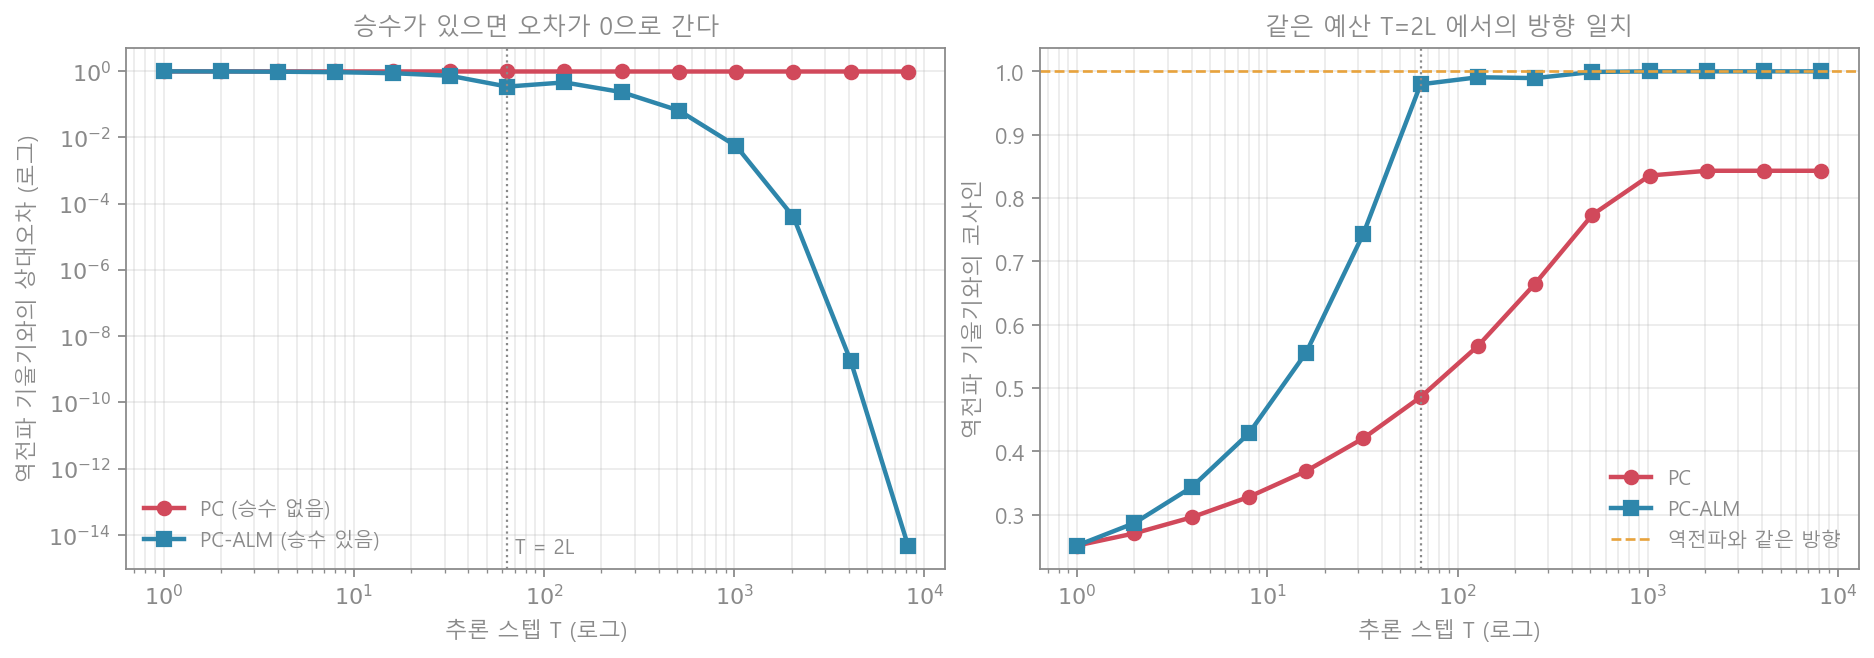
| 추론 스텝 | 16 | 64 (=2L) | 1,024 | 8,192 |
|---|---|---|---|---|
| PC 상대오차 / 코사인 | 0.965 / 0.369 | 0.963 / 0.486 | 0.962 / 0.836 | 0.962 / 0.843 |
| PC-ALM 상대오차 / 코사인 | 0.856 / 0.556 | 0.337 / 0.980 | 0.0054 / 1.000 | / 1.000 |
- PC-ALM 은 기계 정밀도까지 BP 와 같아졌다(상대오차 ). 명제 3 그대로다.
- PC 는 끝까지 기다려도 코사인 0.843 에서 멈췄다. 느린 게 아니라 평형 자체가 BP 가 아니다 — 3절의 “신용을 들려면 어긋나 있어야 한다” 때문이다.
- 에서 PC-ALM 코사인은 벌써 0.980. 다만 오차가 매끈하게 줄지는 않았다( 에서 상대오차가 0.451 로 잠깐 커졌다). 파도는 한 번 도착한 뒤 출렁인다.
5. 물 번짐과 파도 — 왜 하필 T = 2L 인가
두 방법의 차이는 물리의 두 방정식 차이와 같다.
| 기호 | 뜻 |
|---|---|
| 퍼지는 양 (여기서는 신용) | |
| 출력층에서 떨어진 거리(층 수) | |
| 추론 스텝 | |
| , | 확산 계수, 파동 속도 |
PC 의 추론은 에너지를 내려가는 1차 흐름 — 잉크 방울이 번지는 열 방정식꼴이다. PC-ALM 은 가 어긋남을 적분해 두기 때문에 시간에 대해 2차 가 된다(운동량이 생긴 것과 같다) — 파동 방정식꼴이다. 논문의 결론도 그렇다.
는 스텝 뒤 신용이 도달한 깊이다. 거꾸로 읽으면 층 끝까지 가는 데 PC 는 에 비례, PC-ALM 은 에 비례하는 스텝이 든다. 그리고 , 면 파동 속도 층/스텝 — 층을 건너는 데 정확히 스텝이다. 논문의 추론 예산 은 이 산수에서 나온다.
직접 재 보기 B — 도착 시각을 층마다 쟀다
깊이 128, 폭 8 선형 사슬(, 이론 속도 0.500 층/스텝). 각 층의 신용 크기 가 최종값의 절반에 처음 닿는 스텝을 “도착”으로 정했다.
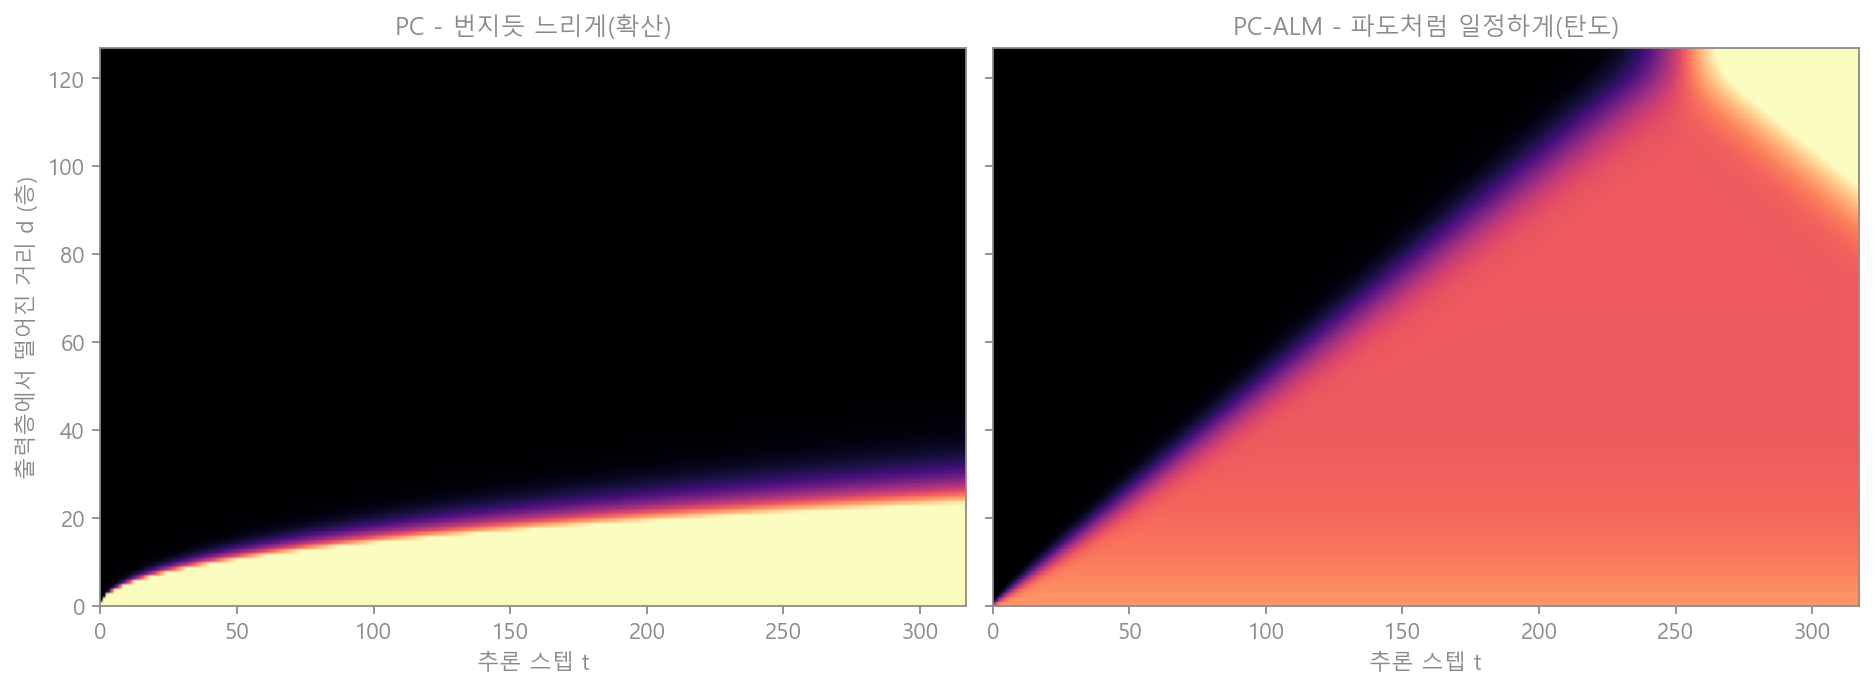
왼쪽(PC)은 앞머리가 휘어져 눕는다 — 물 번짐. 오른쪽(PC-ALM)은 곧은 사선 — 일정한 속도의 파도다. 약 250 스텝에 입력층에 닿은 뒤 위쪽 밝은 띠는 반사되어 돌아오는 출렁임이다(4절의 흔들림과 같은 현상).
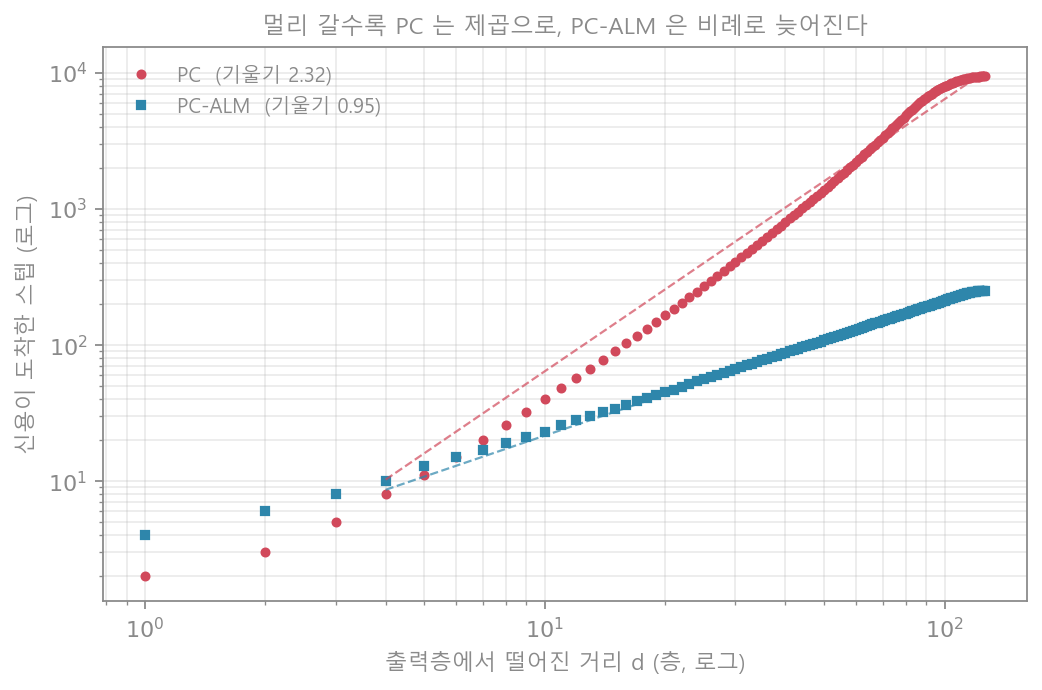
| 출력층에서 거리 | 16층 | 64층 | 126층 | 거리 지수 적합 |
|---|---|---|---|---|
| PC 도착 스텝 | 103 | 2,623 | 9,427 | |
| PC-ALM 도착 스텝 | 36 | 138 | 249 |
- PC-ALM 은 층당 2.04 스텝, 속도 0.489 층/스텝 — 이론 0.500 과 맞는다. 126층을 249 스텝, 즉 거의 정확히 에 건넜다.
- PC 는 거리가 4배(16→64)가 되자 25배, 거의 8배(16→126)가 되자 92배 늦어졌다. 지수 2.32 는 이론의 2 보다 조금 크다 — 3절에서 본 대로 신호가 가면서 옅어지는 몫이 더해진 것으로 보인다.
- 126층 거리에서 두 방법의 차이는 약 38배. 1,000층이면 이 격차는 그대로 층 수에 비례해 더 벌어진다.
6. 비선형 망에서는
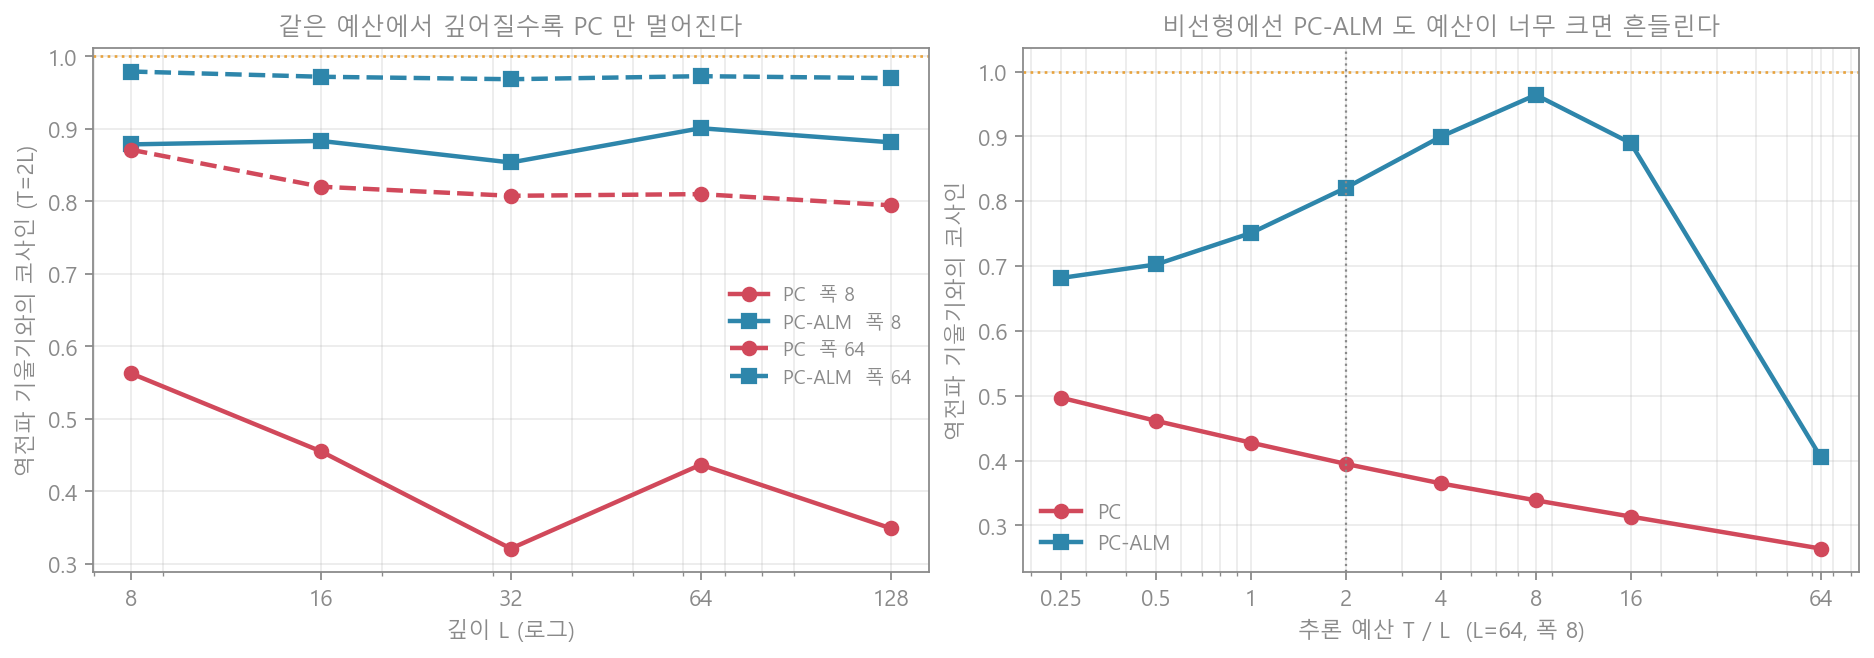
명제 3 은 선형 망 한정이다. 실제로 쓰는 비선형 망에서의 주장은 실험뿐이다. 잔차 tanh 망 ()으로 두 가지를 쟀다.
직접 재 보기 C — 같은 예산 T = 2L, 깊이를 늘리면
망마다 무작위 6개의 평균. “가장 먼 층”은 입력 바로 위 첫 층, 즉 신용이 가장 멀리 가야 하는 층이다.
| 폭 8, | L=8 | L=32 | L=128 |
|---|---|---|---|
| 전체 코사인 PC / PC-ALM | 0.563 / 0.879 | 0.321 / 0.854 | 0.349 / 0.882 |
| 가장 먼 층 PC / PC-ALM | 0.963 / 0.927 | 0.973 / 0.923 | 0.172 / 0.958 |
| 폭 64, | L=8 | L=32 | L=128 |
|---|---|---|---|
| 전체 코사인 PC / PC-ALM | 0.871 / 0.979 | 0.808 / 0.969 | 0.795 / 0.970 |
| 가장 먼 층 PC / PC-ALM | 0.983 / 0.961 | 0.972 / 0.927 | 0.031 / 0.895 |
- 깊이 128 에서 PC 의 첫 층 기울기는 방향이 거의 무작위(코사인 0.172, 0.031)다. 스텝으로는 확산이 거기까지 못 간다. PC-ALM 은 0.895~0.958 을 유지했다.
- 얕은 망(L=8)의 첫 층은 오히려 PC 가 약간 높았다. 거리가 짧으면 번짐도 충분히 닿는다 — 차이는 깊이에서 난다.
- 좁을수록(폭 8) 격차가 크다. 논문이 “깊고 좁은 망에서 PC 가 무너지고 PC-ALM 이 메운다”고 한 것과 같은 방향이다.
직접 재 보기 D — 그럼 오래 돌리면 더 좋아지나? (가설이 틀린 부분)
선형에서처럼 “오래 돌리면 BP 에 수렴”을 기대하고 깊이 64, 폭 8 망 3개를 최대 65,536 스텝(1,024L) 까지 돌렸다.
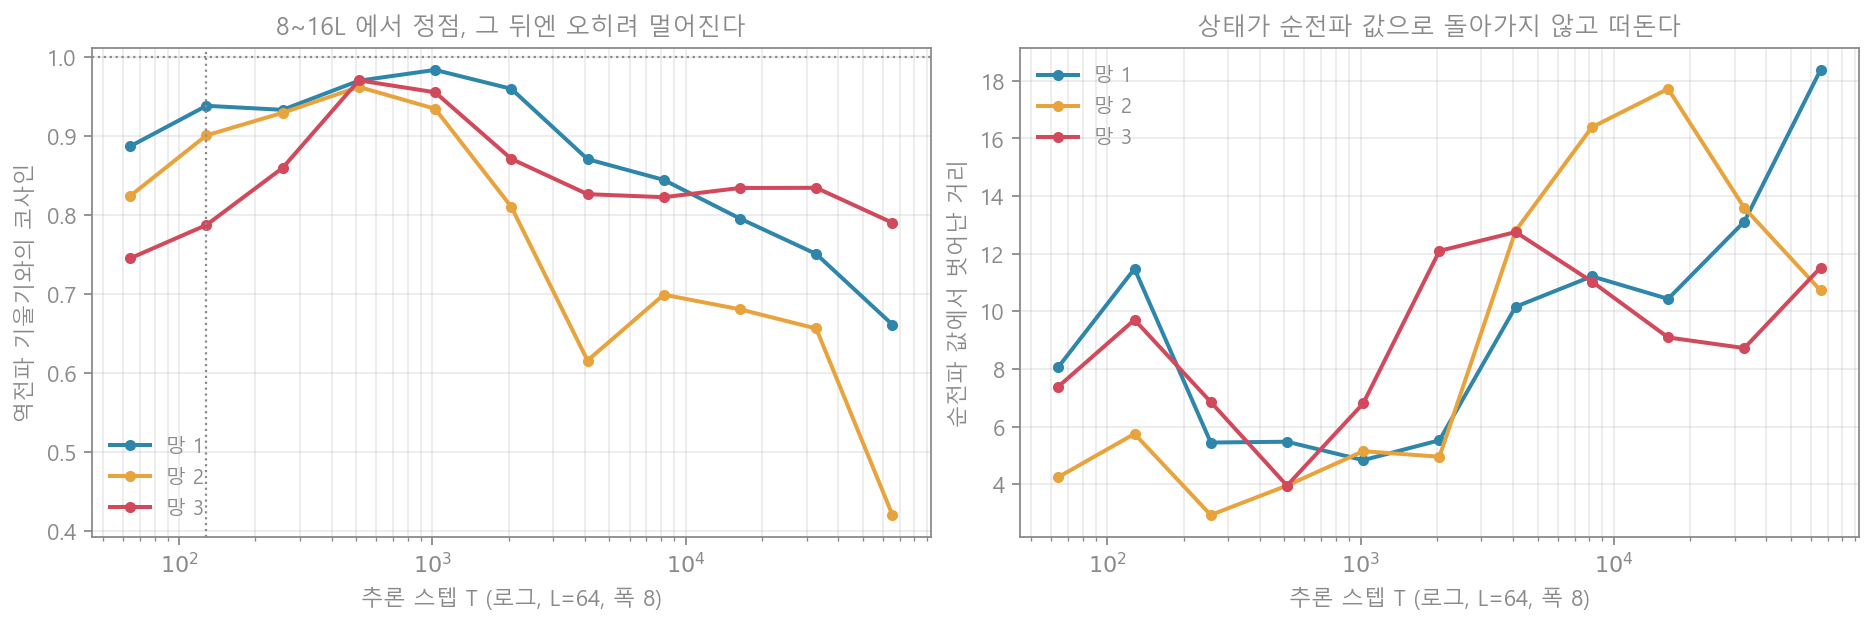
| 추론 스텝 | 128 (2L) | 512 (8L) | 1,024 (16L) | 4,096 (64L) | 65,536 (1,024L) |
|---|---|---|---|---|---|
| 망 1 코사인 | 0.938 | 0.970 | 0.984 | 0.871 | 0.661 |
| 망 2 코사인 | 0.901 | 0.962 | 0.934 | 0.616 | 0.421 |
| 망 3 코사인 | 0.787 | 0.970 | 0.955 | 0.826 | 0.790 |
- 틀렸다. 세 망 모두
에서 정점(0.9620.984)을 찍고, 그 뒤로는 오히려 BP 에서 멀어졌다. 상태 도 순전파 값으로 돌아가지 않고 떠돌았다(오른쪽 그림). - 이 실험은 스텝 크기를 순전파 지점의 곡률로 한 번 정하고 고정했다. 비선형에서는 곡률이 자리마다 달라 원·쌍대 반복이 안장점 주변을 맴돌 수 있다. 다른 무작위 망 3개로 쌍대 스텝 를 1, 0.5, 0.25 로 바꾼 별도 점검에서는 1개는 어느 에서나 BP 로 수렴(코사인 1.000) 했고, 나머지 2개는 를 줄여도 떠돌았다. 망에 따라 갈린다.
- 그러니 비선형에서 은 “평형까지 가는 시간”이 아니라 “파도가 한 번 끝까지 닿는, 잘 고른 조기 종료” 로 읽는 편이 맞다. 논문도 한계로 “고정 예산 와 점근 평형의 관계는 불분명하다”고 적었다. 같은 스윕에서 PC 는 오래 돌릴수록 오히려 낮아졌다(0.497 → 0.264) — PC 의 평형이 애초에 BP 가 아니기 때문이다.
7. 흔한 오해와 한계
- “역전파가 필요 없어졌다” — 계산하는 기울기는 역전파와 같다(선형에선 정확히). 없어진 것은 “전체를 멈추고 한 번에 쓸어내리는 절차”다. 대신 번의 국소 반복을 돈다. 1,000층이면 가중치 한 번 고칠 때마다 추론 2,000 스텝이다.
- “메모리가 줄었다” — 아니다. 층마다 에 더해 같은 크기의 를 들고 있어야 해서 PC 의 활성값 메모리가 2배다 (논문 명시).
- “완전히 뇌처럼 국소적이다” — 층 사이 소통은 이웃뿐이지만, 신용을 아래로 넘길 때 여전히 (가중치 전치) 를 쓴다. 앞으로 보낸 가중치를 뒤로도 똑같이 알아야 한다는 오래된 문제(weight transport)는 그대로다.
- “1,000층이 논문에서 검증됐다” — 논문 v1 의 실험은 128층까지다. 1,000층은 9월 해설 글의 MNIST 한 설정(폭 32, ReLU, 5 에폭)이고, BP 와 2%p 안쪽이지 같지는 않다. ImageNet 급이나 트랜스포머에서의 결과는 없다.
- “이론이 비선형도 보장한다” — 명제는 선형 한정이다. 6절 D 처럼 비선형에서 오래 돌리면 오히려 멀어질 수 있다.
- 이 글의 실험은 축소 모형 — 정해진 가중치에서 기울기 한 번을 비교했을 뿐, 학습 곡선·정확도는 재지 않았다.
8. 한 문단 요약
예측 부호화(PC)는 층마다 “예측과 실제의 어긋남”을 이웃에게 넘겨 역전파 없이 신용을 나르지만, 신용이 어긋남 그 자체라 넘길수록
깎이고 물처럼 번져서, 재 보니 126층 거리에 닿는 데 9,427 스텝(거리의 2.32제곱)이 걸렸고 선형에서도 끝내 BP 와 코사인 0.843 에
멈췄다. PC-ALM 은 라그랑주 승수 한 줄로 어긋남을 누적 기억시켜, 평형에서 는 순전파로 돌아오고 신용은 가
온전히 든다 — 선형에서 BP 와 까지 같아졌고, 신용은 파도처럼 0.489 층/스텝(이론 0.5)으로 퍼져 126층을
249 스텝, 곧 에 건넜다. 비선형 잔차 망 깊이 128 에서도 로 가장 먼 층의 코사인이 PC 0.030.17 대 PC-ALM 0.900.96
이었다. 다만 비선형에서 오래 돌리면 오히려 멀어졌으니 은 “평형”이 아니라 “잘 고른 조기 종료”이고, 메모리는 2배, 가중치
전치 문제는 그대로이며, 1,000층은 논문이 아닌 해설 글의 MNIST 결과다.
참고
- Seely & Gould — Augmented Lagrangian Predictive Coding (arXiv:2605.31022, 2026-05-29) — 논문 원문, 명제 3·확산/탄도 분석
- Sakana AI — PC-ALM 해설 글 — 1,000층 결과가 소개된 공식 해설
- GitHub — SakanaAI/pc-alm — 공식 코드
- MarkTechPost — Sakana AI Researchers Introduce PC-ALM (2026-09-14) — 기준 칸 정확도(78.66 / 68.13 / 77.75%)와 1,000층 설정
- 관련 글: 강의 05. 딥러닝 수학 — 순전파와 역전파