인지야공/딥러닝 기초 정리/15번째 글
KV 캐시와 추론 — 생성은 왜 메모리에 묶이나
실행:
python NN_15_kv_cache.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. Jev 편에서 본 “생성 비용”을, 그 비용을 줄이는 장치로 잇는다.
Jev 편에서 자기회귀 생성이 토큰을 하나씩 만들어 비싸다는 걸 봤다. 그런데 실제 LLM 은 그 한 스텝을 영리하게 싸게 만든다 — KV 캐시다. 이 글은 캐시가 무엇을 아끼는지, 그 대가로 왜 생성이 계산이 아니라 메모리에 묶이는지를 잰다.
1. 문제 — 매 스텝 과거를 다시 계산한다
자기회귀 생성은 토큰 를 만들 때 지금까지의 모든 토큰을 봐야 한다(어텐션 편의 어텐션). 순진하게 하면, 새 토큰마다 전체 시퀀스를 처음부터 다시 신경망에 통과시킨다.
토큰 하나 늘 때마다 처리할 길이가 1씩 늘어, 개를 만들면 에 비례하는 일을 한다(어텐션 점수까지 세면 ). 앞부분은 이미 계산했는데 매번 똑같이 다시 계산하는 게 낭비다.
직접 재 보기 A
작은 GPT 로, 생성하며 망을 통과시킨 토큰 수(= 일한 양, FLOPs 에 비례)를 셌다. (토이 모델이라 벽시계는 토큰별 파이썬 오버헤드에 가려지므로, 알고리즘의 진짜 비용인 ‘일한 양’을 센다.)
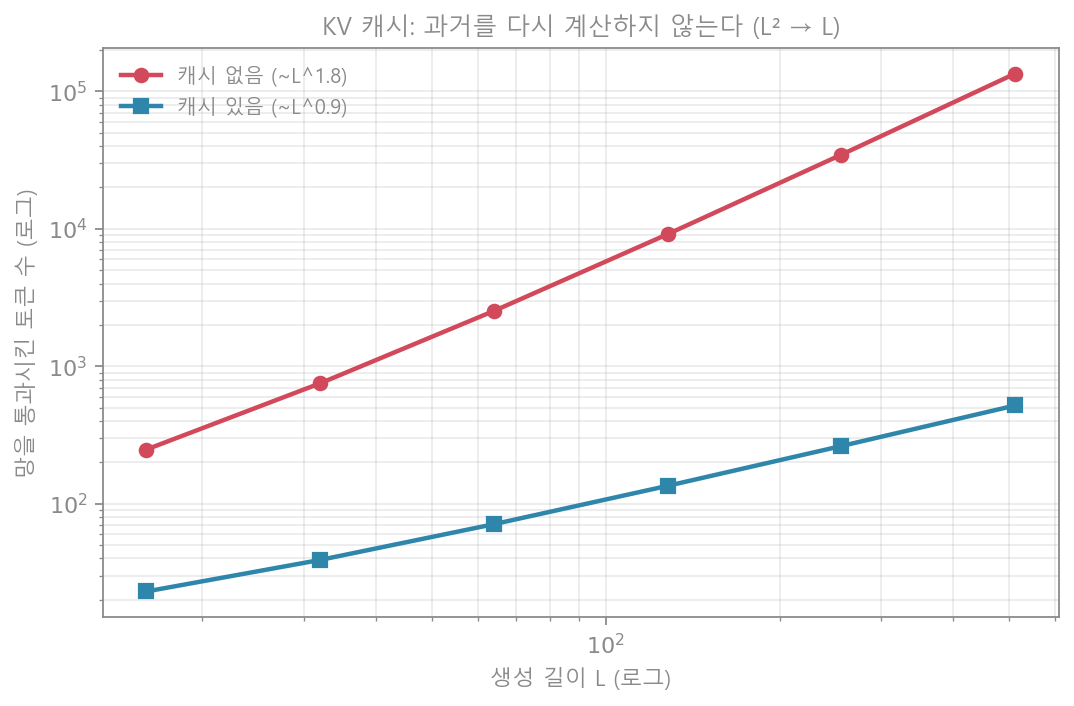
| 생성 길이 | 16 | 64 | 128 | 256 | 512 |
|---|---|---|---|---|---|
| 캐시 없음 (토큰 처리) | 248 | 2,528 | 9,152 | 34,688 | 134,912 |
| 캐시 있음 (토큰 처리) | 23 | 71 | 135 | 263 | 519 |
| 배율 | 10.8× | 35.6× | 67.8× | 131.9× | 259.9× |
캐시 없이는 (≈)로 폭증해, 에서 260배 더 일했다. 캐시가 있으면 (거의 선형)다. 무엇이 다른가.
2. KV 캐시 — 과거의 K·V를 저장한다
어텐션에서 각 토큰은 쿼리 Q·키 K·값 V 세 벡터를 만든다(어텐션 편). 새 토큰이 과거를 볼 때 필요한 것은 과거의 K·V 인데, 그건 한 번 계산하면 안 변한다. 그러니 버리지 말고 저장(캐시) 해 두면 된다.
| 기호 | 뜻 |
|---|---|
| 새 토큰 하나의 Q·K·V | |
| 캐시에 저장해 둔 과거의 K·V | |
| 이어 붙이기 — 새 k·v 만 캐시에 추가 |
이제 매 스텝 새 토큰 하나만 신경망에 통과시키고(FFN·투영 전부), 과거는 캐시에서 꺼내 어텐션만 한다. 그래서 1절의 “일한 양”이 로 줄었다. 과거를 다시 만들지 않는 것이 핵심이다.
3. 대가 — 캐시가 메모리를 먹는다
공짜가 아니다. 캐시는 모든 층·모든 헤드의 과거 K·V 를 전부 들고 있어야 한다. 그 크기는:
| 기호 | 뜻 |
|---|---|
| K 와 V | |
| 층 수, KV 헤드 수, 헤드 차원 | |
| 문맥 길이 (토큰 수) — 여기에 선형 | |
| 배치 크기 |
문맥 길이 에 정비례한다는 게 핵심이다. 문맥이 길어질수록 캐시가 끝없이 커진다.
직접 재 보기 B
70B급 설정(층 80, 헤드 64, 헤드차원 128, fp16)에서 문맥 길이별 캐시 크기를 계산했다.
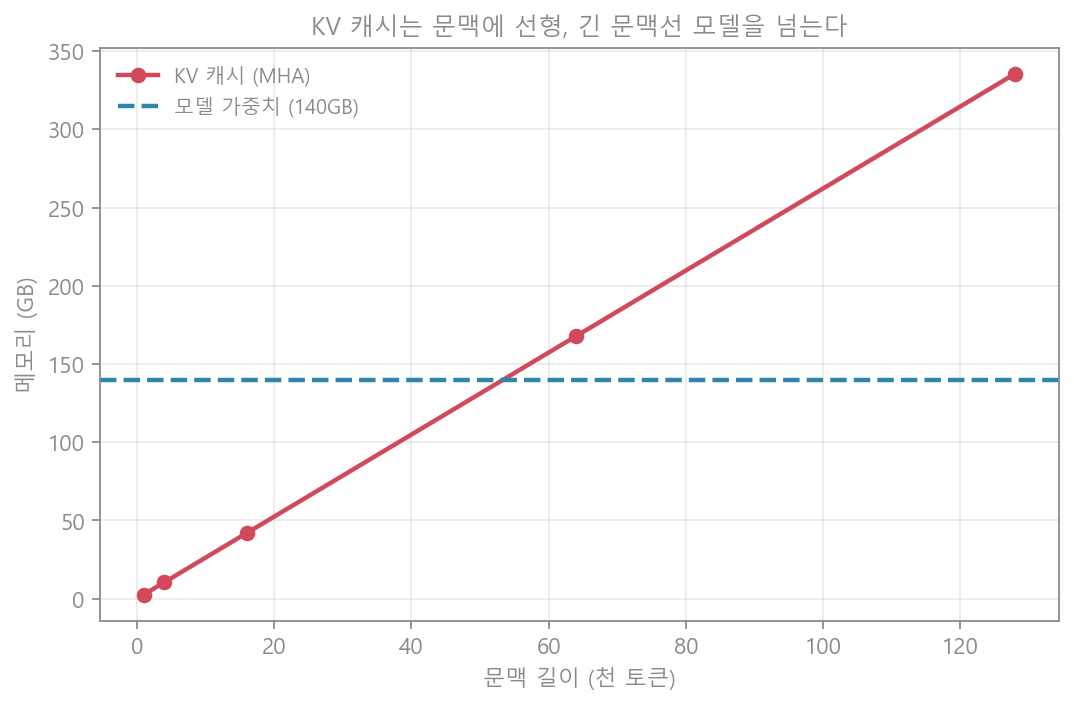
| 문맥 길이 | 1K | 16K | 64K | 128K |
|---|---|---|---|---|
| KV 캐시 | 2.6 GB | 41.9 GB | 167.8 GB | 335.5 GB |
| 모델(140GB) 대비 | 2% | 30% | 120% | 240% |
64K 토큰이면 캐시(168GB)가 모델 가중치(140GB)를 넘어선다. 그래서 생성은 메모리 대역폭에 묶인다 — 토큰 하나를 만들 때마다 모델 가중치 더하기 이 거대한 캐시를 전부 메모리에서 읽어야 하기 때문이다. 계산할 FLOPs 는 적은데(토큰 하나) 읽을 게 많아, GPU 가 계산이 아니라 읽기를 기다린다. 긴 문맥 LLM 이 비싸고 느린 진짜 이유다.
4. 해법 — KV 헤드를 줄인다 (GQA·MQA)
캐시 크기 식에서 우리가 줄일 수 있는 건 (KV 헤드 수)다. 쿼리 헤드는 그대로 두되, 여러 쿼리 헤드가 K·V 를 공유하게 만든다.
- MHA(기존): 쿼리 헤드마다 K·V (여기선 64개).
- GQA(그룹 쿼리): 몇 개 그룹이 K·V 공유 (예: 8개).
- MQA(멀티 쿼리): 모든 쿼리가 K·V 하나 공유 (1개).
직접 재 보기 C
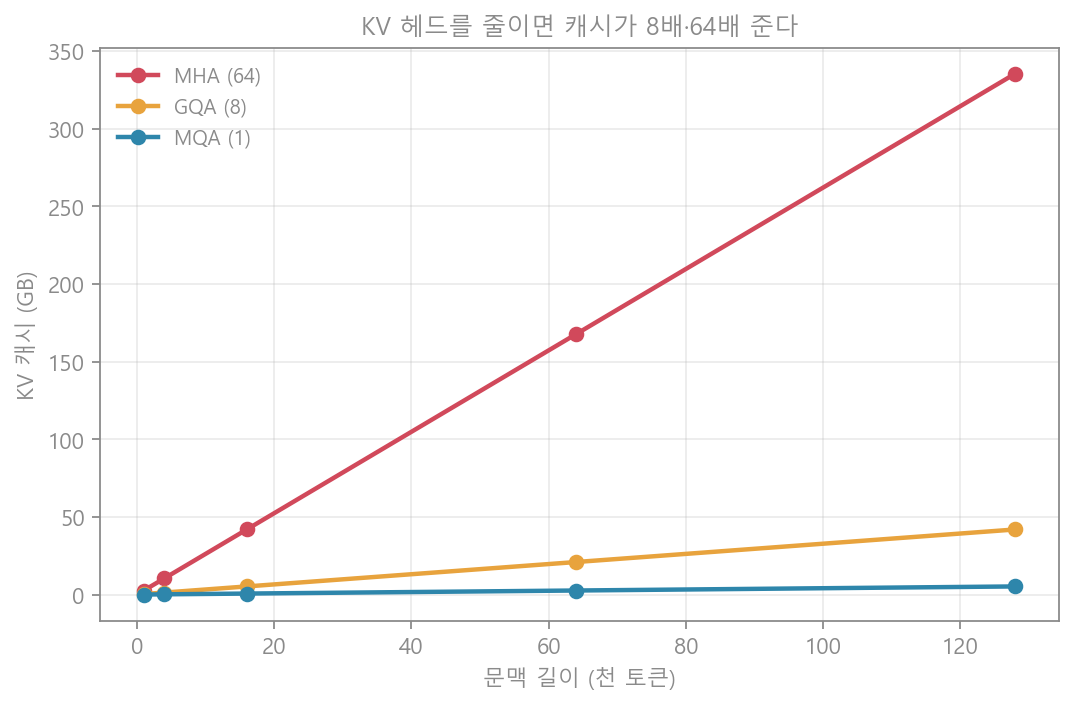
| 방식 | KV 헤드 | 128K 토큰 캐시 | MHA 대비 |
|---|---|---|---|
| MHA | 64 | 335.5 GB | 1× |
| GQA | 8 | 41.9 GB | 1/8 |
| MQA | 1 | 5.2 GB | 1/64 |
KV 헤드를 64→8 로 줄이면 캐시가 8배 준다. GQA 는 이렇게 캐시를 확 줄이면서도 품질은 거의 유지돼(쿼리 헤드는 그대로라 표현력 손실이 작다), 요즘 큰 모델(LLaMA·Mistral 등)의 기본이 됐다. MQA 는 극단(1/64)이지만 품질 손실이 조금 더 크다.
5. 정리
| 장치 | 무엇을 하나 | 대가/이득 |
|---|---|---|
| KV 캐시 | 과거 K·V 저장 → 새 토큰만 계산 | 일한 양 (260배↓), 대신 메모리 사용 |
| 메모리 병목 | 캐시가 문맥에 선형 | 64K 토큰서 모델 초과 → 생성은 대역폭에 묶임 |
| GQA / MQA | KV 헤드 공유 | 캐시 8배·64배↓, 품질 거의 유지 |
한 문단으로: 자기회귀 생성은 새 토큰마다 과거를 다시 계산하면 로 폭증한다(재 보니 에서 260배). KV 캐시는 과거의 K·V 를 저장해 새 토큰만 계산하게 만들어 이를 선형으로 낮춘다. 대신 캐시는 문맥 길이에 선형으로 커져, 70B 모델에서 64K 토큰이면 캐시(168GB)가 모델 가중치(140GB)를 넘는다 — 그래서 긴 문맥 생성은 계산이 아니라 메모리 대역폭에 묶인다. GQA·MQA 는 KV 헤드를 공유해 캐시를 8배·64배 줄이면서 품질을 지킨다. 스케일링(스케일링 법칙 편)이 학습 비용의 산수라면, KV 캐시는 추론 비용의 산수다.