인지야공/딥러닝 기초 정리/52번째 글
VAE — 압축하는 법에서 만들어 내는 법으로
실행:
python NN_55_vae.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
바로 다음 확산 모델 편은 잡음에서 그림을 되돌려 만든다. 그보다 앞선, 더 단순한 생성 모델이 VAE다. 출발점은 오토인코더다 — 그림을 작은 코드로 압축했다가 다시 복원하는 망이다. 압축을 잘하는 망이면 코드를 아무렇게나 넣어도 그림이 나오지 않을까? 나오지 않는다. 왜 안 되고, 무엇을 바꾸면 되는지를 잰다.
1. 코드가 어디에 있는지 모르면 뽑을 수 없다 — 그림으로 먼저
오토인코더는 복원만 잘하면 되므로 코드를 어디에 둘지 상관하지 않는다. 원마다, 사각형마다 편한 곳에 작게 뭉친다. 그러면 새 그림을 만들려고 코드를 뽑을 때 어디서 뽑아야 할지 모른다. 흔히 쓰는 에서 뽑으면 덩어리 사이의 빈 곳에 떨어진다.
VAE는 두 가지를 바꾼다. 인코더가 코드 한 점 대신 분포(평균 , 표준편차 )를 내고, 그 분포가 에서 멀어지면 벌점을 준다.
| 기호 | 뜻 |
|---|---|
| 그림 (16×16 = 256픽셀) | |
| 코드 (여기서는 8차원) | |
| 인코더가 내는 분포 | |
| 디코더가 코드에서 그림을 복원할 확률 | |
| KL | 두 분포가 얼마나 다른가 (엔트로피와 KL 발산 노트) |
| 벌점의 세기. 이 원래 VAE, 이면 오토인코더와 같아진다 |
오른쪽 식이 재매개변수화다. “분포에서 뽑는다”는 연산은 미분할 수 없지만, 잡음 을 따로 뽑아 으로 쓰면 와 쪽으로 기울기가 흐른다(정규분포 다루기 노트).
2. 직접 재 보기
도형 12종 4,800장으로 학습했다. 인코더와 디코더는 256 → 256 → 128 → 코드 8차원의 MLP다.
만들어 낸 그림이 “도형인가”를 판정하려고, 실제 도형으로 심판 분류기를 따로 학습시켰다(시험 정확도 99.8%). 심판이 한 종류에 0.9 이상 확신하면 “도형으로 읽힘”으로 센다. 실제 도형은 98.9%가 이 기준을 넘는다.
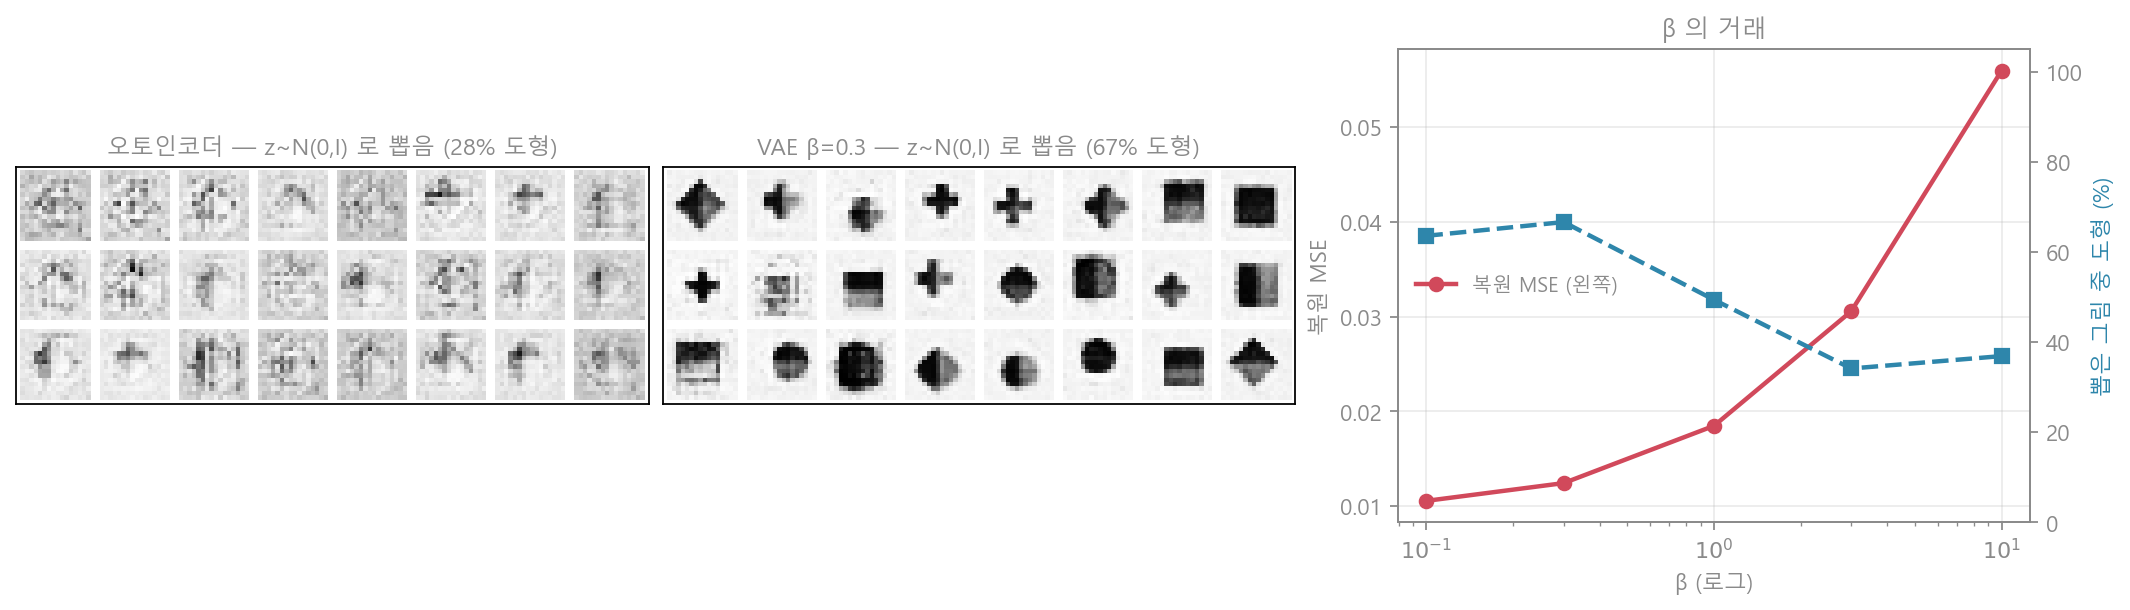
[A] 아무 코드나 넣어 그림을 뽑으면
| 모델 | 복원 오차(MSE) | 코드 평균 크기 | 복원 그림 → 도형 | 그림 → 도형 |
|---|---|---|---|---|
| 오토인코더 | 0.0100 | 4.36 | 90.2% | 27.5% |
| VAE () | 0.0123 | 0.56 | 82.5% | 66.7% |
| VAE () | 0.0185 | 0.55 | 54.5% | 49.4% |
오토인코더는 복원은 가장 잘한다(90.2%). 하지만 에서 뽑은 코드로는 27.5%만 도형이 나온다. 코드의 평균 크기가 4.36이다. 표준정규분포는 대부분 원점에서 1~2 안쪽에 있으니, 뽑은 점이 실제 코드들이 있는 곳에 거의 닿지 않는다.
VAE()는 코드를 0.56 근처로 모았고, 뽑은 그림의 66.7% 가 도형으로 읽혔다. 복원은 조금 내줬다(82.5%).
[B] β의 거래
| 복원 오차 | KL (nat) | 뽑은 그림 → 도형 | |
|---|---|---|---|
| 0.1 | 0.0106 | 16.77 | 63.6% |
| 0.3 | 0.0124 | 11.43 | 66.7% |
| 1.0 | 0.0185 | 6.92 | 49.4% |
| 3.0 | 0.0306 | 3.23 | 34.2% |
| 10.0 | 0.0560 | 0.40 | 36.9% |
(VAE의 복원 오차는 를 한 번 뽑아서 재므로 같은 모델도 잴 때마다 넷째 자리가 흔들린다. [A]의 0.0123과 여기의 0.0124는 같은 모델이다.)
벌점을 세게 걸수록 뽑기 좋아지는 것이 아니었다. 뽑기는 에서 가장 좋았고, 그보다 크면 오히려 나빠졌다.
KL 열이 이유를 말해 준다. KL은 코드에 얼마나 많은 정보를 담았는가의 척도이기도 하다. 에서 KL이 0.40까지 떨어졌다 — 코드가 입력에 대해 거의 아무것도 담지 않는다는 뜻이다. 디코더는 코드를 무시하고 모든 도형의 흐린 평균을 그리게 되고, 그런 그림은 심판이 확신하지 못한다. 가 0에 가까우면 [A]의 오토인코더처럼 코드가 흩어진다. 뽑기 좋은 곳은 그 사이다.
[C] 두 도형 사이를 걸어가면
모양이 다른 두 도형(예: 원과 사각형)의 코드를 잇는 직선을 10등분해서, 가운데 9장이 도형으로 읽히는지 봤다. 200쌍 평균이다.
| 모델 | 중간 그림 → 도형 | 자기 복원 → 도형 (기준) | 기준 대비 |
|---|---|---|---|
| 오토인코더 | 68.5% | 90.2% | 0.76 |
| VAE () | 67.9% | 82.5% | 0.82 |
| VAE () | 48.9% | 54.5% | 0.90 |
처음에는 오토인코더와 VAE만 비교했는데, 오토인코더가 이겼다(68.5% 대 48.9%). “VAE의 코드 공간이 더 매끄럽다”는 설명과 반대다. 그런데 이 판정은 공정하지 않았다. 심판은 선명한 그림에 후하고, VAE는 양 끝의 복원 자체가 54.5%밖에 도형으로 안 읽힐 만큼 흐리다.
그래서 각 모델의 자기 복원 판정률을 기준으로 나눠 봤다. 그러면 순서가 뒤집힌다. 오토인코더는 길 가운데에서 기준의 0.76배로 떨어지고, VAE는 0.82~0.90배를 지킨다. 길 위에서 덜 무너지는 쪽은 VAE다. 다만 절대값으로는 VAE와 오토인코더가 비슷하다(67.9% 대 68.5%). “VAE가 보간이 더 좋다”는 말은 이 정도 크기의 이야기다.
3. 흔한 오해와 한계
1. “오토인코더는 생성 모델이다” — 복원은 하지만 어디서 코드를 뽑을지 정해 두지 않았다. [A]에서 27.5%였다. 생성하려면 코드의 분포를 알아야 하고, VAE는 그것을 로 강제한다.
2. “β를 키울수록 생성이 좋아진다” — [B]에서 이 최선이었고 10에서는 코드가 정보를 잃었다(KL 0.40). 이것을 사후 붕괴(posterior collapse)라 부른다.
3. 판정 기준이 결론을 바꾼다 — [C]에서 “심판의 확신”이라는 기준은 선명함과 그럴듯함을 섞어서 잰다. 기준을 바꾸자 결론이 뒤집혔다. 생성 모델의 평가가 어려운 이유가 이것이다(평가 편).
4. VAE의 그림은 흐리다 — 복원 오차가 와 함께 커지고, 같은 에서도 오토인코더보다 흐리다. 여러 가능성의 평균을 그리기 때문이다. 확산 모델 편은 한 번에 그리는 대신 잡음을 조금씩 걷어 내서 이 흐림을 피한다. 지금 쓰이는 이미지 생성 모델 중 상당수는 VAE로 그림을 작은 코드로 압축한 뒤 그 코드 공간에서 확산을 돌린다.
4. 한 문단 요약
오토인코더는 그림을 코드로 압축했다가 복원하지만 코드를 어디에 둘지 신경 쓰지 않는다. 그래서 복원은 90.2% 도형으로 읽히는데, 에서 뽑은 코드로 만든 그림은 27.5%만 도형이었다. 코드가 원점에서 평균 4.36 떨어져 흩어져 있었기 때문이다. VAE는 인코더가 분포를 내게 하고, 그 분포가 에서 멀어지면 KL 벌점을 줘서 코드를 원점 근처(0.56)로 모은다. 그 결과 뽑은 그림의 66.7%가 도형이 됐다. 벌점의 세기 에는 최적점이 있었다. 에서 가장 좋았고, 에서는 코드가 정보를 잃어(KL 0.40) 흐린 평균만 나왔다. 두 도형 사이를 걸어가는 실험은 판정 기준에 따라 결론이 뒤집혔다. 자기 복원을 기준으로 나누면 VAE가 덜 무너졌지만, 그 차이는 크지 않았다.