인지야공/딥러닝 기초 정리/27번째 글
지식 증류 — 무엇이 옮겨지는가, 그리고 언제 이기는가
실행:
python NN_32_distillation.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 필요한 수학: 엔트로피와 KL 발산 노트.
큰 모델은 좋지만 비싸다(KV 캐시 편 KV 캐시). 그래서 큰 모델(교사)이 아는 것을 작은 모델(학생)에게 옮기는 방법이 오래 쓰였다 — 지식 증류다. 핵심 발상은 간단하다. 정답 라벨은 “3번”이라고만 말하지만, 교사의 확률 분포는 “3번이지만 5번도 꽤 그럴듯하다”까지 말한다.
| 기호 | 뜻 |
|---|---|
| 교사·학생의 확률 분포 | |
| 온도. 높을수록 분포가 펴져 오답 순위가 드러난다 | |
| 교사 쪽에 두는 비중 | |
| 온도를 올리면 기울기가 로 작아져 이를 되돌리는 보정 |
과제는 16×16 도형 12종 분류다. 일부러 네 무리(원·사각·마름모·십자) × 세 변종으로 만들어, “무리 안끼리 닮은” 구조를 넣었다. 교사가 옮길 정보가 바로 거기 있을 것이기 때문이다.
1. 라벨이 충분하면 — 가설이 빗나갔다
먼저 교과서대로 쟀다. 교사(0.66M, 91.2%)를 학습시키고, 같은 데이터로 작은 학생들을 두 방식으로 가르쳤다.
직접 재 보기 A
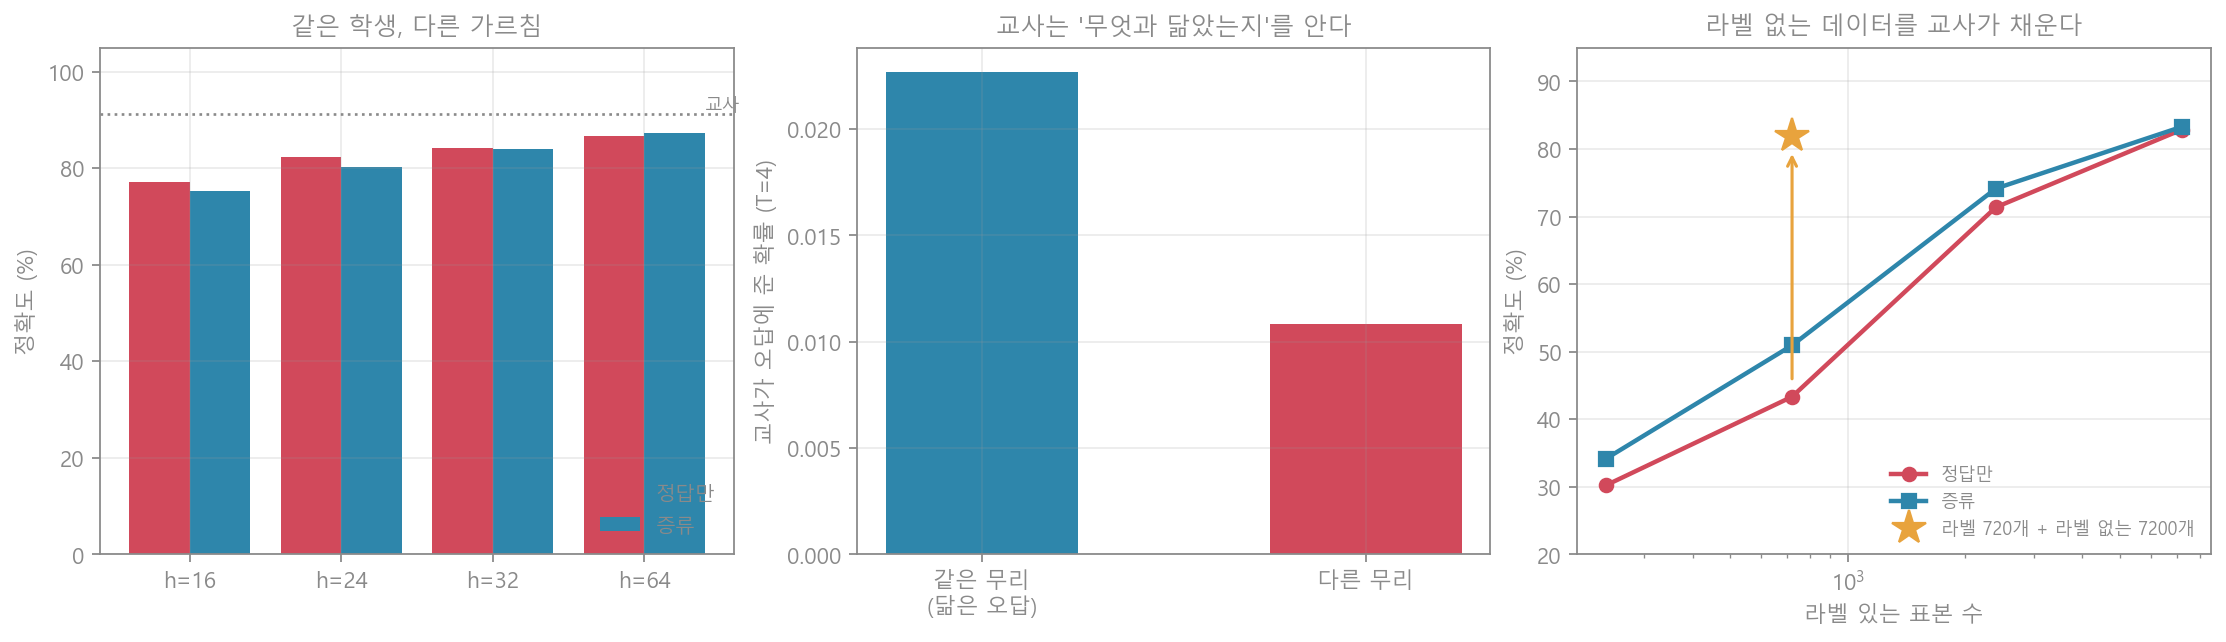
| 학생 크기 | h=16 (4.6K) | h=24 (7.1K) | h=32 (9.7K) | h=64 (21.4K) |
|---|---|---|---|---|
| 정답만 | 77.1% | 82.4% | 84.3% | 86.7% |
| 증류 | 75.3% | 80.2% | 84.0% | 87.4% |
| 차이 | −1.8%p | −2.2%p | −0.3%p | +0.7%p |
예상과 반대다. 작은 학생일수록 증류가 손해였고, 가장 큰 학생에서만 +0.7%p였다.
왜일까. 학습 데이터 7,200개에 이미 정답 라벨이 다 붙어 있다. 교사가 더해 줄 수 있는 것은 “오답들 사이의 순위” 정도인데, 그 정보량은 정답 라벨에 비하면 작다. 게다가 용량이 작은 학생에게는 교사의 분포를 흉내 내는 일 자체가 부담이다 — 정답만 맞히면 되는 문제에, 11개 오답의 확률까지 맞추라는 요구가 얹히기 때문이다. 증류는 공짜 점심이 아니다.
2. 그럼 교사는 무엇을 알고 있나
이득이 작다고 해서 옮길 정보가 없는 건 아니다. 교사가 오답에 준 확률을 무리별로 갈라 봤다.
직접 재 보기 B
| 교사가 오답에 준 평균 확률 () | 값 |
|---|---|
| 같은 무리(닮은 도형) | 0.0227 |
| 다른 무리 | 0.0108 |
| 비율 | 2.1배 |
교사는 “무엇과 닮았는지”를 알고 있다. 원 계열을 보면 다른 원 계열에 2배 높은 확률을 준다. 이것이 “어두운 지식(dark knowledge)“이라 불리는 것이고, 원-핫 라벨에는 전혀 없는 정보다 (엔트로피 노트: 원-핫의 엔트로피는 0이다).
온도를 바꿔 가며 학생(h=24)을 가르쳐 봤다.
| 온도 | 1.0 | 2.0 | 4.0 | 8.0 |
|---|---|---|---|---|
| 학생 정확도 | 82.4% | 81.8% | 80.2% | 79.3% |
온도를 올릴수록 나빠졌다. 이것도 교과서와 반대인데, 1절과 같은 이유다 — 라벨이 충분한 상황에서 온도를 올리는 것은 정답 신호를 흐리게 만드는 쪽으로만 작용한다. 온도가 이기려면 옮길 정보가 정답보다 귀한 상황이어야 한다.
3. 증류가 진짜 이기는 곳 — 라벨 없는 데이터
그 상황은 라벨이 귀할 때다. 라벨 양을 줄여 가며 다시 쟀다.
직접 재 보기 C
| 라벨 수 | 240 | 720 | 2,400 | 7,200 |
|---|---|---|---|---|
| 정답만 | 30.2% | 43.3% | 71.4% | 82.9% |
| 같은 데이터에 증류 | 34.2% | 50.9% | 74.1% | 83.3% |
| 차이 | +3.9%p | +7.6%p | +2.8%p | +0.4%p |
라벨이 적을수록 이득이 커진다(720개에서 +7.6%p). 그런데 진짜는 그다음이다. 현실에서 부족한 것은 라벨이지 데이터가 아니다. 그래서 학생에게 라벨 720개 + 라벨이 전혀 없는 7,200개를 주고, 라벨 없는 쪽은 교사의 분포만 보고 배우게 했다().
| 정확도 | |
|---|---|
| 라벨 720개만 | 43.3% |
| 라벨 720개 + 라벨 없는 7,200개(교사) | 81.9% (+38.6%p) |
| (참고) 같은 학생이 진짜 라벨 7,200개를 받았을 때 | 82.9% |
| (참고) 교사 | 91.2% |
43.3%가 81.9%가 됐다. 그리고 이 값은 진짜 라벨 7,200개를 전부 받은 학생(82.9%)과 1%p 차이다. 즉 교사는 라벨 없는 데이터를 라벨 있는 데이터로 바꿔 주는 장치로 작동했다. 라벨 6,480개를 사람이 붙이는 대신 교사가 붙인 셈이고, 거의 같은 결과를 냈다.
여기가 증류의 자리다. 오늘날 작은 모델들이 큰 모델의 출력으로 학습되는 이유, 그리고 그 출력을 라벨 없는 대량의 입력에 붙여 쓰는 이유가 이것이다.
4. 흔한 오해와 한계
- “증류하면 항상 좋아진다” — 아니다. 라벨이 충분하면 이득이 없거나 손해였다(1절, −2.2%p).
- “온도는 높을수록 좋다” — 아니다(2절). 온도는 옮길 정보가 귀할 때 그 정보를 드러내는 손잡이이고, 아니면 정답을 흐릴 뿐이다.
- “학생이 교사를 넘을 수 있다” — 이 실험에서는 못 넘었다(81.9% vs 91.2%). 증류의 천장은 대체로 교사다. 그래서 교사의 편향과 오류도 함께 옮겨진다.
- “작게 만들면 다 싸진다” — 학생을 키우면 교사와의 격차가 줄지만(3.8%p) 그만큼 비싸진다. 양자화 편·LoRA 편와 함께 무엇을 줄일지 고르는 문제다.
- 이 글의 실험 — 12종 도형이라는 장난감이고, 교사도 0.66M짜리다. +38.6%p 같은 수는 이 설정의 값이고, 요점은 증류가 옮기는 것은 오답의 순위이며, 그것이 정답 라벨보다 귀할 때만 이긴다는 구조다.
5. 한 문단 요약
지식 증류는 교사의 확률 분포로 학생을 가르친다. 교사는 실제로 “무엇과 닮았는지”를 알고 있었다 — 같은 무리의 오답에 2.1배 높은 확률을 줬다. 그런데 라벨이 충분한 상황에서는 그 정보가 정답 라벨에 밀려, 작은 학생에게는 오히려 −2.2%p 손해였고 온도를 올릴수록 더 나빠졌다. 증류가 이기는 자리는 라벨이 귀한 곳이다. 라벨 720개짜리 학생에게 라벨 없는 데이터 7,200개를 교사와 함께 주자 43.3%가 81.9%가 됐고, 이는 진짜 라벨 7,200개를 받은 학생(82.9%)과 거의 같다. 증류의 정체는 “작게 만들기”보다 라벨 없는 데이터를 라벨로 바꾸기에 가깝다.