인지야공/수학·공학 노트/12번째 글
평균의 분산 — 여럿을 모아도 줄지 않는 부분
실행:
python 딥러닝/mathnotes/M12_ensemble_variance.py앙상블 편의 ‘천장’이 어디서 오는가를 정리한다.
1. 1/n 은 조건부 약속이다
“여러 번 재서 평균내면 오차가 줄어든다”는 말은 절반만 맞다. 정확한 식은 이렇다.
| 기호 | 뜻 |
|---|---|
| 번째 모델의 오차 | |
| 오차 하나의 분산 | |
| 서로 다른 두 모델 오차의 상관계수 | |
| 모아서 평균내는 모델의 수 |
오른쪽 항 만 으로 나뉘어 사라지고, 왼쪽 항 는 그대로 남는다. 즉 모델을 무한히 모아도 분산은 0이 아니라 에서 멈춘다. 흔히 인용되는 은 일 때의 특수한 경우다.
직관은 간단하다. 각 모델의 오차를 모두가 공유하는 부분과 자기만의 부분으로 쪼개면,
평균을 내면 개별 부분 는 서로 지워지지만 공통 부분 는 그대로 살아남는다. 몇 개를 모아도 공통은 공통이다.
2. 직접 재 보기
20만 번씩 돌려 평균의 분산을 쟀다.
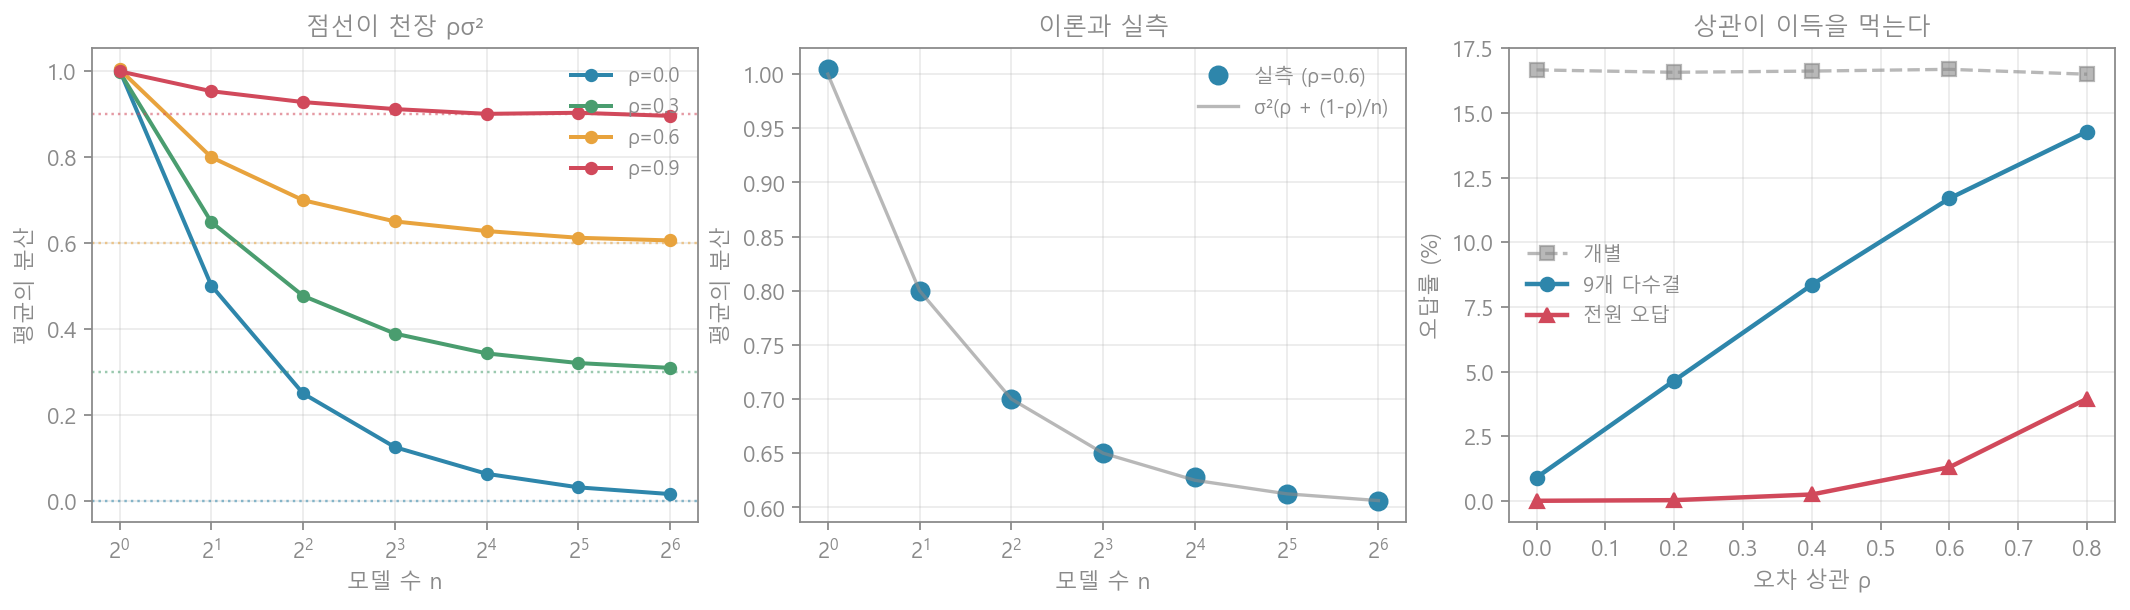
| ρ | n=1 | n=4 | n=16 | n=64 | 천장 ρσ² |
|---|---|---|---|---|---|
| 0.0 | 1.0026 | 0.2498 | 0.0628 | 0.0156 | 0.00 |
| 0.3 | 0.9985 | 0.4770 | 0.3431 | 0.3094 | 0.30 |
| 0.6 | 1.0044 | 0.6997 | 0.6279 | 0.6061 | 0.60 |
| 0.9 | 0.9998 | 0.9282 | 0.9008 | 0.8961 | 0.90 |
은 까지 정직하게 내려가지만, 은 64개를 모아도 0.606이다. 이론식과 실측이 소수 셋째 자리까지 맞는다.
그리고 이것을 분류 오차로 옮기면 앙상블 편에서 본 그 표가 된다. 오답률이 16.7%인 분류기 9개를 상관 로 묶어 다수결시켰다.
| ρ | 개별 오답률 | 9개 다수결 | 전원 오답 |
|---|---|---|---|
| 0.0 | 16.67% | 0.90% | 0.00% |
| 0.4 | 16.62% | 8.35% | 0.24% |
| 0.8 | 16.50% | 14.28% | 3.95% |
이면 다수결이 16.7%를 0.9%로 내린다 — 거의 마법이다. 그런데 이면 14.28%로, 개별과 별 차이가 없다. 같은 실력의 모델 9개인데 틀리는 자리가 겹치느냐만으로 결과가 이만큼 갈린다.
3. 왜 중요한가
- 앙상블 편에서 4개를 넘으니 곡선이 평평해진 것이 바로 항이 이미 작아졌기 때문이다. 남은 은 모델을 더 넣어도 움직이지 않는다. 그 글에서 두 모델이 동시에 틀릴 확률이 무관했을 때의 4.59배였는데, 그것이 곧 가 크다는 뜻이고 천장이 높다는 뜻이다.
- “전원이 틀리는 8.3%“의 정체도 이것이다. 위 표에서 가 커질수록 전원 오답이 0.00% → 3.95%로 불어나는 것과 같은 현상이다.
- 다양성에 돈을 쓰는 이유가 여기서 정당화된다. 앙상블을 개선하려면 모델을 더 넣는 것(↑)보다 를 낮추는 것이 값어치가 크다. 다만 앙상블 편에서 봤듯 를 낮추는 방법들은 대개 을 키운다(개별 성능이 나빠진다) — 그래서 공짜가 아니다.
4. 한 줄 요약
개를 평균내면 분산이 로 준다는 말은 서로 무관할 때만 맞다. 상관 가 있으면 이라 에서 멈추고, 실측에서 은 64개를 모아도 0.606이었다. 오차의 공통 부분은 몇 개를 모아도 공통이기 때문이다. 앙상블의 천장, 그리고 “전원이 틀리는 문제”가 전부 이 한 항에서 나온다.