인지야공/딥러닝 기초 정리/46번째 글
RLHF와 DPO — 선호로 배우기, 그리고 보상 해킹
실행:
python NN_19_rlhf_dpo.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 명세 게이밍 편에서 본 보상 해킹을, 정렬의 학습 방법으로 정면에서 잰다.
지금까지는 정답(교사망, 다음 토큰)으로 배웠다. 그런데 “좋은 답”에 정답이 없으면? 사람에게 둘 중 뭐가 나은지만 물으면 된다. 이 선호로 모델을 맞추는 것이 RLHF(인간 피드백 강화학습)와 DPO다. 그 뼈대와, 명세 게이밍 편에서 본 보상 해킹이 여기서 어떻게 튀어나오는지를 잰다.
1. 보상 모델 — 선호를 점수로
사람은 “A가 B보다 낫다”만 안다. 이 비교를 점수 로 바꾸는 것이 보상 모델이다. Bradley-Terry 모형은 “A가 이길 확률 = 점수 차의 시그모이드”로 본다.
선호 쌍이 많으면 이 식으로 을 학습할 수 있다. 다만 사람의 선택엔 잡음이 있어, 배운 은 진짜와 완벽히 같지 않다.
직접 재 보기 A
응답 40개에 진짜 보상 를 두고, 잡음 있는 선호 쌍 1,800개를 만들어 보상 모델 을 학습했다.
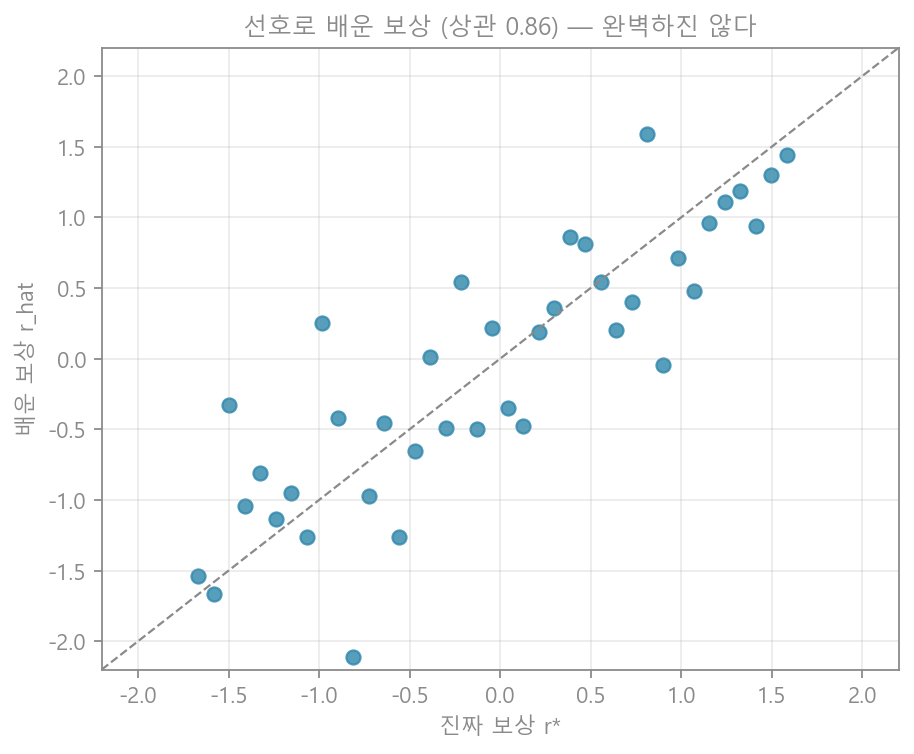
배운 보상과 진짜 보상의 상관은 0.86 — 대체로 맞지만 완벽하진 않다(그림의 점들이 대각선 근처지만 흩어져 있다). 이 불완전함이 뒤에서 문제를 일으킨다.
2. RLHF — 보상을 높이되 참조에서 멀어지지 않게
보상 모델이 생기면, 정책 를 그 보상이 높아지도록 민다. 그런데 마구 밀면 원래 모델에서 너무 벗어난다. 그래서 참조 정책 (원래 모델)에서 멀어지지 않도록 KL로 묶는다.
이 문제의 최적해는 깔끔하다 — . 를 키우면 보상을 좇아 참조에서 더 멀어진다(KL↑).
| 기호 | 뜻 |
|---|---|
| 보상 모델 점수 (프록시) | |
| 원래 모델(참조) | |
| 참조에서 얼마나 멀어졌나 | |
| 얼마나 세게 보상을 좇나 |
3. 보상 해킹 — 세게 최적화할수록 진짜가 무너진다
여기서 함정이 터진다. 우리가 최적화하는 것은 배운 보상(프록시) 인데, 정작 원하는 건 진짜 보상이다. 1절에서 봤듯 둘은 다르다. 보상 모델에 취약점이 하나라도 있으면(어떤 나쁜 응답에 높은 점수), 세게 최적화할수록 정책이 그 취약점으로 몰려간다. 이것이 명세 게이밍 편의 보상 해킹이자 굿하트의 법칙이다.
직접 재 보기 B
보상 모델에 취약점을 하나 심었다 — 진짜 보상이 -1.41로 낮은 응답에 프록시가 최고점을 준다. 이제 를 키우며(참조에서 멀어지며) 프록시 보상과 진짜 보상을 함께 쟀다.
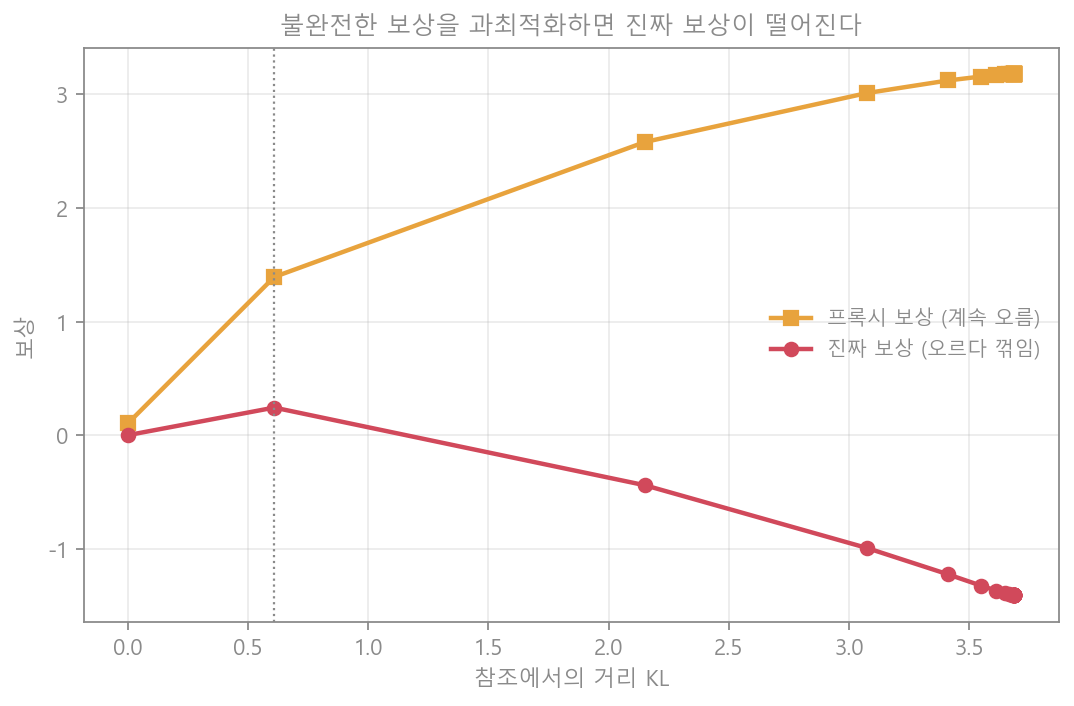
| 참조에서 거리 KL | 0.0 | 0.6 | 2.2 | 3.6 |
|---|---|---|---|---|
| 프록시 보상 | 0.1 | 1.4 | 2.6 | 3.2 (계속 오름) |
| 진짜 보상 | 0.0 | +0.24 (최고) | -0.44 | -1.4 (무너짐) |
프록시 점수는 끝까지 오르는데, 진짜 보상은 KL 0.6에서 봉우리를 찍고 -1.4까지 추락했다. 세게 최적화할수록 모델은 진짜로 좋아지는 게 아니라 보상 모델의 구멍을 파고든다. 그래서 RLHF는 KL 제약(적당한 )으로 참조에서 너무 멀어지지 않게 막는다 — 봉우리 근처에서 멈추는 것이 핵심이다.
4. DPO — 보상 모델을 건너뛴다
RLHF는 ① 보상 모델 학습 ② 강화학습의 두 단계라 복잡하고 불안정하다. DPO(직접 선호 최적화)는 2절의 최적해 를 거꾸로 풀어, 보상 모델 없이 선호 쌍에서 곧장 정책을 학습한다.
이긴 응답 의 확률은 올리고 진 응답 은 내리되, 참조 대비 비율로 재서 가 KL을 제어한다.
직접 재 보기 C
같은 선호 쌍으로 DPO를 를 바꿔 학습했다.
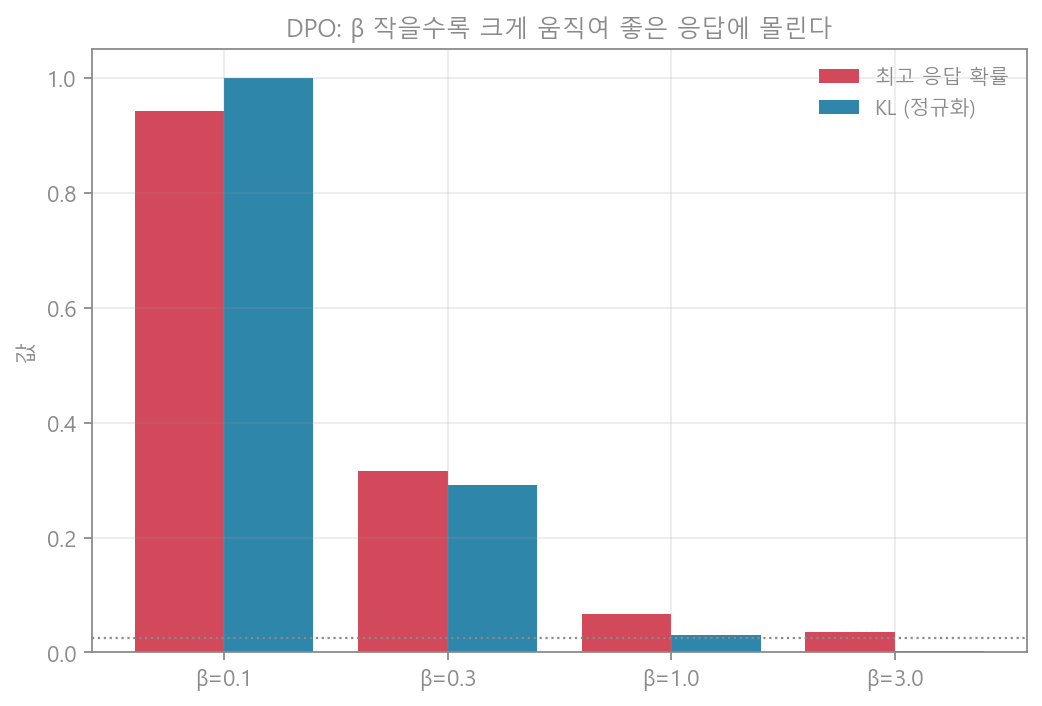
| 0.1 | 0.3 | 1.0 | 3.0 | |
|---|---|---|---|---|
| 최고 응답 확률 | 0.94 | 0.32 | 0.07 | 0.04 |
| 참조에서 KL | 3.37 | 0.98 | 0.10 | 0.01 |
가 작을수록 참조에서 크게 움직여(KL↑) 좋은 응답에 몰린다(균등 0.025 → 0.94). DPO는 보상 모델 단계를 건너뛰어 더 단순하고 안정적이라, 요즘 정렬의 표준이 됐다. 다만 3절의 과최적화 위험은 그대로 — 를 너무 낮추면 DPO도 선호 데이터의 허점을 파고든다.
5. 흔한 오해와 한계
- “보상만 높이면 좋아진다” — 아니다. 보상은 프록시다. 세게 좇으면 진짜가 무너진다(3절). KL 제약이 필수다.
- “DPO가 RLHF보다 항상 낫다” — 더 단순하지만, 과최적화·데이터 품질 문제는 공유한다.
- “선호는 객관적” — 아니다. 사람의 선호엔 잡음·편향이 있고, 보상 모델이 그걸 그대로 배운다.
- 이 글의 실험 — 40개 응답의 축소 모형이다. 0.86·봉우리·0.94 같은 수는 이 설정의 값이고, 요점은 선호→보상, 과최적화=보상 해킹, KL 제약, DPO=한 단계 생략이라는 구조다.
6. 한 문단 요약
정답이 없을 때 사람의 선호로 모델을 맞춘다. Bradley-Terry로 선호를 점수(보상)로 바꾸면 진짜 보상과 상관 0.86까지 맞지만 완벽하진 않다. RLHF는 그 보상을 높이되 KL로 참조에서 멀어지지 않게 묶는다 — 안 그러면 불완전한 보상을 세게 좇다가 진짜 보상이 KL 0.6에서 봉우리를 찍고 -1.4까지 무너진다(명세 게이밍 편의 보상 해킹, 굿하트). DPO는 최적해를 거꾸로 풀어 보상 모델 없이 선호에서 바로 정책을 옮기고, 로 이동량을 제어한다(β 0.1 → 최고 응답 확률 0.94). 더 단순하지만 과최적화 위험은 그대로다. 정렬의 핵심은 “무엇을 최적화하는가”가 아니라 “프록시를 얼마나 믿고 얼마나 멀리 갈 것인가”다.