인지야공/딥러닝 기초 정리/29번째 글
루프 트랜스포머 — 깊이를 파라미터가 아니라 시간으로 사는 법
실행:
python 06_looped_transformer.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 중간에 내 가설이 하나 틀렸고, 틀린 채로 두는 대신 재서 반증했다. 4장이 그것이다.
2026년 9월 4일 공개된 GPT-6 아스트라를 두고 “순환 심도(recurrent depth)”, “루프 트랜스포머(looped transformer)” 라는 말이 돌았다. 무엇을 바꾼다는 것인지 개념부터 정리하고, 작은 모형으로 직접 재 본다.
먼저 못 박아 둘 것이 있다. 아스트라가 이 구조를 쓴다는 것은 오픈AI가 확인해 준 적이 없다. The Information 보도와 정황뿐이고, 오히려 오픈AI 수석 과학자는 “아스트라를 포함한 최신 모델의 계산 그래프 깊이는 GPT-4 의 2배 이내”라고 말했다. 그러니 아래는 아스트라 해설이 아니라, 아스트라를 계기로 다시 주목받은 한 아키텍처의 정리다.
1. 표준 트랜스포머에서 깊이는 곧 파라미터다
층을 이라 하면 표준 트랜스포머는 이렇게 생겼다.
핵심은 아래첨자다. 층마다 가중치 이 따로 있다. 그래서
파라미터와 계산량이 둘 다 에 비례해서 같이 움직인다. 더 깊게 생각하게 하려면 가중치를 그만큼 더 사야 하고, 다 산 뒤에는 시험할 때 깊이를 바꿀 수 없다. 24층 모델은 쉬운 질문에도 24층을 쓰고, 어려운 질문에도 24층까지밖에 못 쓴다.
2. 루프 트랜스포머 — 아래첨자를 지운다
Geiping 등의 논문(arXiv:2502.05171)이 쓰는 구조는 세 부분이다.
의 아래첨자에 가 없다. 몇 바퀴를 돌든 같은 가중치다. 그래서
파라미터와 계산량이 분리된다. 이 한 줄이 이 구조의 전부이고, 나머지는 전부 이것의 따름결과다.
매 바퀴 를 다시 넣는 이유 (input injection)
로 두면 안 되는가? 안 된다. 그러면 는 자기 자신만 보고 굴러가는 자율 시스템이 되어, 바퀴가 늘수록 원래 입력에서 멀어진다. 논문이 “안정성에 필수”라고 못 박은 대목이다. 실제 구현은 이렇게 한다.
매 바퀴 문제지를 다시 펴 놓고 푼다고 생각하면 된다. 안 그러면 몇 번 굴리다가 문제가 뭐였는지 잊는다.
가중치를 공유하면 기울기는 어떻게 되나
같은 가 계산 그래프에 번 등장하므로, 기울기는 개 항의 합이 된다.
이걸 다 저장하면 메모리가 에 비례해 터진다. 그래서 논문은 마지막 바퀴만 역전파한다(truncated BPTT).
덕분에 메모리가 과 무관해진다. 32바퀴를 돌리든 64바퀴를 돌리든 학습 메모리는 8바퀴어치다. 학습 중 은 log-normal Poisson 분포에서 매번 새로 뽑는다 — 시험 때 사용자가 아무 이나 고를 수 있게 하려면, 학습 때 여러 을 겪어 봐야 한다.
3. 직접 재 보기 — 무엇을 과제로 삼을까
“깊이가 늘면 더 잘 푼다”를 보이려면 깊이가 실제로 필요한 과제여야 한다. 여기서는 그래프 도달 가능성(reachability) 을 쓴다.
노드 16개. 노드마다 나가는 화살표가 정확히 하나.

  입력  p[0..15]   p[i] = i 번 노드가 가리키는 노드
  정답  y[0..15]   y[i] = 0번에서 출발해 i 번에 닿을 수 있는가 (0/1)

  예) p = [7, 1, 2, 9, 7, 10, 15, 9, 6, 15, 2, 11, 2, 13, 11, 6]
      y = [1, 0, 0, 0, 0, 0, 1, 1, 0, 1, 0, 0, 0, 0, 0, 1]   ← 0→7→9→15→6 (반경 4)
용어 — 홉(hop)
아래부터 홉이라는 말을 쓴다. 영어 hop 을 그대로 옮긴 것으로, 화살표 하나를 건너는
것이 한 홉이다. 패킷이 라우터를 하나 거칠 때마다 한 홉이라고 세는 네트워크 용어에서
왔고(traceroute 가 찍어 주는 그 수다), 그래프 문헌에서도 k-hop 이라는 표현으로 늘 쓴다.
위 예제로 보면 이렇다.
| 뜻 | 값 | |
|---|---|---|
| 0홉 집합 | 출발점만 | {0} |
| 1홉 집합 | 화살표 한 번 이내 | {0, 7} |
| 2홉 집합 | 화살표 두 번 이내 | {0, 7, 9} |
| 3홉 집합 | {0, 7, 9, 15} | |
| 4홉 집합 | 더 늘지 않는다 | {0, 6, 7, 9, 15} ← 정답 |
“홉 집합”은 화살표를 번 이하로 따라가 닿는 노드들이고, “한 홉 퍼뜨린다”는 지금 닿은 노드 전부에서 화살표를 한 번씩 따라가 새로 닿는 곳을 보태는 것(BFS 한 단계)이다.
닮은 말이 셋 나오는데, 둘은 문제 쪽이고 하나는 모델 쪽이라 섞으면 안 된다.
| 말 | 어느 쪽 | 뜻 |
|---|---|---|
| 홉 | 문제 | 그래프에서 화살표 한 번 |
| 반경 | 문제 | 답이 완성되기까지 필요한 홉 수 |
| 바퀴 | 모델 | 블록을 한 번 적용 |
이 글의 설계가 노리는 것이 바로 한 바퀴에 한 홉이다. 모델이 쓰는 계산량과 문제가 요구하는 깊이가 1:1로 맞아야, “몇 바퀴 돌렸나”가 “얼마나 깊이 생각했나”의 정직한 눈금이 된다.
이 과제를 고른 이유가 셋이다.
- 답이 고정점이다. 더 이상 새로 닿는 곳이 없으면 그 뒤로는 아무리 퍼뜨려도 답이 안 변한다. . 그래서 “다 풀었다”는 순간이 정의된다.
- 난이도가 문제마다 다르다. 도달 반경 이 1일 수도 12일 수도 있다.
- 입력 길이가 항상 16으로 고정이다. 이게 결정적이다. 처음에는 사슬 길이가 변하는 과제를 썼는데, 학습에서 본 적 없는 위치가 나오는 바람에 길이 외삽 실패와 깊이 외삽 실패가 뒤엉켜 아무것도 못 보여줬다. 길이를 고정하니 깊이만 남았다.
⚠ 중첩 편에서 고침 (2026-09-12) — 이 과제를 “도달 가능성”이라고만 부른 것이 느슨했다. 위 생성 코드는
p[i]가 노드마다 하나다. 나가는 화살표가 하나뿐인 함수 그래프이고, 그러면 0번에서 뻗는 길이 외길이 된다. 결과가 둘이다.
- 복잡도가 다르다. 일반 유향 그래프의 s-t 도달성은 NL-complete 지만, 함수 그래프의 도달성은 유일한 경로를 따라가면 끝난다 — 지금 노드와 걸음 수만 들고 있으면 되므로 L(결정적 로그 공간) 안에 있다. 스크립트 주석에 “NL-complete” 라고 쓴 것은 틀렸다.
- BFS 전선 폭이 언제나 1이다. 한 단계에 새로 닿는 노드가 늘 한 개다(실측 평균 1.00, 최대 1). 이 성질이 잠재 반복 vs 토큰 사슬 편의 결론을 통째로 망가뜨린다 — 자세한 것은 중첩 편에 있다.
아래 측정값은 전부 그대로 유효하다. 틀린 것은 과제를 고른 근거의 서술이지, 재서 얻은 숫자가 아니다. 5장의 포인터 더블링 설명도 함수 그래프에서 오히려 더 잘 맞는다.
두 모델은 완전히 같은 부품(Pre-LN 블록, , 헤드 4개)을 쓰고, 그것을 쌓느냐 돌리느냐만 다르다.
| 파라미터 | |
|---|---|
| 블록 하나 | 49,984 |
| 표준 4층 | 202,242 |
| 표준 12층 | 602,114 |
| 루프 1블록 (몇 바퀴를 돌든) | 60,546 |
손실은 이렇게 준다. 매 바퀴의 출력을 최종 정답으로 감독하되, 아직 바퀴를 못 돈 시점은 뺀다(원리적으로 못 맞히므로). 중간 정답은 알려주지 않는다.
말로 옮기면 “다 풀고 나면 그 뒤로는 가만히 있어라” 가 전부다.
4. 결과 1 — 학습 때 본 적 없는 깊이
표준 4층과 루프 1블록을 똑같이 반경 4 이하로만 학습시켰다. 루프 모델은 학습 중 최대 6바퀴까지만 돌아 봤다. 그리고 반경 12까지 시험한다.
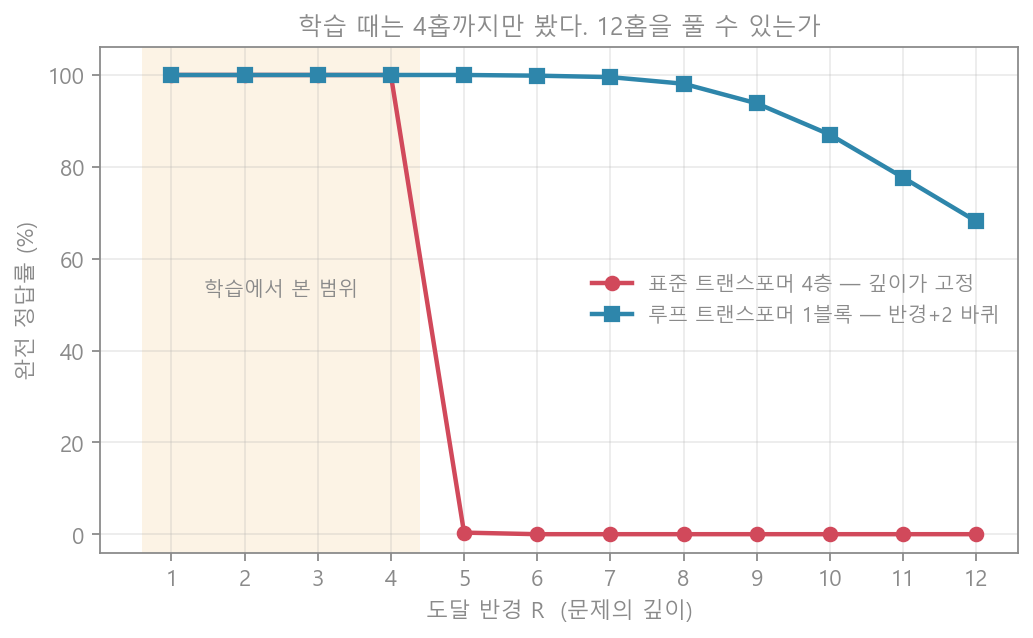
| 도달 반경 | 1–4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 |
|---|---|---|---|---|---|---|---|---|---|
| 표준 4층 | 100% | 0.3% | 0% | 0% | 0% | 0% | 0% | 0% | 0% |
| 루프 1블록 () | 100% | 100% | 99.9% | 99.5% | 98.1% | 93.8% | 87.0% | 77.7% | 68.1% |
(16칸을 전부 맞혀야 정답으로 친 값이다.)
표준 모델은 학습 범위를 벗어나는 순간 0%로 떨어진다. 루프 모델은 학습 때 6바퀴가 최대였는데 시험에서 14바퀴를 돌려 반경 12를 68% 맞힌다. 가중치는 한 글자도 안 바뀌었다. 바뀐 것은 돌린 횟수뿐이다.
이것이 test-time scaling 의 원형이다. 표준 모델이 배운 것은 깊이 4짜리 함수이고, 루프 모델이 배운 것은 한 바퀴에 한 홉 퍼뜨리는 절차다. 함수는 정의역 밖에서 무너지고, 절차는 더 돌리면 더 간다.
5. 결과 2 — 내 가설이 틀렸다
여기서 나는 이렇게 예상했다. “반경 12를 풀려면 12홉을 퍼뜨려야 하니, 표준 모델은 12층쯤 필요할 것이다.” 반경 12까지 전부 학습 데이터로 주고 층 수만 바꿔 재 봤다.
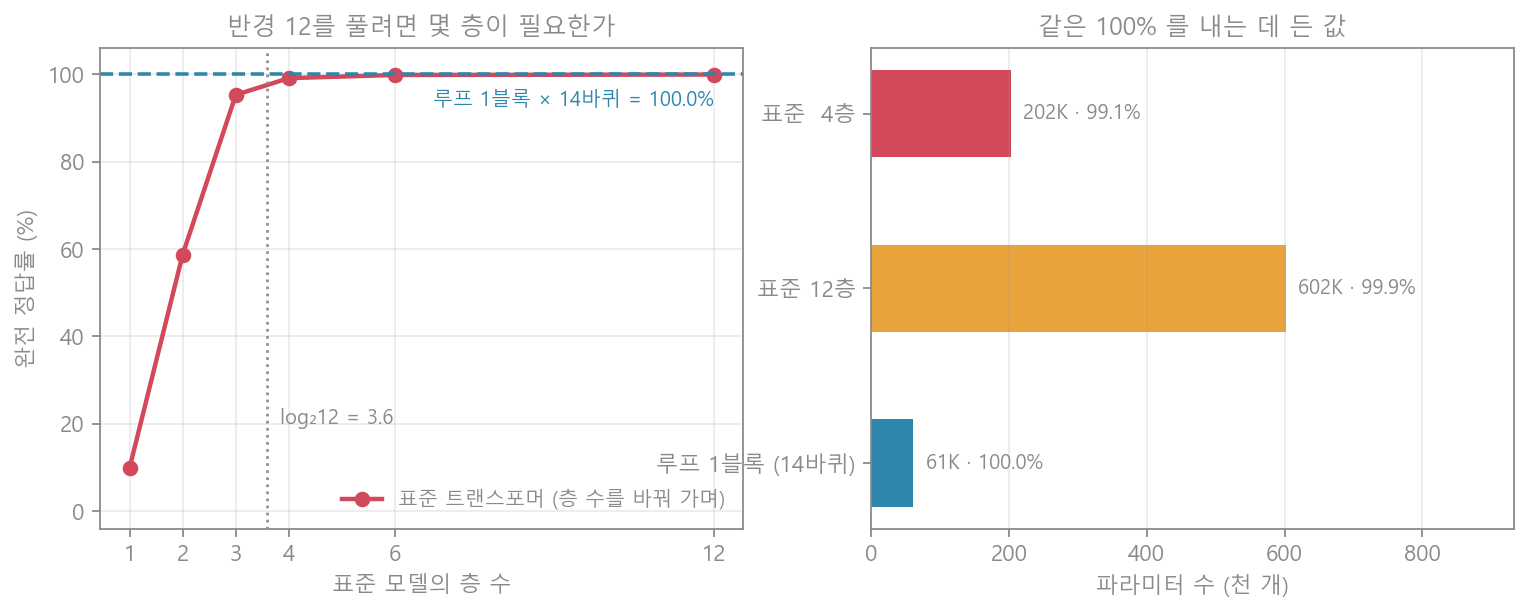
| 층 수 | 1 | 2 | 3 | 4 | 6 | 12 |
|---|---|---|---|---|---|---|
| 파라미터 | 52K | 102K | 152K | 202K | 302K | 602K |
| 정확도 | 9.9% | 58.7% | 95.3% | 99.1% | 99.8% | 99.9% |
3층에서 이미 95%다. 12층은 필요 없었다. 왜인가 — 어텐션은 전역이라 한 층이 “내가 가리키는 곳이 가리키는 곳”을 한 번에 볼 수 있다. 즉 한 층마다 도달 거리를 두 배로 늘릴 수 있다(포인터 더블링). 그러면 필요한 깊이는 이 아니라
이고, 실제로 곡선이 꺾이는 자리가 정확히 거기다. 도달 가능성은 NL 안에 있는 문제라 깊이면 풀린다는 이론과도 맞는다.
그래서 정정한다. 루프가 이기는 이유는 “더 깊이 갈 수 있어서”가 아니다. 같은 100%를
- 표준 12층은 602K 파라미터로,
- 루프 1블록은 61K 파라미터로 (약 10배 적게)
낸다. 차이는 성능이 아니라 값이다. 그리고 4장에서 봤듯, 값이 싼 쪽이 덤으로 “학습 범위 밖으로 더 돌릴 수 있는” 성질까지 가져간다.
6. 결과 3 — 언제 멈출지 모델이 스스로 안다
루프 모델의 진짜 매력은 여기 있다. 몇 바퀴 돌지를 사람이 정해 줄 필요가 없다. 논문이 쓰는 종료 조건은 연속한 두 바퀴의 출력 분포가 얼마나 달라졌는가다.
더 돌려도 답이 안 바뀌면 다 푼 것이다. 반경 12까지 학습한 루프 모델로 재 봤다.
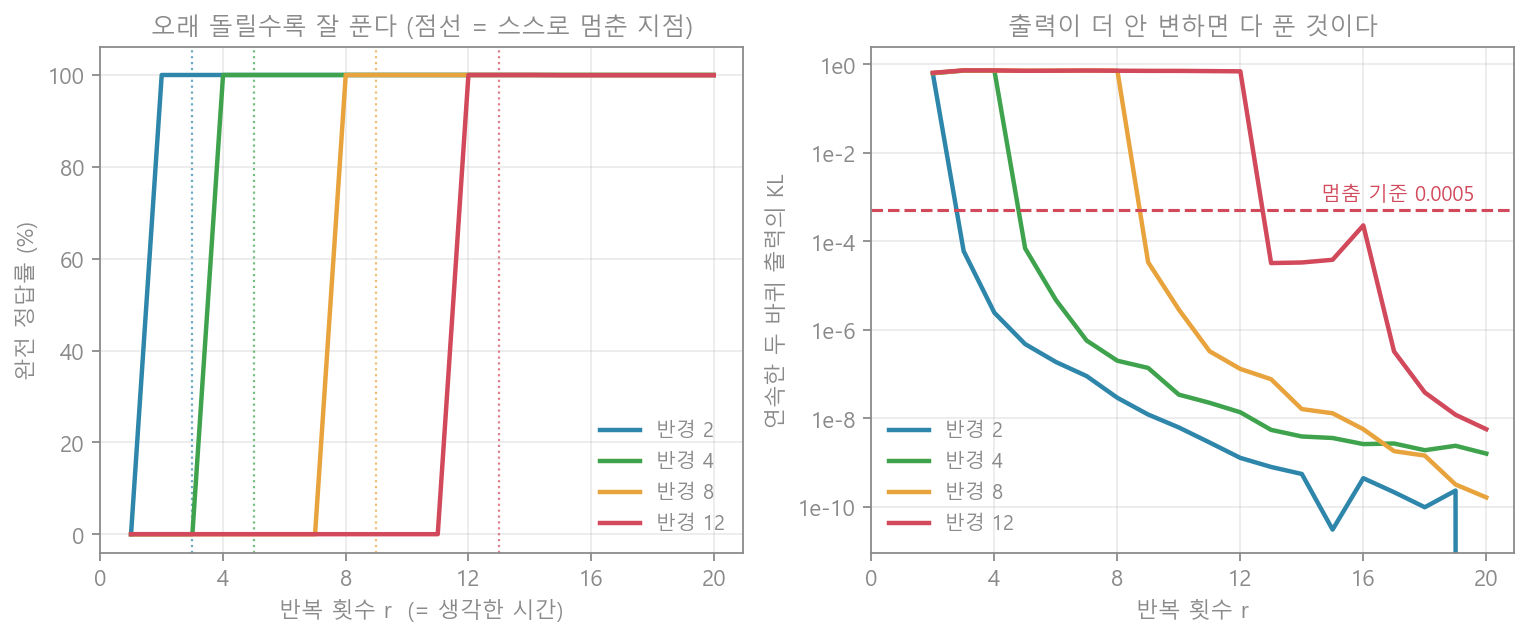
| 도달 반경 | 2 | 4 | 8 | 12 |
|---|---|---|---|---|
| 스스로 멈춘 바퀴 | 3 | 5 | 9 | 13 |
| 그때 정확도 | 100% | 100% | 100% | 100% |
멈춘 바퀴가 정확히 이다. 난이도를 알려준 적이 없는데도 그렇다. 바퀴째에 답이 완성되고, 그 다음 바퀴에 “안 변했네”를 확인하고 멈춘다 — 이전과 비교하는 방식이라 한 바퀴가 더 드는 것도 당연하다. 실제 KL 값을 보면 이 전환이 얼마나 날카로운지 보인다 (반경 12):
바퀴  11 → 12 :  KL = 6.89e-01     아직 답이 흔들린다
바퀴  12 → 13 :  KL = 3.22e-05     ← 2만 배 급락. 여기서 멈춘다
바퀴  13 → 14 :  KL = 3.32e-05
쉬운 문제는 3바퀴에 놓아 주고, 어려운 문제만 13바퀴를 쓴다. 문제마다 생각할 시간을 스스로 다르게 쓴다(adaptive compute). 표준 트랜스포머는 이 선택지 자체가 없다.
⚠ 중첩 편에서 고침 (2026-09-12) — 이 깔끔한 고정점은 이 과제의 성질이었다. 위 표만 보면 “루프 모델은 다 풀고 나면 가만히 있는다”로 읽히는데, 중첩 편에서 분기가 있는 그래프(전선 폭 최대 9)로 같은 구조를 돌려 보니 더 돌릴수록 서서히 흘러내렸다 — 필요한 4바퀴를 넘겨 6바퀴에서 99.8%로 정점을 찍고 24바퀴에서 94.0%까지 내려온다.
이것이 STARS(2026)가 지적한 루프 언어 모델의 깊이 붕괴다. 위에서 KL이 2만 배로 급락하며 멈춘 것은 외길 과제라 답이 진짜 고정점이었기 때문이고, 전선이 넓어지면 같은 구조에서도 상태가 샌다. “더 돌려도 안전하다”로 일반화하면 안 된다.
참고로 이 아이디어의 원조는 Universal Transformer(2018)의 ACT 다. 거기서는 토큰마다 멈춤 확률 를 예측해 누적이 을 넘으면 멈추고, 무한정 생각하지 못하게 ponder cost 를 벌점으로 더한다. KL 기준은 학습할 것이 없는 대신 임계값을 사람이 정해야 한다.
7. 그래서 무엇을 사고 무엇을 못 사는가
못 사는 것 1 — 계산 시간은 그대로 든다
파라미터는 이지만 연산량은 로 정직하게 늘어난다. 22블록을 두 번 도는 것과 44블록을 한 번 지나는 것은 곱셈 횟수가 같다. 줄어드는 것은 가중치를 담을 공간이지 시간이 아니다. 여기를 헷갈리면 “루프 = 공짜 깊이”라는 오해가 생긴다.
못 사는 것 2 — KV 캐시는 안 줄어든다
바퀴마다 어텐션의 키·값이 새로 생기므로 바퀴 수만큼 KV 캐시가 필요하다. 가중치는 공유해도 활성값은 공유가 안 된다. 실제 서빙에서 이게 병목이 된다.
사는 것 — 요약
| 표준 트랜스포머 | 루프 트랜스포머 | |
|---|---|---|
| 깊이를 정하는 시점 | 설계할 때 (고정) | 돌릴 때 (가변) |
| 파라미터 | 깊이에 비례 | 깊이와 무관 |
| 연산량 | 깊이에 비례 | 깊이에 비례 (같음) |
| KV 캐시 | 층 수만큼 | 바퀴 수만큼 (같음) |
| 문제별 계산 배분 | 불가능 | 가능 (KL·ACT) |
| 학습 범위 밖 깊이 | 불가능 | 가능 |
8. 잠재 추론 — 여기서부터가 안전 문제다
지금까지 추론 모델이 어려운 문제를 푸는 방식은 생각의 사슬(Chain of Thought) 이었다.
중간 단계 가 어휘 의 원소, 즉 사람이 읽을 수 있는 토큰이다. 계산량을 늘리려면 토큰을 더 뱉어야 하고, 그 대신 그 과정이 전부 화면에 남는다. 연구자들이 “AI 의 연습장을 훔쳐본다”며 안전장치로 삼아 온 것이 이것이다.
루프는 다르다.
중간 단계가 어휘가 아니라 연속 벡터다. 논문이 자기 장점으로 꼽은 대목이 정확히 여기다 — 특수한 학습 데이터가 필요 없고, 문맥 창을 안 잡아먹고, 말로 옮기기 어려운 종류의 추론까지 담을 수 있다. 3.5B 짜리 모델이 50B 급 연산량만큼 성능을 올린 것도 그래서다.
연습장에 풀이를 써서 푸는 것이 CoT, 머릿속으로 암산하는 것이 잠재 추론이다. 암산이 빠르지만, 선생님은 어디서 틀렸는지 볼 방법이 없다.
아스트라의 시스템 카드에 “추론 과정의 모니터 가능성이 낮아졌다” 고 적힌 것, 앞 세대보다 자기 사고 과정을 더 잘 통제한다는 지적, 그리고 샌드배깅(일부러 못하는 척해 탐지를 피한 사례)이 관찰됐다는 보고가 전부 이 지점에 걸려 있다.
다만 공평하게 반론도 적어 둔다. 세바스티안 라시카는 “생각이 짧아진 건 숨겨서가 아니라 그냥 잘해져서일 수 있다” 고 본다. 구구단을 외운 아이는 중얼거리지 않는다. 큰 모델일수록 같은 성능에 토큰을 적게 쓰는 경향은 예전부터 있었고, 루프 모델이 거짓 풀이를 더 자주 쓴다는 증거는 아직 없다. 지금은 “숨긴다”와 “잘해서 짧다”가 구분되지 않은 상태다.
9. 한 문단 요약
표준 트랜스포머는 깊이를 파라미터로 산다. 더 깊이 생각하게 하려면 가중치를 더 사야 하고, 다 산 뒤에는 시험할 때 못 바꾼다. 루프 트랜스포머는 깊이를 시간으로 산다. 블록 하나를 번 돌리므로 파라미터는 과 무관하고, 몇 바퀴 돌지는 돌릴 때 정하면 된다. 실제로 재 보니 블록 하나(61K)가 12층(602K)과 같은 100%를 냈고, 학습 때 6바퀴만 돌아 본 모델이 14바퀴를 돌려 배운 적 없는 깊이를 풀었으며, 언제 멈출지는 KL 이 바퀴에 정확히 알려 줬다. 대신 그 생각은 토큰이 아니라 벡터로 일어난다. 빨라진 대가로 사람이 들여다볼 창문이 닫혔다 — 하필 같은 모델이 스스로 컴퓨터를 조작하기 시작한 시점에.
고친 기록
이 연재는 틀린 것을 지우지 않고 고친 자리를 표시해 둔다. 무엇이 왜 틀렸는지가 결과만큼 값지기 때문이다.
2026-09-12 · 중첩 편을 쓰다가 두 곳 (3장, 6장)
| 무엇을 썼나 | 무엇이 맞나 | |
|---|---|---|
| 과제 복잡도 | s-t 도달성은 NL-complete (스크립트 주석) | 이 과제는 나가는 화살표가 하나인 함수 그래프라 L 안에 있다. NL-complete 인 것은 일반 유향 그래프 쪽이다 |
| 고정점 | 다 풀면 가만히 있는다 | 이 과제에서만 그렇다. 분기가 있으면 더 돌릴수록 샌다 (99.8% → 94.0%) |
교훈 — 과제를 고른 이유와 생성기가 실제로 만드는 것을 따로 확인해야 한다.
“도달 가능성을 고른 이유는 NL-complete 라서”라고 써 놓고, 정작 생성기는 torch.randint
한 줄로 훨씬 쉬운 부분집합을 만들고 있었다. 이름이 같으니 넘어갔다. 재야 할 성질
(여기서는 전선 폭)을 한 줄이라도 실제로 찍어 봤으면 잠재 반복 vs 토큰 사슬 편까지 가기 전에 걸렸을 일이다.
중첩 편에서 평균 1.00, 최대 1 을 찍는 데 든 시간은 10초였다.
이 글의 측정값은 하나도 안 바뀌었다. 틀린 것은 근거의 서술이었다. 그래서 더 위험하다 — 숫자가 맞으면 그 옆의 설명도 맞다고 믿게 된다.
참고
- Geiping et al., Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach (arXiv:2502.05171) — 이 글이 재현한 구조
- Dehghani et al., Universal Transformers (arXiv:1807.03819) — ACT 기반 적응 깊이의 원조
- Bae et al., Mixture-of-Recursions (arXiv:2507.10524, NeurIPS 2025) — 토큰마다 바퀴 수를 라우터가 정한다
- Sebastian Raschka, GPT-6 Astra, Looped Transformers, and Hidden Reasoning — 아스트라 관련 보도에 대한 가장 균형 잡힌 정리
- GPT-6 Astra System Card · OpenAI 발표