인지야공/수학·공학 노트/17번째 글
UCB — 모르는 것에 이자를 붙인다
실행:
python 딥러닝/mathnotes/M14_ucb.py강화학습 기초 편에서 ε-그리디가 실패했고 몬테카를로 트리 탐색 편은 UCB로 골랐다. 그 차이를 정리한다.
1. 후회로 재기
성공률이 서로 다른 팔 5개가 있다(0.20 / 0.30 / 0.38 / 0.42 / 0.50). 어느 것이 제일 좋은지 모르는 채로 2만 번 당긴다. 잘했는지를 재는 자연스러운 자는 후회(regret) 다.
| 기호 | 뜻 |
|---|---|
| 가장 좋은 팔의 기대 보상 (여기서는 0.50) | |
| 번째에 실제로 고른 팔의 기대 보상 | |
| 총 시도 횟수 |
후회는 “처음부터 정답을 알았다면 받았을 것과의 차이”다. 중요한 것은 총량이 아니라 기울기다. 후회가 계속 직선으로 늘면 시간이 지나도 여전히 같은 비율로 헛발질하고 있다는 뜻이고, 곡선이 누우면 학습이 끝나 간다는 뜻이다.
ε-그리디는 의 확률로 무작위, 나머지는 현재 1등을 고른다. 문제는 이 고정이라는 것이다. 1만 번을 당겨 답을 다 알고 난 뒤에도 여전히 의 비율로 나쁜 팔을 당긴다. 그래서 후회의 기울기가 로 영원히 남는다.
UCB는 평균에 “덜 본 것에 붙이는 이자”를 더해서 고른다.
| 기호 | 뜻 |
|---|---|
| 팔 의 지금까지 평균 보상 (활용) | |
| 팔 를 당긴 횟수 | |
| 보너스 크기를 정하는 상수 |
가 분모에 있으니 적게 본 팔일수록 보너스가 크다. 많이 당길수록 보너스가 줄어 자연히 평균만 남는다 — 탐색을 스스로 접는다. ε-그리디와 달리 누가 꺼 주지 않아도 된다. 분자의 는 시간이 갈수록 아주 천천히 자라서, 한동안 방치된 팔이 완전히 잊히지는 않게 한다.
2. 직접 재 보기
200번씩 반복해 평균낸 누적 후회다.
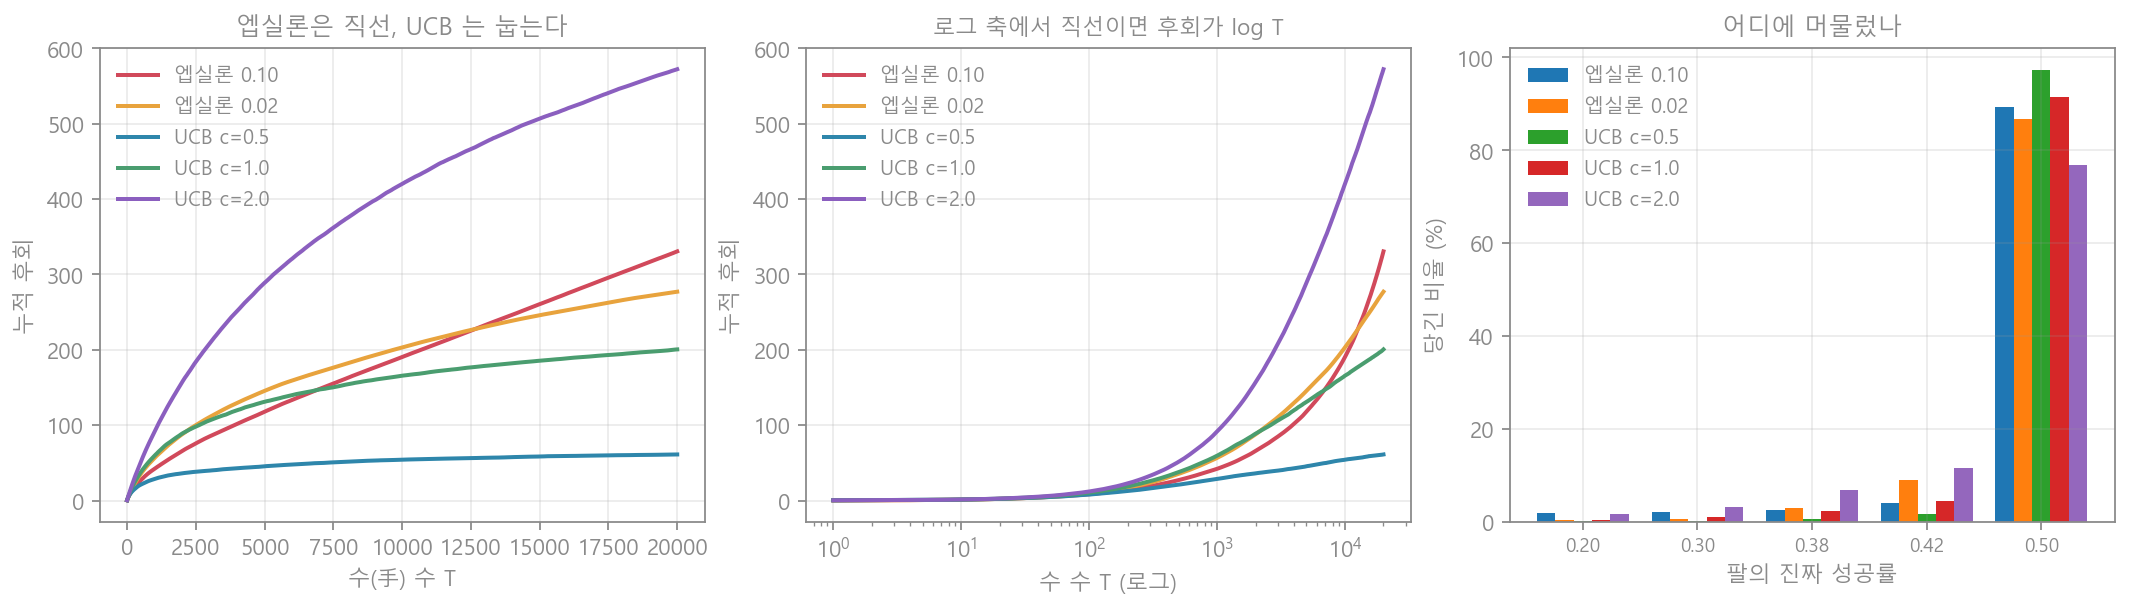
| 방법 | T=1,000 | T=5,000 | T=20,000 | 뒤 절반의 기울기 |
|---|---|---|---|---|
| ε-그리디 0.10 | 42.1 | 117.8 | 330.6 | 0.0140 |
| ε-그리디 0.02 | 56.5 | 145.5 | 277.1 | 0.0074 |
| UCB c=0.5 | 28.6 | 45.4 | 61.1 | 0.0007 |
| UCB c=1.0 | 59.5 | 131.1 | 200.6 | 0.0035 |
| UCB c=2.0 | 91.5 | 288.9 | 572.4 | 0.0152 |
마지막 열이 핵심이다. ε-그리디 0.10은 기울기가 0.0140 으로 남아 있다 — 2만 수를 두고도 한 수마다 같은 비율로 손해를 본다. UCB c=0.5는 0.0007 로, 20배 작다. 후회 곡선이 거의 평평해졌다.
마지막에 어느 팔에 머물렀는지를 보면 이유가 분명하다.
| 방법 | 0.20 | 0.30 | 0.38 | 0.42 | 0.50 (최적) |
|---|---|---|---|---|---|
| ε-그리디 0.10 | 2.0% | 2.1% | 2.5% | 4.0% | 89.3% |
| UCB c=0.5 | 0.1% | 0.3% | 0.7% | 1.7% | 97.3% |
| UCB c=2.0 | 1.6% | 3.1% | 6.8% | 11.6% | 76.8% |
ε-그리디 0.10이 최적 팔에 89.3% 머무는 건 우연이 아니다 — 이니 10%는 무조건 무작위로 흩뿌리고, 그 중 5분의 1이 우연히 최적 팔로 돌아온다. 구조적으로 90% 근처가 천장이다.
그리고 교과서와 반대로 나온 것 하나. UCB라고 항상 이기지는 않았다. 은 후회 572로 ε-그리디보다 나빴고, 최적 팔에 76.8%밖에 머물지 못했다. 보너스가 너무 크면 이미 답이 나온 뒤에도 계속 나쁜 팔을 기웃거린다. UCB의 값어치는 “탐색한다”가 아니라 “적절한 때에 탐색을 접는다” 에 있고, 가 그 시점을 정한다.
3. 왜 중요한가
- 강화학습 기초 편에서 ε-그리디가 전부 실패한 것이 우연이 아니다. 고정 은 “언제 탐색을 멈출지”를 모른다. 그 글에서 결국 답이 된 낙관적 초기화도 같은 생각이다 — 안 본 것에 높은 값을 줘 먼저 가 보게 하고, 보고 나면 내려가게 한다.
- 몬테카를로 트리 탐색 편의 선택 단계가 정확히 이 식이다. 트리의 각 노드에서 자식을 고를 때 승률에 을 더한다. 유망한 수를 깊이 파면서도 안 본 수를 완전히 버리지 않는 균형이 여기서 나온다.
- 는 공짜 손잡이가 아니다. 위 표에서 를 0.5에서 2.0으로 올렸을 뿐인데 후회가 9배가 됐다. 몬테카를로 트리 탐색 편에서 MCTS 파라미터를 고를 때 이 감각이 필요하다.
4. 한 줄 요약
ε-그리디는 고정된 비율로 영원히 헛발질하므로 후회가 직선으로 늘고(2만 수에 330.6, 기울기 0.0140), UCB는 적게 본 팔에만 이자를 붙여 탐색을 스스로 접으므로 후회가 눕는다(61.1, 기울기 0.0007). 다만 이자율 를 2.0으로 키우니 572.4로 ε-그리디보다 나빴다 — 핵심은 탐색하는 것이 아니라 제때 그만두는 것이다.
연결
- 강화학습 기초 · 몬테카를로 트리 탐색 · 표본 오차