인지야공/딥러닝 기초 정리/21번째 글
디코딩과 샘플링 — temperature·top-p가 하는 일
실행:
python NN_18_decoding.py(numpy, 수 초) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 학습 모델의 잡음을 빼고 주어진 확률 분포 위에서 디코딩 자체만 떼어 잰다.
지금까지 모델이 다음 토큰의 확률을 내는 것까지 봤다(그 확률을 어떻게 쓸지는 잠재 반복 vs 토큰 사슬 편과 Jev 편에서도 다룬다). 그런데 확률은 답이 아니다. “스팸 0.6, 정상 0.4”에서 실제로 무엇을 뱉을지 정하는 마지막 단계가 디코딩이다. 같은 모델도 디코딩에 따라 지루하게 반복하거나, 창의적이거나, 헛소리를 한다. 그 세 손잡이를 잰다.
1. 온도 — 분포를 뾰족하게, 평평하게
모델의 로짓 를 온도 로 나눈 뒤 softmax 한다.
| 효과 | |
|---|---|
| 큰 값이 더 커진다 → 뾰족(확신, 보수적) | |
| 모델 원래 분포 | |
| 격차가 줄어든다 → 평평(다양, 모험적) | |
| 최댓값만 1 → 그리디 |
직접 재 보기 A
대표 분포 하나에 온도를 바꿔 가며 엔트로피(다양성)와 top-1 확률(확신)을 쟀다.
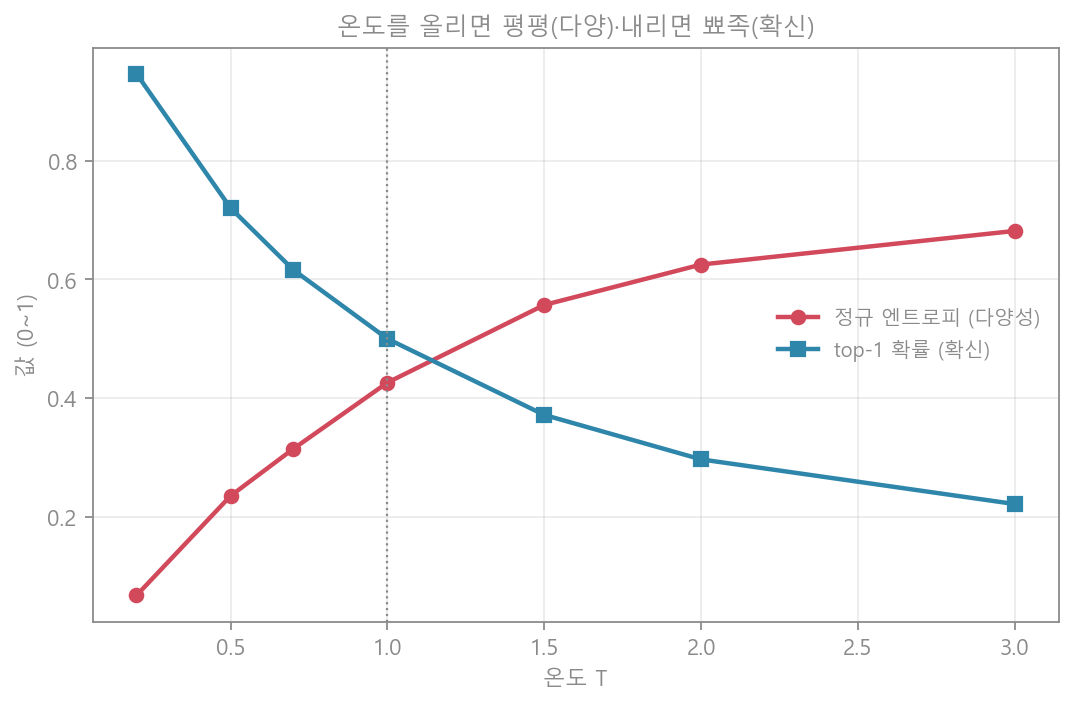
| 온도 | 0.2 | 0.5 | 1.0 | 1.5 | 3.0 |
|---|---|---|---|---|---|
| 정규 엔트로피 | 0.06 | 0.22 | 0.40 | 0.49 | 0.58 |
| top-1 확률 | 0.96 | 0.74 | 0.52 | 0.40 | 0.27 |
온도를 올릴수록 엔트로피(다양성)는 오르고 top-1 확률(확신)은 내린다. 온도는 다양성과 확신 사이의 손잡이다. 번역·코드처럼 정답이 좁으면 낮게, 창작이면 높게 쓴다.
2. 그리디의 함정 — 같은 길로만 간다
가장 단순한 디코딩은 그리디 — 매번 확률 최고를 고른다. 언뜻 최선 같지만, 늘 같은 길로만 가서 루프에 빠진다. “제일 그럴듯한 다음 단어”를 반복하면 “그리고 그리고 그리고…” 같은 반복이 생긴다.
직접 재 보기 B
최고 후속이 정해진 소스에서 그리디와 샘플링으로 300토큰을 뽑아 3-그램 반복률(같은 세 토큰 조각이 다시 나온 비율)을 쟀다.
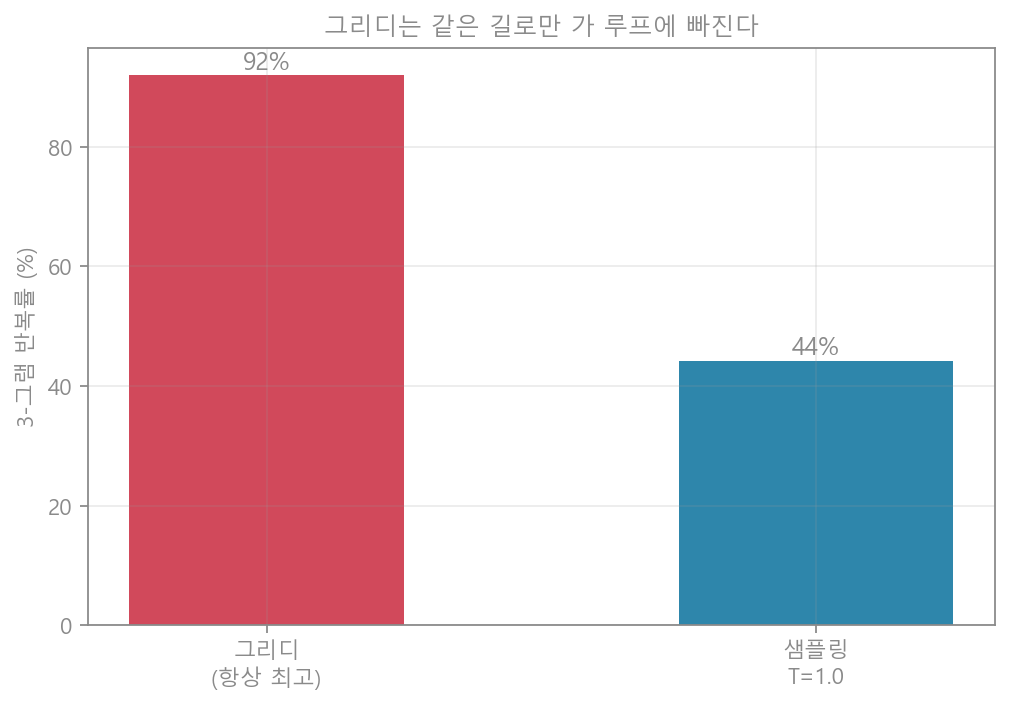
| 방식 | 3-그램 반복률 |
|---|---|
| 그리디 (항상 최고) | 91.9% (24-주기 루프에 갇힘) |
| 샘플링 T=1.0 | 44.2% |
그리디는 반복률 92% — 최고만 따라가다 짧은 주기로 뱅뱅 돈다. 샘플링은 가끔 2·3순위도 골라 그 루프를 깨고 나온다(44%). 실제 LLM 이 그리디에서 같은 문장을 반복하는 것이 이 현상이다. 그래서 생성에는 보통 샘플링을 쓴다.
3. top-p — 꼬리를 잘라 헛소리를 막는다
그런데 샘플링에도 문제가 있다. 분포에는 긴 꼬리(확률 아주 낮은 수많은 토큰)가 있는데, 온도를 높여 다양성을 얻으면 그 꼬리의 헛토큰까지 뽑히기 쉽다. 다양성은 좋지만 헛소리는 곤란하다.
top-p(뉴클리어스) 샘플링은 확률 높은 것부터 누적 (예: 0.9)까지만 남기고 나머지 꼬리를 잘라 그 안에서만 뽑는다. 핵심(nucleus)은 문맥마다 크기가 달라져, 확신할 땐 몇 개만, 애매할 땐 여럿을 남긴다.
직접 재 보기 C
높은 온도(T=1.5)만 쓴 경우와, 거기에 top-p=0.9 를 더한 경우를 비교했다. 헛토큰은 참 확률 3% 미만인 토큰을 뽑은 비율이다.
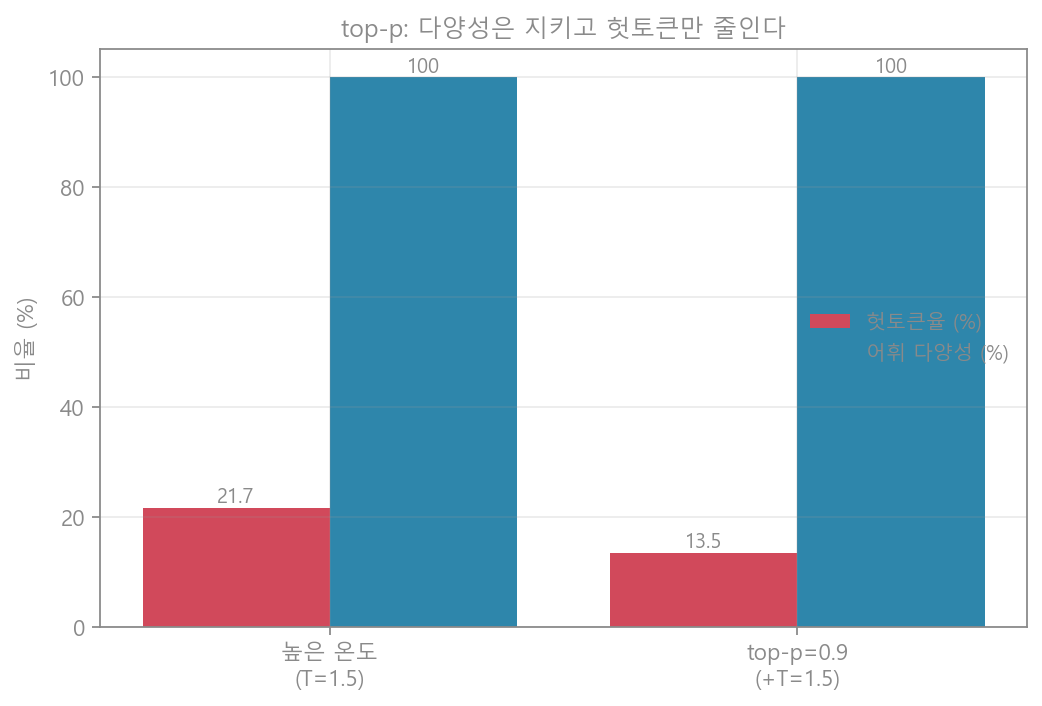
| 방식 | 헛토큰율 | 어휘 다양성 |
|---|---|---|
| 높은 온도 (T=1.5) | 21.7% | 100% |
| top-p=0.9 (+T=1.5) | 13.5% | 100% |
top-p 는 다양성(100%)은 그대로 두고 헛토큰만 1.6배 줄였다. 꼬리를 잘랐으니 헛소리 후보가 사라지고, 핵심 안에서는 여전히 다양하게 뽑기 때문이다. 요즘 생성이 대부분 온도 + top-p 를 함께 쓰는 이유다(top-k 도 비슷하게 상위 개만 남긴다).
4. 흔한 오해와 한계
- “그리디가 가장 정확” — 아니다. 각 스텝의 최선이 전체 문장의 최선은 아니고(근시안), 루프에 빠진다(2절).
- “온도만 높이면 창의적” — 아니다. 꼬리의 헛토큰까지 뽑혀 헛소리가 는다. top-p 로 꼬리를 함께 잘라야 한다.
- “디코딩은 사소하다” — 아니다. 같은 모델도 디코딩으로 결과가 크게 갈린다. 다만 디코딩은 모델을 못 고친다 — 나쁜 확률에서 좋은 답을 만들 수는 없다.
- 이 글의 실험 — 학습 모델 대신 알려진 분포 위에서 디코딩만 뗀 축소 모형이다. 92%·1.6배 같은 수는 이 설정의 값이고, 요점은 온도=다양성 손잡이, 그리디=루프, top-p=꼬리컷이라는 구조다.
5. 한 문단 요약
모델은 다음 토큰의 확률만 주고, 그걸 토큰으로 바꾸는 마지막 단계가 디코딩이다. 온도는 분포를 뾰족(확신)하게 또는 평평(다양)하게 만드는 손잡이다(재 보니 T 0.2→3에서 top-1 0.96→0.27). 늘 최고만 고르는 그리디는 같은 길로만 가 루프에 빠져 반복률이 92%까지 치솟았고(샘플링은 44%), 그래서 생성엔 샘플링을 쓴다. 다만 샘플링은 긴 꼬리의 헛토큰을 뽑을 수 있어, top-p로 확률 상위 90%까지만 남기고 꼬리를 자르면 다양성은 그대로 두고 헛토큰만 1.6배 줄었다. 좋은 디코딩은 다양성과 정확성 사이의 균형을 잡는 일이고, 온도 + top-p 조합이 그 표준이다.