인지야공/수학·공학 노트/16번째 글
거부 샘플링 — 싼 분포로 비싼 분포를 정확히 흉내내기
실행:
python 딥러닝/mathnotes/M11_rejection.py스펙큘러티브 디코딩 편에서 쓴 수락 판정이 왜 근사가 아니라 정확한가를 정리한다.
1. 문제
목표 분포 에서 뽑고 싶은데 를 구하는 일이 비싸다. 대신 싼 제안 분포 가 있다. 에서 뽑아 쓰면 안 될까? 당연히 안 된다 — 분포가 가 되어 버린다.
그런데 뽑은 것을 조건부로 버리면 를 정확히 복원할 수 있다.
토큰마다 와 중 작은 쪽까지는 제안을 그대로 써도 아무 문제가 없다. 문제는 가 보다 큰 자리다. 그 모자란 몫을 모은 것이 잔차이고, 거부가 일어났을 때 바로 거기서 다시 뽑는다.
| 기호 | 뜻 |
|---|---|
| 제안 분포 — 싼 초안 모델이 주는 확률 | |
| 목표 분포 — 우리가 실제로 원하는(비싼 모델의) 확률 | |
| . 음수는 0으로 자른다 | |
| 전변동거리 — 두 분포의 어긋남 |
왜 정확한가는 한 줄로 확인된다. 토큰 가 최종적으로 나올 확률은 수락으로 나올 몫 에 거부 후 잔차에서 나올 몫을 더한 것인데, 거부가 일어날 확률이 와 같아 분모가 지워지고 만 남는다. 둘을 더하면 다.
2. 직접 재 보기
어휘 8개짜리 장난감 분포로 40만 번 뽑았다.
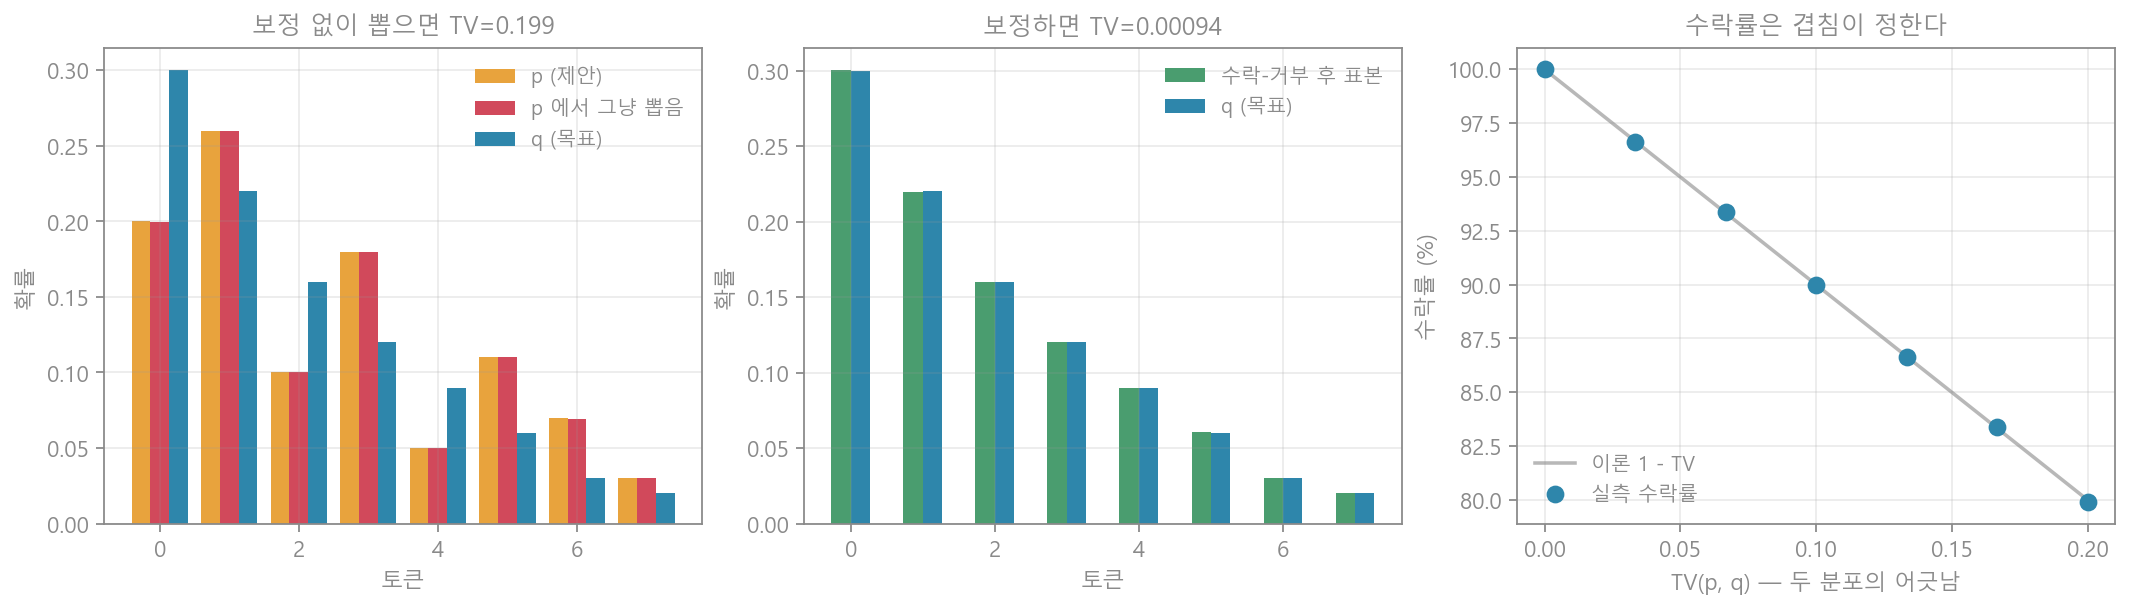
| TV(표본, q) | |
|---|---|
| 보정 없이 에서 그냥 뽑음 | 0.1995 |
| 수락-거부 + 잔차 재샘플링 | 0.00094 |
0.00094는 40만 표본의 통계적 오차 수준이다. 근사가 아니라 정확하다. 초안 모델이 아무리 엉성해도 최종 분포는 큰 모델의 것과 같고, 엉성함은 오직 속도로만 나타난다.
그 속도가 무엇으로 정해지는지가 세 번째 실험이다. 를 쪽으로 조금씩 당기며 수락률을 쟀다.
| TV(p, q) | 이론 1 − TV | 실측 수락률 |
|---|---|---|
| 0.2000 | 80.00% | 79.91% |
| 0.1333 | 86.67% | 86.63% |
| 0.0667 | 93.33% | 93.38% |
| 0.0000 | 100.00% | 100.00% |
전부 0.1%p 안에서 맞는다. 기대 수락률은 정확히 다.
3. 왜 중요한가
- 스펙큘러티브 디코딩 편의 수락률이 어디서 오는지가 이것이다. 초안 모델을 키우는 일은 곧 를 줄이는 일이고, 줄어든 만큼 그대로 수락률이 된다. “얼마나 빨라지나”를 추측하지 않고 두 분포의 어긋남만 재면 알 수 있다는 뜻이다.
- 품질 논쟁이 필요 없다. 스펙큘러티브 디코딩이 출력 품질을 해치느냐는 질문은 애초에 성립하지 않는다. 분포가 수학적으로 같다. 고를 것은 속도뿐이다.
- 같은 구조가 잔차를 남기는 모든 근사에 쓰인다 — 값싼 후보를 먼저 내고 비싼 검증자가 받아들이거나 물리는 방식이면 무엇이든.
4. 한 줄 요약
싼 분포 에서 뽑고 로 수락하되 거부하면 잔차 에서 다시 뽑으면, 최종 분포는 정확히 가 된다(실측 TV 0.00094). 그리고 이때 기대 수락률은 정확히 다 — 초안이 목표와 겹치는 만큼이 그대로 속도가 된다.