인지야공/딥러닝 기초 정리/24번째 글
큰 배치와 그래디언트 축적 — 분산 학습의 산수
실행:
python NN_25_large_batch.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
스케일링 법칙 편에서 계산 예산을 키우려면 GPU를 여러 대 써야 한다. 그런데 “여러 GPU로 학습한다”는 게 정확히 무슨 뜻일까? 놀랍도록 단순하다 — 배치를 나눠 계산하고 그라디언트를 평균한다. 그 산수와, 배치를 키울 때 따라오는 두 가지 결과를 잰다.
1. 데이터 병렬 = 그래디언트 축적 = 큰 배치
손실은 각 샘플 손실의 평균이다. 그래서 그라디언트도 평균이다.
조각을 여러 GPU가 나눠 계산하고 평균하면(all-reduce) 큰 배치 한 번과 같고, 한 GPU가 순서대로 계산해 쌓아도(그래디언트 축적) 똑같다. 둘은 같은 산수의 다른 구현이다.
직접 재 보기 A
| 최대 오차 | |
|---|---|
| 배치 512 한 번 vs 배치 128 × 4 평균 | 9.3e-10 |
정확히 같다. GPU가 4대든, 메모리가 모자라 4번 나눠 쌓든, 결과는 배치 512 한 번과 동일하다. 그래서 메모리가 부족할 때 그래디언트 축적으로 “가상의 큰 배치”를 만들 수 있다.
2. 큰 배치의 이득 — 잡음이 1/B로 준다
배치는 전체 데이터의 표본이라, 그 그라디언트는 참 방향에 잡음이 낀 추정이다. 표본을 늘리면 잡음이 줄어드는 통계의 기본대로, 분산은 배치 크기에 반비례한다.
직접 재 보기 B
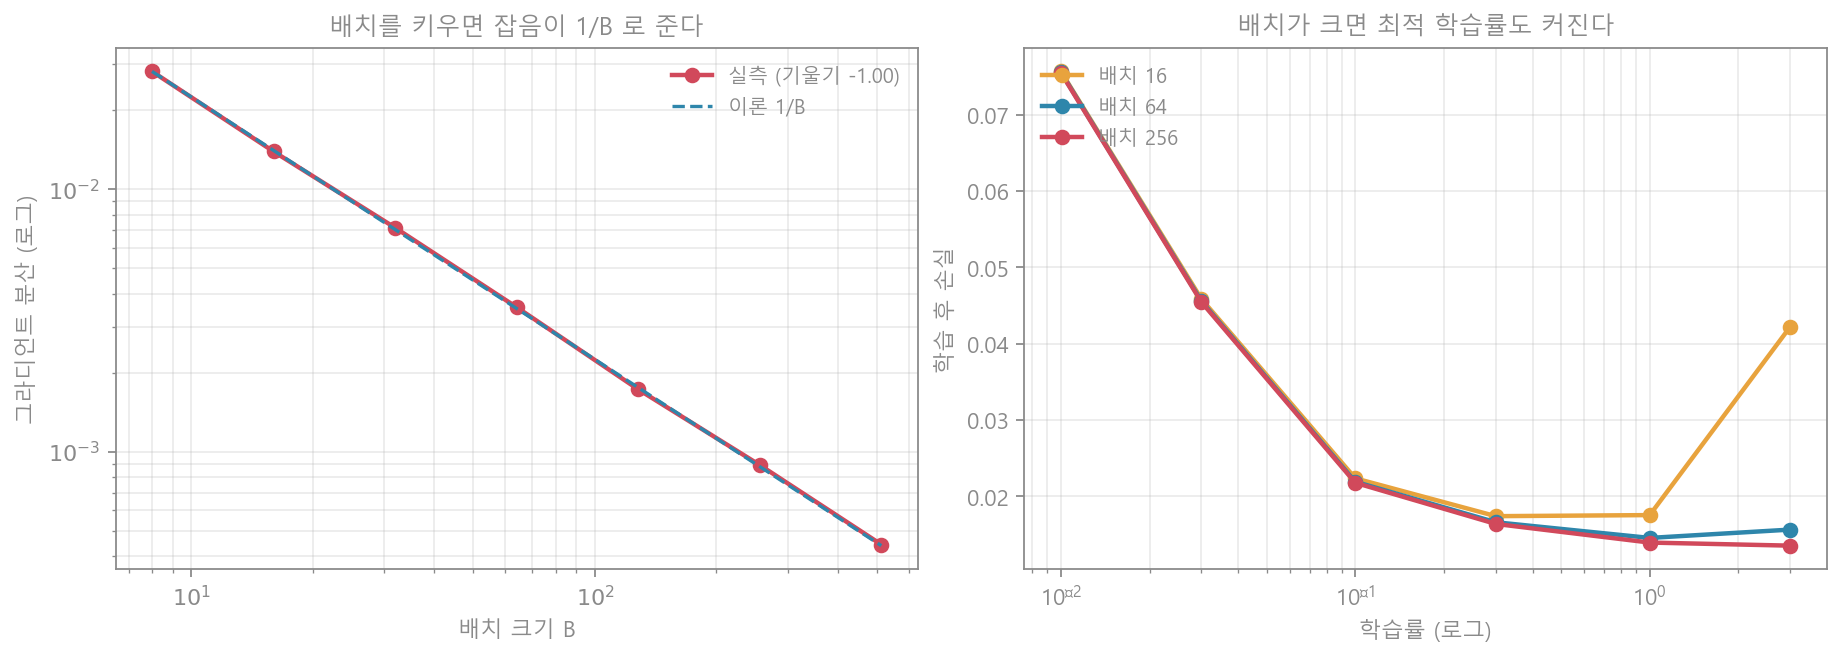
| 배치 B | 8 | 32 | 128 | 512 |
|---|---|---|---|---|
| 그라디언트 분산 | 2.8e-2 | 7.1e-3 | 1.7e-3 | 4.4e-4 |
로그-로그 기울기가 정확히 -1.00 — 이론과 완벽히 일치한다. 배치를 키우면 그라디언트 방향이 또렷해져 더 과감하게(큰 걸음으로) 내려갈 수 있다.
3. 대가와 규칙 — 학습률도 키워야 한다
잡음이 줄었으니 더 큰 걸음이 가능하다. 반대로 배치만 키우고 학습률을 그대로 두면, 같은 데이터를 보고도 덜 움직여 손해다. 그래서 경험칙이 있다 — 배치를 배 키우면 학습률도 대략 배(선형 스케일링 규칙).
직접 재 보기 C
배치별로 학습률을 훑어 최적값을 찾았다(위 그림 오른쪽).
| 배치 | 16 | 64 | 256 |
|---|---|---|---|
| 최적 학습률 | 0.3 | 1.0 | 3.0 |
배치가 16배 커질 때 최적 학습률이 10배 커졌다 — 대략 비례한다. 다만 완전한 비례는 아니고, 아주 큰 배치에서는 이 규칙이 깨져(워밍업 필요, 수익 체감) “큰 배치의 한계”가 나타난다(최적화 편의 워밍업이 여기서도 쓰인다).
4. 흔한 오해와 한계
- “GPU를 2배 쓰면 2배 빨라진다” — 계산은 그렇지만 통신(all-reduce)이 붙는다. 모델이 크고 네트워크가 느리면 통신이 병목이 된다.
- “배치를 키우면 항상 좋다” — 아니다. 잡음이 줄어드는 이득은 로 수익 체감하고, 어느 지점부터는 같은 계산으로 더 많은 스텝을 밟는 편이 낫다.
- “축적과 병렬은 다르다” — 산수는 같다(1절). 다른 것은 순차냐 병렬이냐, 즉 시간을 쓰느냐 하드웨어를 쓰느냐뿐이다.
- 이 글의 실험 — 한 GPU에서 데이터 병렬의 산수를 재현한 축소 모형이다. 통신 비용·파이프라인·텐서 병렬 같은 실제 분산 시스템의 세부는 다루지 않았다.
5. 한 문단 요약
여러 GPU 학습의 핵심은 그라디언트 평균이다 — 배치 128짜리 4개의 평균이 배치 512 한 번과 오차 9e-10으로 같았고, 이는 곧 데이터 병렬(all-reduce)이자 그래디언트 축적이다. 배치를 키우면 그라디언트 잡음이 정확히 1/B로 줄어 (기울기 -1.00) 방향이 또렷해지고, 그만큼 학습률도 함께 키워야 한다(배치 16배에 최적 학습률 10배 — 선형 스케일링). 다만 통신 비용과 수익 체감이 있어 무한정 키울 수는 없다. 분산 학습은 복잡해 보이지만 그 뼈대는 평균의 산수다.
참고
- Goyal 외 — Accurate, Large Minibatch SGD (2017) — 선형 스케일링 규칙·워밍업
- McCandlish 외 — An Empirical Model of Large-Batch Training (2018) — 그라디언트 잡음 척도
- 연재: 최적화 · 스케일링 법칙 · 혼합정밀도