인지야공/딥러닝 기초 정리/19번째 글
혼합정밀도와 그래디언트 체크포인팅 — 학습 메모리를 사는 두 방법
실행:
python NN_24_mixed_precision.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 필요한 공학: 부동소수점 노트.
스케일링 법칙 편은 “키우면 좋아진다”고 했지만, 실제로 학습을 막는 것은 대개 GPU 메모리다. 가중치·그라디언트·옵티마이저 상태·활성값이 모두 올라가야 한다. 이를 줄이는 두 표준 장치를 잰다 — 혼합정밀도(더 적은 비트로 담기)와 그래디언트 체크포인팅(저장 대신 다시 계산).
1. 혼합정밀도 — 절반 비트로 담고 계산
기본은 fp32(32비트)지만, 신경망은 정밀도에 둔감해 16비트로도 학습된다(부동소수점 노트). 메모리가 절반이고, GPU의 반정밀도 연산기(텐서 코어)가 훨씬 빠르다.
직접 재 보기 A
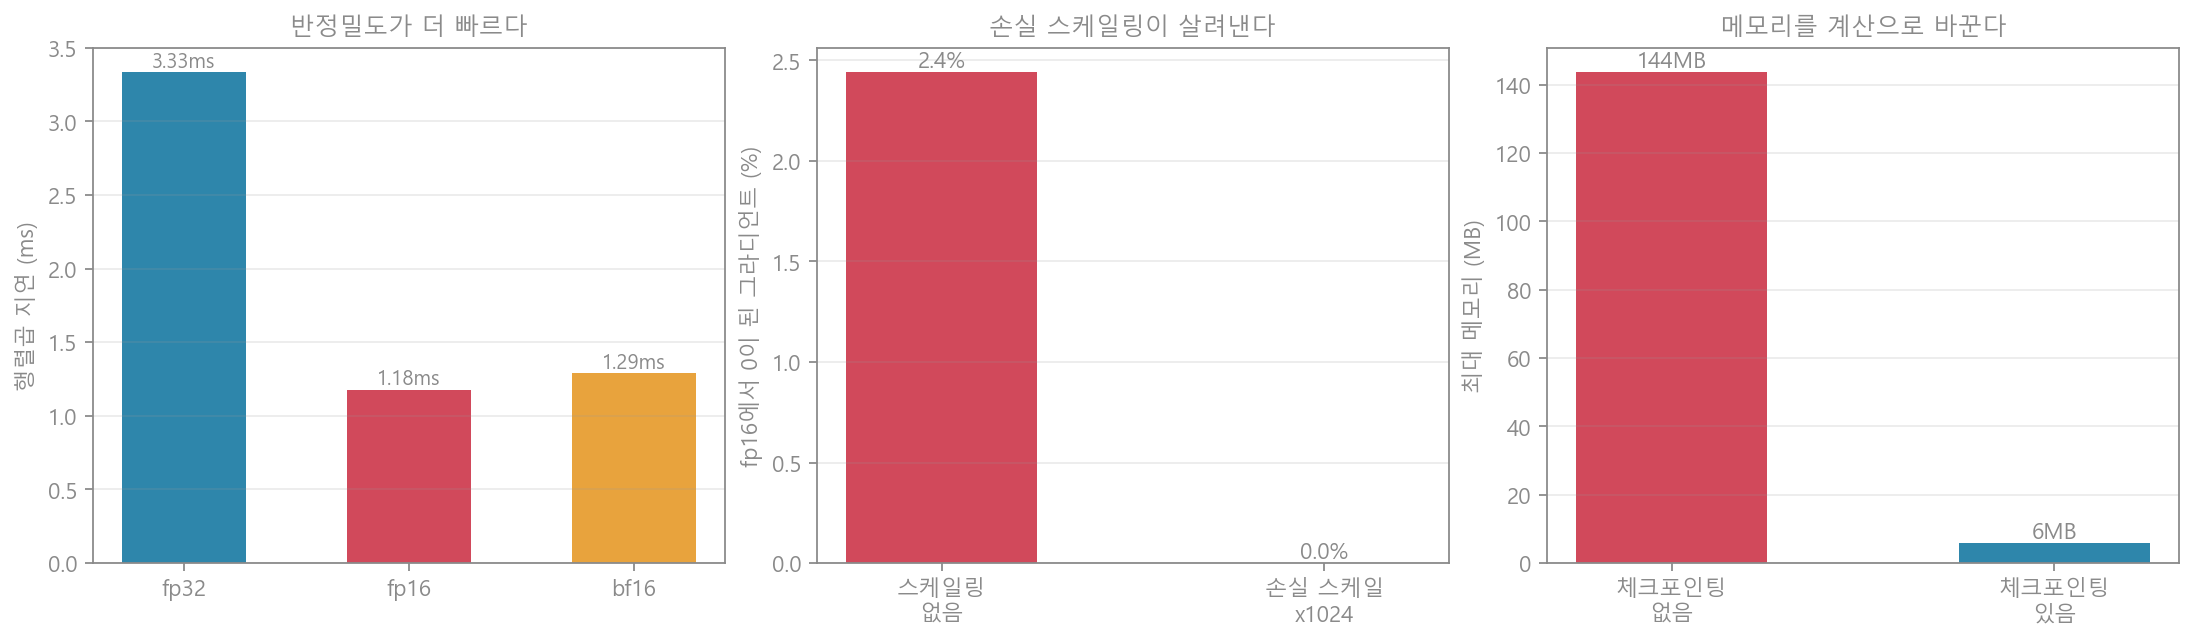
| 포맷 | 4096×4096 행렬곱 | 메모리 |
|---|---|---|
| fp32 | 3.33 ms | 201 MB |
| fp16 | 1.18 ms (2.8배 빠름) | 101 MB (절반) |
| bf16 | 1.29 ms | 101 MB |
2.8배 빠르고 메모리 절반이다. 그래서 요즘 학습은 기본이 혼합정밀도다(“혼합”인 이유는 계산은 16비트로 하되 가중치 원본(master)은 fp32로 유지해 누적 오차를 막기 때문이다).
2. 함정과 해법 — 손실 스케일링
fp16은 범위가 좁다(최대 65,504, 최소 양수 6.1e-5). 그래서 아주 작은 그라디언트가 0으로 사라진다. 해법은 간단하다 — 손실에 큰 수를 곱해 그라디언트를 fp16 범위 안으로 끌어올린 뒤, 갱신 전에 다시 나눈다.
직접 재 보기 B
전형적으로 작은 그라디언트(~1e-6)를 fp16에 담아 봤다.
| fp16에서 0이 된 비율 | |
|---|---|
| 스케일링 없음 | 2.4% |
| 손실 스케일 ×1024 | 0.0% (복원 상대오차 2.7e-4) |
2.4%의 그라디언트가 통째로 사라지던 것이 0%로 줄었다. 곱했다가 나누므로 결과는 그대로다(상대오차 1e-4 수준). 참고로 bf16은 범위가 fp32급이라 이 스케일링이 아예 필요 없어, 대형 학습의 기본이 됐다.
3. 그래디언트 체크포인팅 — 저장 대신 다시 계산
역전파는 순전파의 활성값이 필요해 층마다 저장해 둔다. 깊을수록 이 활성값이 메모리를 잡아먹는다. 체크포인팅은 일부만 남기고 버렸다가, 역전파 때 다시 순전파해 되살린다 — 메모리를 계산으로 바꾸는 거래다.
직접 재 보기 C
32층 망에서 체크포인팅 유무를 비교했다.
| 최대 메모리 | 시간 | |
|---|---|---|
| 체크포인팅 없음 | 143.7 MB | 3.34 ms |
| 체크포인팅 있음 | 5.8 MB (24.9배↓) | 5.95 ms (1.78배) |
메모리가 24.9배 줄고 시간은 1.78배 늘었다. 활성값을 다시 계산하는 만큼(대략 순전파 한 번 더) 느려지지만, 그 대가로 훨씬 큰 모델·배치를 같은 GPU에 올릴 수 있다. 정규화와 잔차 편에서 본 깊은 망이 실제로 학습 가능한 데에는 이런 시스템 장치도 한몫한다.
4. 흔한 오해와 한계
- “16비트면 정확도가 떨어진다” — 대개 아니다. 가중치 원본을 fp32로 두고 계산만 16비트로 하면 결과가 거의 같다.
- “fp16과 bf16은 같다” — 아니다. fp16은 좁고 정밀, bf16은 넓고 덜 정밀(부동소수점 노트). fp16은 손실 스케일링이 필요하고 bf16은 아니다.
- “체크포인팅은 공짜” — 아니다. 순전파를 한 번 더 하는 만큼 느려진다(여기선 1.78배).
- 이 글의 실험 — 한 GPU의 축소 측정이다. 2.8배·24.9배는 이 설정의 값이고, 요점은 비트를 줄여 메모리·속도를 사고, 계산을 더 해 메모리를 사는 두 거래다.
5. 한 문단 요약
학습을 막는 것은 대개 메모리다. 혼합정밀도는 16비트로 담아 메모리를 절반으로, 속도를 2.8배로 만든다. 다만 fp16은 범위가 좁아 작은 그라디언트 2.4%가 0으로 사라지므로 손실 스케일링(×1024 후 되돌림)으로 살리고(0%), bf16은 범위가 넓어 그마저 필요 없다. 그래디언트 체크포인팅은 활성값을 저장하지 않고 역전파 때 다시 계산해 메모리를 24.9배 줄이는 대신 시간을 1.78배 쓴다. 둘 다 무엇을 저장하고 무엇을 다시 만들지를 고르는 거래이고, 그 덕에 같은 GPU에 더 큰 모델이 올라간다.
참고
- Micikevicius 외 — Mixed Precision Training (2018) — 손실 스케일링
- Chen 외 — Training Deep Nets with Sublinear Memory Cost (2016) — 체크포인팅
- 연재: 양자화 · 스케일링 법칙 · 공학: 부동소수점