인지야공/딥러닝 기초 정리/16번째 글
플래시 어텐션 — IO를 아는 어텐션
실행:
python NN_22_flash_attention.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 필요한 공학: 산술 강도·메모리 대역폭 노트.
어텐션 편에서 어텐션이 점수 행렬을 만든다고 했다. 이 행렬이 문제다 — 문맥이 길면 메모리를 먹고, 그 거대한 행렬을 메모리에 쓰고 다시 읽는 것이 병목이다 (루프라인 노트). 플래시 어텐션은 이 행렬을 아예 만들지 않는다.
1. 문제 — N×N 행렬을 쓰고 읽는다
어텐션은 점수 (크기 )를 만들고 softmax 한 뒤 와 곱한다. 이 커지면 이 가 GPU 메모리를 잡아먹고, 계산량보다 이 행렬의 IO가 느리다.
직접 재 보기 A
순진한 어텐션(점수 행렬을 만듦)과 플래시(SDPA)의 추가 메모리를 쟀다.
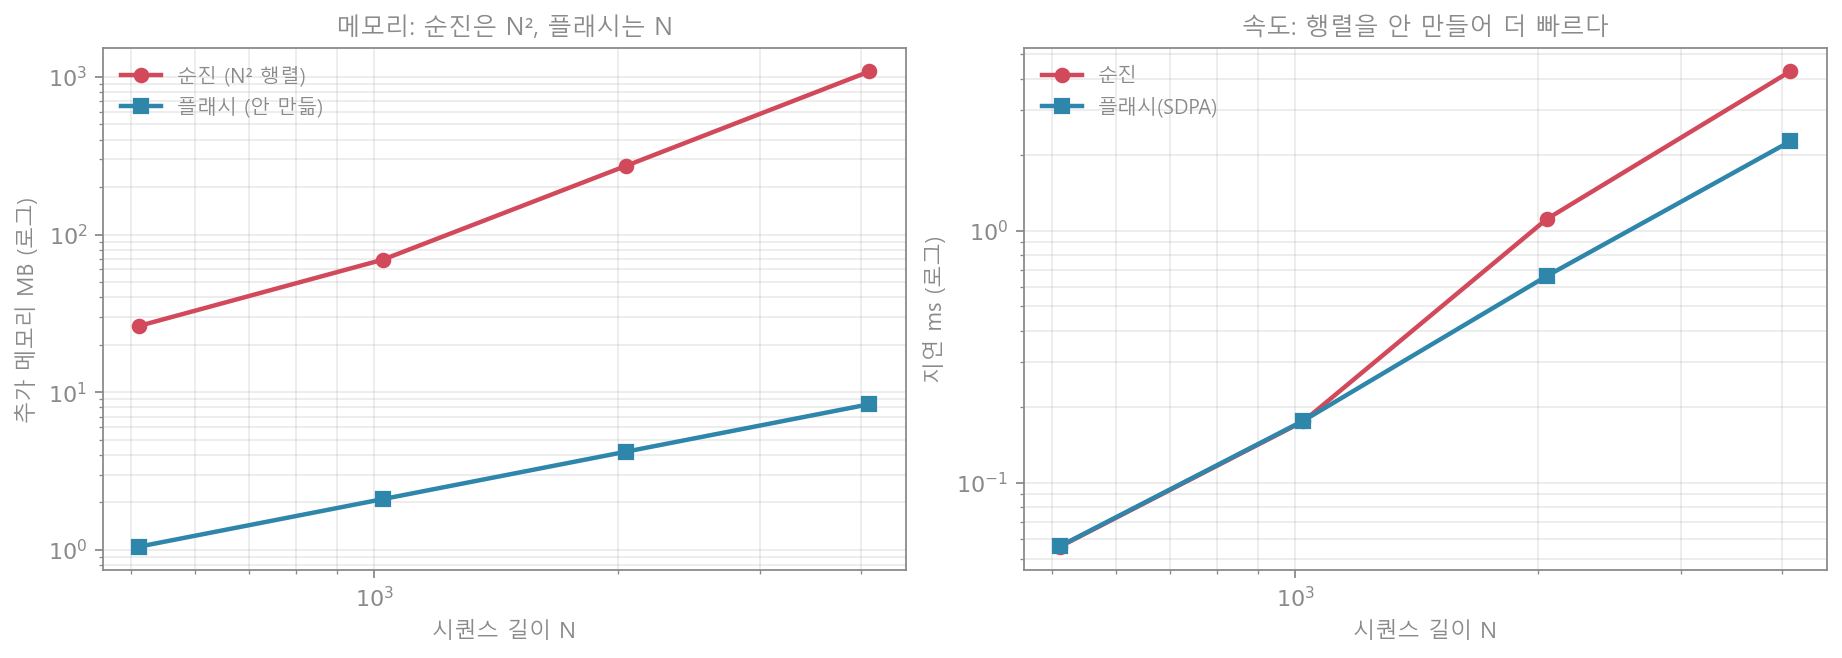
| N | 512 | 1024 | 2048 | 4096 |
|---|---|---|---|---|
| 순진 (N² 행렬) | 26 MB | 69 MB | 273 MB | 1,082 MB |
| 플래시 (안 만듦) | 1 MB | 2 MB | 4 MB | 8 MB |
| 절감 | 25× | 33× | 65× | 129× |
에서 순진한 방식은 1GB를 쓰지만 플래시는 8MB — 129배 적다. 순진은 , 플래시는 이다.
2. 비결 — 온라인 softmax
어떻게 전체 행렬 없이 softmax를 할까? softmax는 전체를 봐야 정규화(합으로 나누기)가 된다고 생각하기 쉽지만, 블록을 훑으며 running 값을 갱신하면 된다.
새 블록이 더 큰 값을 가져오면 이전 누적을 로 보정하고 이어 더한다(수치 안정을 위해 최댓값 을 빼서 계산한다). 다 훑고 이 답이다.
직접 재 보기 B
점수 한 행(2000개)을 128개씩 블록으로 나눠 온라인 방식으로 계산하고, 전체 softmax와 비교했다.
| softmax 가중합 | |
|---|---|
| 전체(한 번에) | 0.030091 |
| 온라인(블록별) | 0.030091 |
최대 오차 2.4e-8 — 블록만으로 전체와 정확히 같은 값을 낸다. 그래서 행렬을 통째로 들고 있을 필요가 없다. 플래시 어텐션은 이 온라인 softmax로 점수를 타일 단위로 처리하며, 각 타일을 GPU의 빠른 캐시(SRAM) 안에서 끝내 느린 메모리 왕복을 없앤다.
3. 결과 — 더 빠르다
직접 재 보기 C
같은 어텐션을 순진한 방식과 플래시(SDPA)로 계산한 지연이다(위 그림 오른쪽).
| N | 512 | 2048 | 4096 |
|---|---|---|---|
| 순진 | 0.06 ms | 1.15 ms | 4.32 ms |
| 플래시 | 0.06 ms | 0.65 ms | 2.27 ms |
| 배율 | 1.0× | 1.8× | 1.9× |
계산량(FLOPs)은 거의 같은데 1.9배 빠르다 — 줄인 것은 계산이 아니라 메모리 IO다(루프라인 노트의 memory-bound). 짧은 에서는 차이가 작지만, 문맥이 길수록 벌어진다. 요즘 LLM 이 100만 토큰 문맥을 감당하는 것이 플래시 어텐션(과 그 후속들) 덕이다.
4. 흔한 오해와 한계
- “플래시는 근사” — 아니다. 온라인 softmax는 전체와 수학적으로 같다(2절, 오차 2e-8). 정확한 어텐션이다.
- “계산을 줄인다” — 아니다. FLOPs 는 비슷하다. 메모리 IO를 줄여 빨라진다.
- “어텐션이 O(N²)에서 벗어난다” — 계산은 여전히 다(모든 쌍을 봄). 메모리만 이 된다. 계산까지 줄이려면 상태공간모델·선형 어텐션 편이 필요하다.
- 이 글의 실험 — SDPA(파이토치의 플래시 구현)와 순진한 구현을 비교한 것이다. 129배·1.9배는 이 설정의 값이다.
5. 한 문단 요약
어텐션의 점수 행렬은 메모리를 먹고 그 IO가 병목이다. 플래시 어텐션은 이 행렬을 통째로 만들지 않고 타일로 나눠 온라인 softmax(블록별 running max·sum, 전체와 오차 2e-8로 동일)로 처리해, 메모리를 으로 줄인다(재 보니 N=4096에서 129배). 계산량은 그대로지만 메모리 IO를 줄여 1.9배 빨라졌다 — 루프라인의 memory-bound를 푸는 전형이다. 긴 문맥 LLM이 가능해진 핵심 장치다.