인지야공/오늘의 AI 이슈/9번째 글
GPU 120만 개 — 고장이 일상이 되는 규모의 산수
실행:
python 딥러닝/daily/DAILY_2026_09_27_checkpoint_scale.py이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. GPU 한 개의 고장률만은 공개 실측(Meta Llama 3 논문)을 가정으로 빌렸다.
1. 무슨 일이 있었나
9월 25일, 일론 머스크가 xAI의 멤피스 데이터센터 Colossus 2의 엔비디아 칩을 연말까지 두 배 넘게 늘리겠다고 밝혔다(Bloomberg, Invezz, Seeking Alpha).
| 시점 | 칩 |
|---|---|
| 지금 | GB200 11만 개 + GB300 44만 개 = 55만 개 |
| 다음 주 | GB300 22만 개 추가 |
| 11월 | GB300 22만 개 추가 |
| 12월 (“운이 좋으면”) | GB300 22만 개 추가 → 121만 개 |
머스크 스스로 마지막 22만 개는 엔비디아 공급과 설치 일정에 달려 불확실하다고 했다.
칩 수는 흔히 “계산력이 몇 배”로 읽힌다. 이 글은 다른 쪽을 본다. 부품이 100만 개를 넘으면 고장은 사건이 아니라 날씨가 된다. 그러면 학습은 어떻게 굴러가야 하나.
2. 핵심 개념 — 묶으면 자주 멈춘다
GPU 한 개는 드물게, 120만 개는 늘 고장 난다
부품 하나가 평균 시간에 한 번 고장 나고 서로 독립이라면, 개를 묶은 클러스터에서 “어딘가 하나라도 고장”은 배 자주 일어난다.
| 기호 | 뜻 |
|---|---|
| GPU 한 개(와 딸린 부품)의 평균 고장 간격 | |
| 한 작업에 묶인 GPU 수 | |
| 클러스터 전체의 평균 고장 간격(MTBF) | |
| 체크포인트 한 번 저장하는 데 걸리는 시간 | |
| 가장 좋은 체크포인트 주기 (Young의 근사식) |
는 지어낼 수 없어서 공개된 실측을 쓴다. Meta는 Llama 3 논문에서 H100 16,384개로 54일 학습하는 동안 예기치 않은 중단이 419회 있었다고 밝혔다. 여기서 GPU 한 개의 중단률을 뽑으면 회/시간, GPU 하나로 보면 평균 5.8년에 한 번이다.
체크포인트는 보험료다
고장이 나면 마지막으로 저장한 지점부터 다시 해야 한다. 그래서 주기적으로 저장(체크포인트)한다. 그런데 저장에도 시간이 든다. 그 거래를 한 줄로 그리면 이렇다.
숫자로 따라가 보자. 기준 규모(16,384개)에서 분, 저장 분이면 분이다. 버리는 비율은 대략 에 재시작 몫 을 더한 13%쯤, 효율로는 87% 근처다.
3. 직접 재 보기
GPU 한 개의 중단률을 위의 값으로 고정하고, 작업 200시간을 끝내는 과정을 몬테카를로로 돌렸다. 고장은 서로 독립인 포아송 사건이고, 어디서든 고장이 나면 작업 전체가 마지막 체크포인트로 돌아간다(하나의 동기식 학습 작업을 가정).
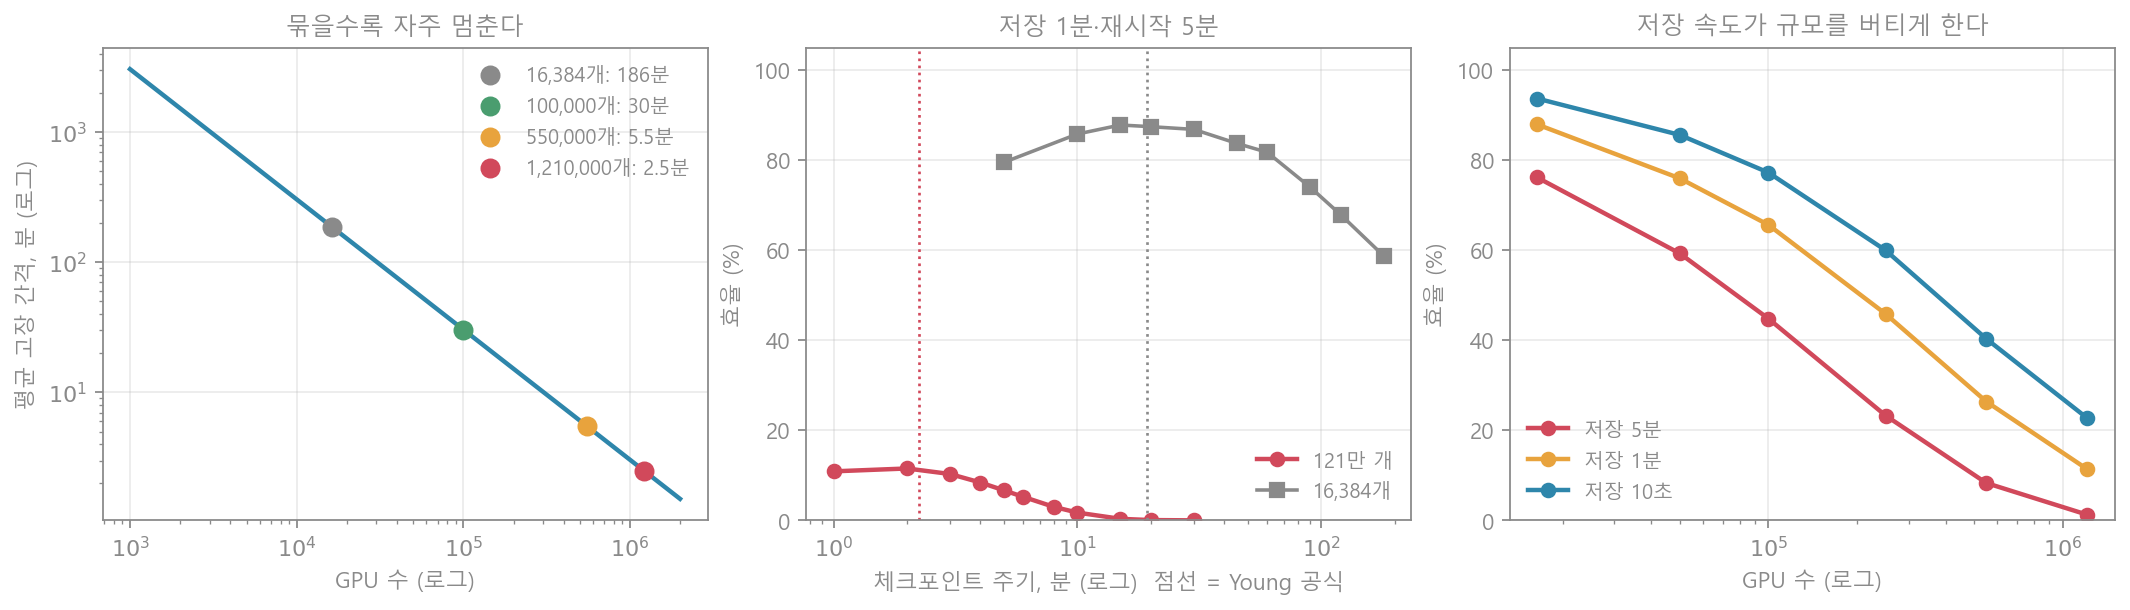
[A] 묶을수록 자주 멈춘다
| 규모 | GPU 수 | 평균 고장 간격 | 하루 고장 |
|---|---|---|---|
| Llama 3 학습 (기준) | 16,384 | 186분 | 7.8회 |
| 10만 개 | 100,000 | 30.4분 | 47회 |
| Colossus 2 지금 | 550,000 | 5.5분 | 260회 |
| Colossus 2 연말 계획 | 1,210,000 | 2.5분 | 573회 |
5.8년에 한 번 고장 나는 부품도 121만 개를 묶으면 2.5분마다 어딘가 멈춘다. 체크포인트 하나 저장하는 동안에도 고장이 날 수 있는 간격이다.
[B] 체크포인트 주기의 거래
저장 1분, 재시작 5분일 때 주기를 바꿔 가며 효율(쓸모 있는 일 ÷ 벽시계 시간)을 쟀다.
| 주기 | 121만 개 | 주기 | 16,384개 | |
|---|---|---|---|---|
| 1분 | 10.9% | 5분 | 79.5% | |
| 2분 | 11.5% | 10분 | 85.8% | |
| 3분 | 10.3% | 15분 | 87.8% | |
| 5분 | 6.7% | 30분 | 86.8% | |
| 10분 | 1.7% | 60분 | 81.8% | |
| 30분 | 0.0% | 180분 | 58.8% |
양쪽 모두 가운데가 가장 높은 언덕 모양이다. 실측 최적은 121만 개에서 2분, 16,384개에서 15분이었고, Young 공식은 각각 2.2분과 19.3분을 준다. 16,384개의 15분과 20분은 효율 차이가 0.4%p라 사실상 같은 꼭대기다.
기준 규모의 87.8%는 Llama 3 논문이 보고한 “90%가 넘는 유효 학습 시간”과 같은 수준이다. 이 모형이 엉뚱한 세계를 그리지는 않는다는 확인이다.
그런데 121만 개에서는 최적 주기를 골라도 11.5%다. 2.5분마다 고장이 나는데 저장에 1분, 재시작에 5분이 든다. 일할 시간이 거의 남지 않는다.
[C] 무엇이 규모를 버티게 하나
각 규모에서 Young 주기를 쓰고, 저장 속도만 바꿨다(재시작 5분).
| GPU 수 | 저장 5분 | 저장 1분 | 저장 10초 |
|---|---|---|---|
| 16,384 | 76.2% | 88.0% | 93.7% |
| 100,000 | 44.8% | 65.6% | 77.3% |
| 550,000 | 8.3% | 26.4% | 40.3% |
| 1,210,000 | 1.3% | 11.4% | 22.7% |
저장을 10초로 줄이면 121만 개에서 22.7%까지 올라온다. 그래도 낮다. 남은 몫은 재시작이다. 저장 10초에서 재시작 시간만 바꿨다.
| 재시작 | 121만 개 효율 |
|---|---|
| 15분 | 9.8% |
| 5분 | 22.5% |
| 1분 | 48.4% |
재시작을 5분에서 1분으로 줄이자 효율이 두 배가 넘었다. 고장이 2.5분마다 오는 세계에서는 고장 뒤 얼마나 빨리 일어서는가가 계산력만큼 중요하다.
4. 흔한 오해와 한계
1. “GPU를 두 배로 늘리면 일도 두 배” — [C]에서 저장 1분일 때 55만 개는 26.4%, 121만 개는 11.4%였다. GPU를 2.2배 늘렸는데 실제로 한 일은 오히려 줄었다(0.264 × 55만 ≈ 14.5만 대 0.114 × 121만 ≈ 13.8만 개 분량). 하나의 동기식 작업으로 묶는 한, 규모는 신뢰성에 곱으로 벌을 받는다.
2. 이 모형은 최악의 설계를 가정했다 — 121만 개 전부를 하나의 동기식 작업으로 돌리고, 고장 하나에 전체가 체크포인트로 돌아간다고 두었다. 실제 대형 클러스터는 이렇게 굴러가지 않는다. 여러 작업을 나눠 돌리고, 여분 노드로 고장 난 자리를 바로 바꾸고, 체크포인트를 디스크 대신 다른 노드의 메모리에 초 단위로 남기고, 일부 노드가 빠져도 계속 도는 탄력적 학습을 쓴다. 이 글의 11.5%는 xAI의 실제 효율이 아니다. 그런 장치들이 왜 필수인지를 보여 주는 숫자다.
3. GPU당 고장률을 그대로 옮긴 가정 — Llama 3의 419회에는 GPU 말고도 네트워크, 호스트, 메모리 문제가 섞여 있다. 세대가 다른 칩(H100 → GB300)과 다른 냉각·전력 환경에서 같은 비율이 나온다는 보장은 없다. 고장이 서로 독립이라는 가정도 전원이나 스위치처럼 여럿을 한꺼번에 떨어뜨리는 공통 원인이 있으면 깨진다(평균의 분산 노트의 상관된 오차와 같은 이야기다).
4. Young 공식은 일 때의 근사다 — 121만 개에서는 주기(2분)와 고장 간격(2.5분)이 비슷해 가정이 깨진다. 그런데도 최적 주기는 2.2분으로 실측 2분 근처를 짚었다. 효율의 근사값()은 이 영역에서 음수가 되어 쓸 수 없다. 이럴 때는 [B]처럼 직접 시뮬레이션해야 한다.
5. 한 문단 요약
GPU 한 개는 평균 5.8년에 한 번 멈추지만(Llama 3 실측에서 뽑은 가정), 121만 개를 묶으면 평균 2.5분마다 어딘가 멈춘다. 고장 대비 체크포인트는 보험료라서, 자주 저장하면 저장 비용이, 드물게 저장하면 잃는 작업이 커진다. 그 최적점은 Young 공식 이 실측과 가깝게 짚었다(121만 개에서 2.2분 대 2분, 16,384개에서 19.3분 대 15분). 하지만 121만 개 전부를 한 작업으로 묶고 고장마다 되돌아가면, 최적 주기에서도 효율은 11.5%에 그친다. 저장을 10초로, 재시작을 1분으로 줄이자 48.4%까지 올라왔다. 칩을 늘리는 것만큼 빨리 저장하고 빨리 일어서는 것이 규모를 정한다. 실제 대형 클러스터가 여분 노드, 메모리 체크포인트, 탄력적 학습을 쓰는 이유가 이 산수에 있다.
참고
- Bloomberg — Elon Musk Aims to Double Colossus 2’s Nvidia Chips by Year-End (2026-09-25)
- Invezz — Musk says xAI’s Colossus 2 could more than double Nvidia chip count (2026-09-25)
- Meta — The Llama 3 Herd of Models (2024), 학습 중 중단 통계
- Young — A first order approximation to the optimum checkpoint interval (1974)
- Daly — A higher order estimate of the optimum checkpoint interval for restart dumps (2006)
- 연재: 분산 학습 편 · 큰 배치 편 · 리틀의 법칙 노트 · 평균의 분산 노트