인지야공/오늘의 AI 이슈/10번째 글
답이 얼마나 길까 — 평균이 아니라 열에 아홉을 예측하는 법
실행:
python 딥러닝/daily/DAILY_2026_09_28_quantile_forecast.py이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 데이터는 합성이다(아래 2절). 원 도구의 수치는 출처를 밝혀 따로 적었다.
1. 무슨 일이 있었나
Token Forecaster 가 Product Hunt에 올라왔다(AIToolly 9/27). Sumcap Research가 MIT 라이선스로 공개한 도구로, Claude의 답변이나 에이전트 한 턴이 출력 토큰을 얼마나 쓸지를 Enter를 누르기 전에 예측한다(GitHub 저장소).
저장소에 적힌 내용을 옮기면 이렇다.
- 무엇으로 예측하나: 모델 종류와 확장 사고(thinking) 켜짐 여부로 묶은 과거 길이의 분위수 표가 뼈대다. 그 위에 세션 위치, 루프 깊이, 앞선 호출 수로 보정하는 그래디언트 부스팅 분위수 트리(깊이 3)를 얹었다.
- 무엇을 내나: 평균이 아니라 p50·p90·p99 세 선이다. 예를 들어 API 호출 한 번은 p50 391, p90 1,739, p99 6,486 토큰이다.
- 얼마나 맞나: 시간상 겹치지 않는 처음 보는 호출 4,146건에서 p90 선이 90.6%(95% 구간 89.7~91.9)를, p99 선이 98.6% 를 덮었다.
- 스스로 밝힌 한계: 예측이 가장 큰 5분의 1 구간에서는 p90이 85.8% 만 덮었다. 다른 사람의 프로젝트에 가져가면 p90 커버리지가 80.9~95.4% 로 흔들렸다.
가장 눈에 띄는 설계 문장은 이것이다 — “모자란 토큰 하나를 남는 토큰 하나의 9배로 친다.” 이 9라는 숫자가 이 글의 출발점이다.
2. 핵심 개념 — 평균이 아니라 분위수
답변 길이는 한쪽으로 꼬리가 길다. 대부분은 짧고, 가끔 아주 길다. 그러면 평균은 쓸모가 애매하다. 예산을 잡거나
max_tokens 를 정할 때 알고 싶은 것은 “보통 얼마”가 아니라 “열에 아홉은 이 안에 들어온다” 는 선이다.
그 선이 90번째 백분위수, p90이다.
| 기호 | 뜻 |
|---|---|
| 실제 답변 길이 | |
| 예측한 선 | |
| 덮고 싶은 비율. p90이면 0.9 | |
| 분위수 손실(핀볼 손실) | |
| 길이 분포의 번째 분위수 |
왜 그 값이 분위수인지는 한 줄이면 된다. 를 조금 올리면, 실제가 보다 컸던 경우( 의 확률)에는 손실이 만큼 줄고, 작았던 경우()에는 만큼 는다. 둘이 같아지는 곳, 를 풀면 다. 모자람과 남음의 가격 비율이 곧 덮는 비율을 정한다. 9 : 1이면 90%다. Token Forecaster의 “9배”는 p90을 고르라는 말과 같다.
3. 직접 재 보기
진짜 사용 기록은 없으니 합성 데이터로 만들었다. 답변 길이를 로그정규분포로 두고, 확장 사고를 켜면(35%) 길이와 흔들림이 둘 다 커지고, 에이전트 루프가 깊을수록 조금씩 길어지게 했다. 원 도구가 쓰는 신호와 같은 종류다. 학습 16,000건, 시험은 원 도구와 같은 4,146건이다. 시험셋은 중앙값 543, 평균 1,288, p90 2,734, 최대 97,968 토큰으로 꼬리가 길다.
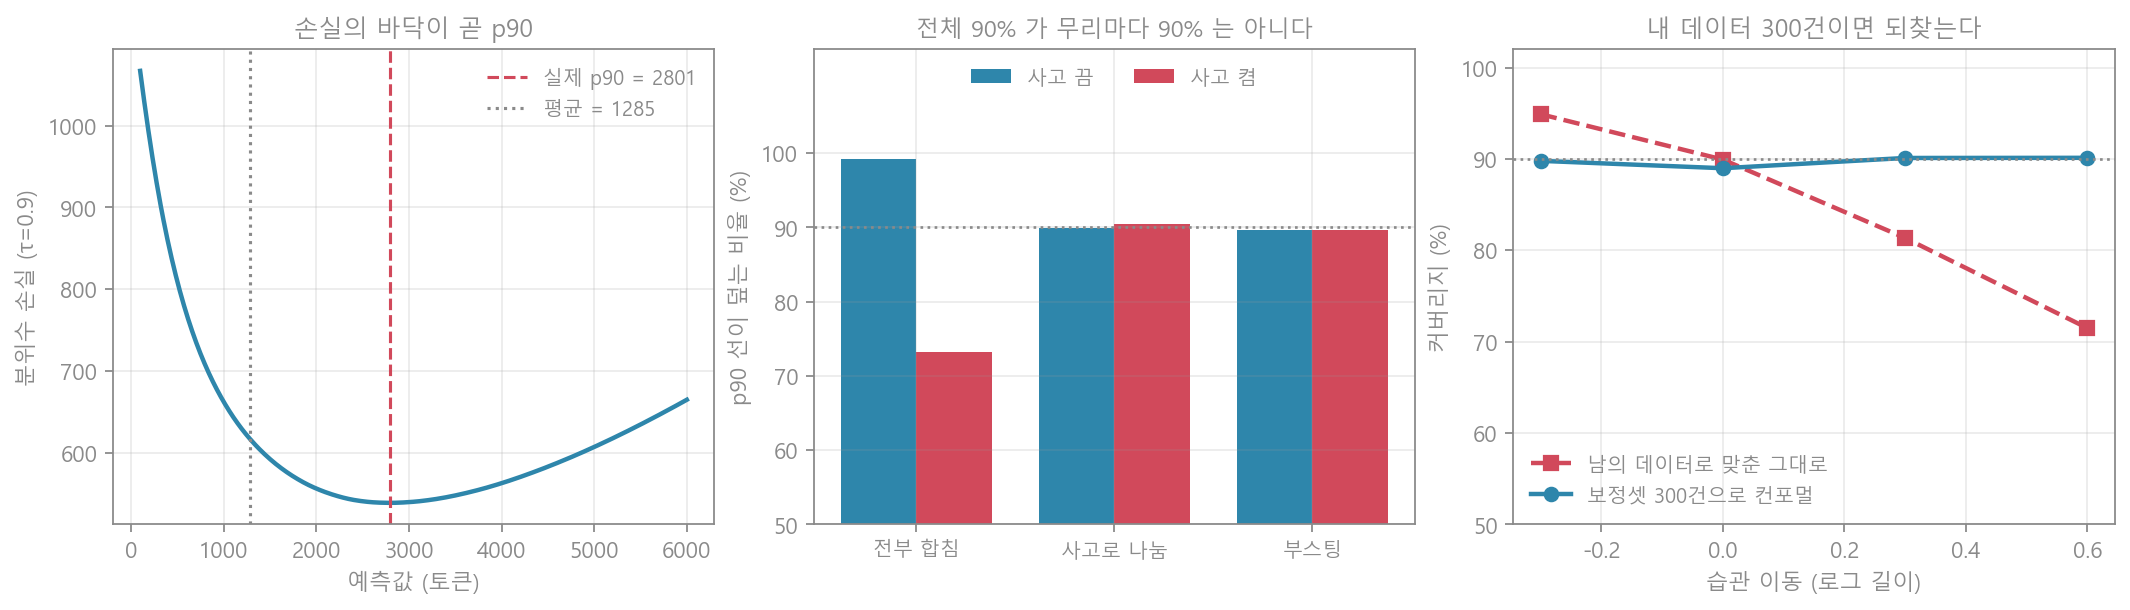
[A] 9배로 치면 p90이 나온다
상수 하나로 예측한다고 하고, 예측값을 100~6,000 토큰 사이에서 바꿔 가며 분위수 손실()을 쟀다. 손실이 가장 작은 값은 2,806 토큰이었고, 학습 데이터의 실제 p90은 2,801 토큰이었다. 격자 간격 안에서 같다.
| 예측값 | 토큰 | 시험셋에서 덮는 비율 | 분위수 손실 |
|---|---|---|---|
| 중앙값 | 549 | 50.6% | 794.3 |
| 평균 | 1,285 | 77.2% | 627.0 |
| p90 | 2,801 | 90.2% | 555.4 |
평균은 긴 꼬리에 끌려 중앙값의 두 배가 넘지만, 그래도 77.2% 만 덮는다. 예산을 평균으로 잡으면 다섯 번에 한 번은 넘친다.
[B] 전체로는 90%, 무리마다는?
p90 선을 세 가지로 만들었다. 전부 합친 p90 하나, 확장 사고 켜짐으로 나눈 p90 둘(원 도구의 조회표 방식), 루프 깊이까지 쓰는 부스팅 분위수 회귀(원 도구처럼 깊이 3).
| 방법 | 전체 커버리지 | 사고 끔 | 사고 켬 | 띠 폭(중앙값) | 분위수 손실 |
|---|---|---|---|---|---|
| 전부 합친 p90 | 90.2% | 99.3% | 73.3% | 2,801 | 555.4 |
| 사고 켜짐으로 나눔 | 90.1% | 89.9% | 90.4% | 1,054 | 414.2 |
| 부스팅 (깊이까지) | 89.6% | 89.6% | 89.6% | 1,248 | 405.3 |
전부 합친 p90도 전체로는 90%를 덮는다. 그런데 들여다보면 사고를 켠 답은 73.3%만 덮고, 끈 답은 99.3%를 덮는다. 평균을 내니 90%가 됐을 뿐이다. 무리를 나누자 양쪽 다 90% 근처가 되고, 띠도 2,801에서 1,054로 좁아졌다. “전체 90%“는 “무리마다 90%“를 보장하지 않는다. 이것을 주변 커버리지(marginal)와 조건부 커버리지(conditional)의 차이라 부른다.
부스팅의 전체 커버리지 89.6%에 95% 구간을 씌우면 [88.7, 90.5] 다. 표본이 4,146건이면 ±0.9%p 안쪽을 흔들림으로 봐야 한다(표본 오차 노트). 원 도구의 90.6% [89.7, 91.9]도 같은 크기의 구간이다.
예측값 크기로 5등분해 보니 부스팅은 88.4~90.3%로 고르게 맞았다. 원 도구는 가장 무거운 구간에서 85.8%로 떨어졌다. 합성 데이터는 로그정규라는 맞는 모양으로 만들어져 있어 이 약점이 드러나지 않았다. 실제 데이터의 꼬리는 그보다 거칠다.
[C] 다른 사람의 데이터에서
모델은 그대로 두고, 시험 데이터만 습관이 다른 사람으로 바꿨다(로그 길이를 통째로 옮김). 그리고 그 사람의 데이터 300건만 보정셋으로 떼어 분할 컨포멀 보정을 했다. 보정셋에서 “실제 − 예측”(로그)을 모아 그 번째 값만큼 띠 전체를 올리거나 내리는 것이다.
| 습관 이동 | 그대로 | 컨포멀 보정 후 | 띠 조정 |
|---|---|---|---|
| −0.3 (더 짧게 씀) | 94.9% | 89.8% | ×0.76 |
| 0.0 (같은 습관) | 89.9% | 89.0% | ×0.96 |
| +0.3 | 81.4% | 90.1% | ×1.40 |
| +0.6 (더 길게 씀) | 71.5% | 90.1% | ×1.86 |
남의 데이터로 맞춘 p90은 나보다 짧게 쓰는 사람에게는 과하게 넓고(94.9%), 길게 쓰는 사람에게는 모자란다(71.5%).
원 도구가 프로젝트마다 80.995.4%로 흔들린 것과 같은 현상이다. 그런데 보정셋 300건 만으로 네 경우 모두 8990%로
돌아왔다. 모델을 다시 학습하지 않고 띠의 높이 하나만 고친 결과다.
4. 흔한 오해와 한계
1. “평균을 알면 예산을 잡을 수 있다” — [A]에서 평균은 77.2%만 덮었다. 꼬리가 긴 양은 평균이 대표값 노릇을 못 한다. 긴 꼬리 편과 지프의 법칙 노트에서 본 모양이 답변 길이에도 있다.
2. “전체 커버리지가 90%면 된 것” — [B]에서 전부 합친 선은 90.2%였지만 사고를 켠 답은 73.3%였다. 무리별로 따로 재 봐야 한다. 캘리브레이션 편의 “전체 ECE는 좋은데 구간마다 틀린다”와 같은 문제다.
3. “90% 선이니 100번 중 90번은 반드시 들어온다” — 표본 4,146건이면 ±0.9%p는 우연이다. 그리고 컨포멀 보정의 보장도 데이터가 서로 바꿔 써도 되는(교환 가능한) 경우에만 성립한다. 에이전트가 세션 안에서 점점 길게 쓰는 것처럼 시간에 따라 흐르는 데이터에서는 보정셋을 계속 새로 해야 한다.
4. 이 실험은 합성 데이터다 — 로그정규와 두 개의 신호로 만든 세계다. 원 도구가 밝힌 대로 실제로는 루프가 몇 번 돌지 미리 알 수 없는 것이 가장 큰 오차 원인이다(알 수 있다면 오차를 63% 줄인다고 적었다). 이 글은 원 도구의 성능을 재현한 것이 아니라 그 설계가 왜 그런 모양인지를 잰 것이다.
5. 한 문단 요약
답변 길이는 꼬리가 길어서 평균으로 예산을 잡으면 77.2%만 덮는다. 알고 싶은 것은 “열에 아홉은 이 안”이라는 p90이고, 모자람을 남음의 9배로 치는 분위수 손실이 정확히 그 값을 고른다(손실 최소 2,806 대 실제 p90 2,801). Token Forecaster의 “모자란 토큰은 9배”가 이 말이다. 다만 전체로 90%를 덮는 선도 무리마다는 다를 수 있다. 전부 합친 p90은 사고를 켠 답을 73.3%만 덮었고, 무리를 나누자 양쪽 모두 90% 근처로 맞으면서 띠도 좁아졌다. 남의 데이터로 맞춘 선은 내 습관이 다르면 71.5%까지 떨어졌지만, 내 데이터 300건으로 띠 높이 하나를 고치는 컨포멀 보정이 90%를 되찾았다.