인지야공/딥러닝 기초 정리/22번째 글
추론 서빙 — 처리량과 지연, 그리고 빈자리
실행:
python NN_40_serving.py(검증 환경: torch 2.8.0+cu129, RTX 5080) [A]와 [B]는 한 GPU 실측, [C]는 모의실험이다. 필요한 공학: 산술 강도 노트.
학습 이야기를 오래 했으니 이번엔 쓰는 쪽이다. 모델은 한 번 만들고 수억 번 돌린다. 그래서 추론 비용이 사실상 전체 비용이고, 그 비용을 정하는 것은 모델 구조가 아니라 어떻게 묶어서 돌리느냐다.
1. 두 가지 국면 — 그림으로 먼저
생성은 성격이 다른 두 단계로 나뉜다.
프리필은 질문 전체를 한 번에 통과시킨다. 행렬이 두꺼워 GPU가 제 실력을 낸다. 디코드는 토큰 하나를 위해 가중치 전체를 읽어야 한다 — 계산할 것은 거의 없는데 읽어 올 것은 그대로다. 이것이 산술 강도가 낮다는 말의 뜻이고, 추론 최적화의 거의 모든 것이 여기서 나온다.
2. 직접 재 보기 B — 같은 GPU, 350배 차이
먼저 두 국면을 나란히 쟀다(12층, 은닉 2048, fp16).
| 한 스텝 | 토큰당 | 실제 성능 | 산술 강도 | |
|---|---|---|---|---|
| 프리필 (질문 512토큰) | 0.664 ms | 1.3 µs | 77.6 TFLOP/s | 512 |
| 프리필 (질문 2048토큰) | 1.955 ms | 1.0 µs | 105.5 TFLOP/s | 2048 |
| 디코드 (한 글자, 혼자) | 0.319 ms | 318.9 µs | 0.3 TFLOP/s | 1 |
| 디코드 (한 글자, 32명 묶음) | 0.257 ms | 8.0 µs | 12.6 TFLOP/s | 32 |
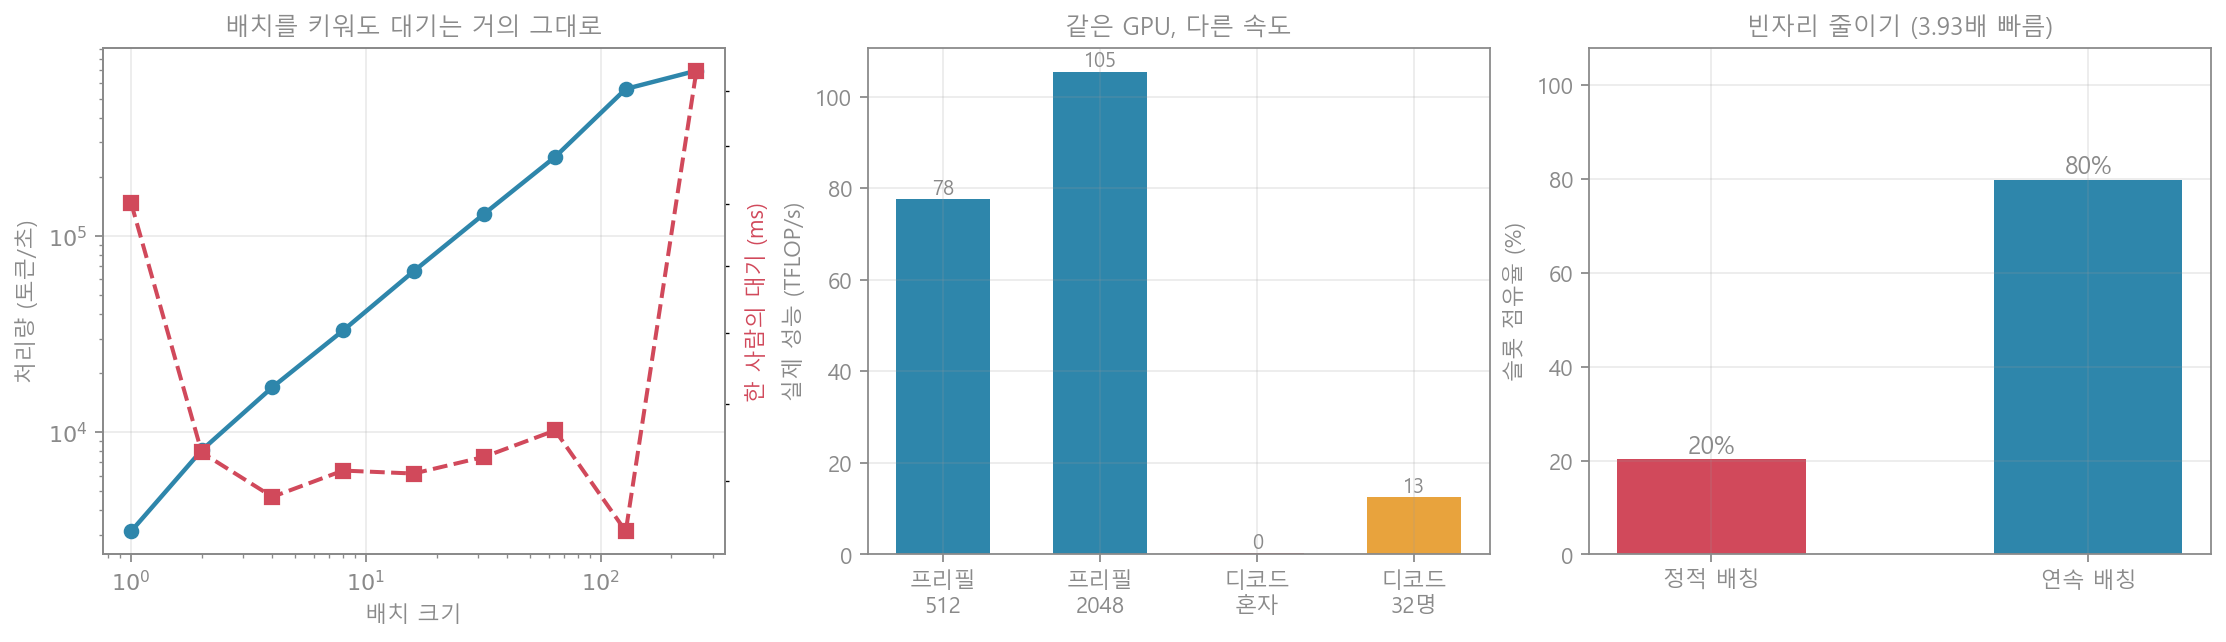
같은 GPU가 105.5 TFLOP/s를 내기도 하고 0.3 TFLOP/s를 내기도 한다 — 350배 차이다. 토큰 하나를 뱉는 데 318.9 µs가 걸리는데, 그중 계산은 거의 없다. 가중치를 메모리에서 끌어오는 시간이다.
그래서 32명을 묶으면 토큰당 8.0 µs로 40배 빨라진다. 한 번 읽어 온 가중치로 32명을 처리하기 때문이고, 산술 강도가 1에서 32로 오른 것이 그 뜻이다. 묶는 것이 곧 성능이다.
3. 직접 재 보기 A — 배치를 키워도 대기가 안 늘어난다
“처리량을 올리면 지연이 늘어난다”는 것이 보통의 직감이다. 정말 그런지 쟀다.
| 배치 크기 | 1 | 8 | 32 | 128 | 256 |
|---|---|---|---|---|---|
| 한 스텝 (= 한 사람의 대기) | 0.321 ms | 0.243 ms | 0.246 ms | 0.228 ms | 0.368 ms |
| 처리량 | 3,120 토큰/초 | 32,971 | 130,006 | 561,933 | 696,195 |
처리량은 223배가 됐는데 대기는 1.1배다. 8명에서 128명까지는 오히려 대기가 줄기까지 했다.
이유는 2절이다. 디코드는 메모리에 묶여 있어서, 자리를 채워도 걸리는 시간이 거의 그대로다. 빈 트럭이나 꽉 찬 트럭이나 한 번 왕복하는 시간은 같은 것과 같다. 맞바꿈이 시작되는 것은 계산이 다시 병목이 되는 지점부터이고, 여기서는 256에서 그 조짐이 보인다(0.228 → 0.368 ms).
그러니 추론 서빙의 첫 번째 규칙은 “자리를 채워라”다. 비어 있는 배치 슬롯은 공짜로 얻을 수 있었던 처리량을 그냥 버리는 것이다.
4. 직접 재 보기 C — 빈자리는 어디서 생기나
문제는 요청마다 생성 길이가 다르다는 것이다. 어떤 사람은 20토큰, 어떤 사람은 1,300토큰을 받는다. 한 묶음을 통째로 돌리고 다 끝나야 다음 묶음을 받는 방식(정적 배칭)이라면, 가장 긴 요청이 끝날 때까지 나머지 자리가 놀게 된다.
요청 600개(길이 중앙값 70토큰, 최대 1,327토큰), 슬롯 32개로 모의실험했다.
| 총 스텝 | 슬롯 점유율 | |
|---|---|---|
| 정적 배칭 | 9,602 | 20.3% |
| 연속 배칭 | 2,445 | 79.9% |
정적 배칭은 슬롯의 20.3%만 쓰고 있었다. 끝난 자리에 다음 요청을 바로 채우는 것(연속 배칭)만으로 점유율이 79.9%가 되고 전체가 3.93배 빨라진다. 모델도 GPU도 그대로인데, 비는 자리를 안 비워 두는 것 하나로 얻은 이득이다.
위(빨강)가 정적 배칭이다. 한 묶음이 시작될 때는 꽉 차 있다가 짧은 요청들이 먼저 끝나면서 점점 비어 가고, 가장 긴 하나가 끝날 때까지 그 상태로 머문다. 아래(파랑)는 빈자리가 생기는 즉시 채워져 계속 꽉 차 있다.
이것이 오늘날 추론 서버(vLLM, TGI 등)가 하는 일의 핵심이다. 여기에 KV 캐시 편의 메모리 문제가 겹치는데, 캐시를 페이지 단위로 쪼개 관리하는 기법(PagedAttention)이 바로 자리를 더 촘촘히 채우기 위한 장치다.
5. 흔한 오해와 한계
- “배치를 키우면 느려진다” — 디코드 구간에서는 거의 안 그렇다(3절, 223배 처리량에 대기 1.1배). 계산이 병목이 되는 지점부터 맞바꿈이 시작된다.
- “GPU 성능은 하나의 숫자” — 아니다. 같은 카드가 105.5와 0.3 TFLOP/s 사이를 오간다(2절). 벤치마크 숫자를 볼 때 어느 국면의 값인지를 물어야 한다.
- “모델을 작게 만드는 게 제일 급하다” — 4절에서는 모델을 건드리지 않고 3.93배를 얻었다. 지식 증류 편·양자화 편 이전에 볼 것이 남아 있을 수 있다.
- “점유율이 높으면 다 좋다” — 자리를 너무 많이 채우면 KV 캐시가 넘치고, 긴 요청이 짧은 요청의 응답을 늦춘다. 공정성과 꼬리 지연은 별도의 문제다.
- 이 글의 실험 — 12층짜리 작은 모델과 단순한 모의실험이다. 350배·3.93배 같은 수는 이 설정의 값이고, 요점은 디코드는 읽기에 묶여 있고, 그래서 묶는 것이 곧 성능이며, 빈자리가 곧 손해라는 구조다.
6. 한 문단 요약
추론은 성격이 다른 두 국면으로 나뉜다. 프리필은 토큰이 많아 계산에 묶이고(105.5 TFLOP/s), 디코드는 토큰 하나를 위해 가중치 전체를 읽어야 해서 읽기에 묶인다(0.3 TFLOP/s) — 같은 GPU에서 350배 차이다. 이 성질 덕에 배치를 1에서 256으로 키워도 처리량은 223배가 되는 동안 대기는 1.1배만 늘었다. 즉 추론 서빙의 승부는 자리를 채우는 것에 걸려 있다. 그런데 요청마다 생성 길이가 제각각이라, 한 묶음을 통째로 기다리는 정적 배칭은 슬롯의 20.3%만 쓰고 있었다. 끝난 자리를 바로 채우는 것만으로 점유율이 79.9%가 되고 전체가 3.93배 빨라진다 — 모델도 GPU도 그대로 둔 채로.