인지야공/딥러닝 기초 정리/40번째 글
평가 — 벤치마크 점수는 얼마나 믿을 수 있나
실행:
python NN_34_evaluation.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 필요한 수학: 표본 오차 노트.
“A 모델 78.2%, B 모델 77.5%.” 이런 표를 매일 본다. 그런데 그 0.7%p는 무엇인가. 데이터 편에서 오염이 점수를 부풀리는 것을 봤다. 이번엔 오염이 전혀 없어도 남는 문제, 점수 자체의 흔들림을 잰다.
방법은 모의실험이다. 진짜 실력 를 정해 두고 채점을 수십만 번 반복해, 나오는 점수가 어떻게 흩어지는지 본다. 현실에서는 진짜 실력을 모르지만, 여기서는 알기 때문에 점수와 실력의 차이를 직접 볼 수 있다.
1. 표본 오차 — 같은 실력, 다른 점수
진짜 실력이 정확히 75%인 모델을 문항 수를 바꿔 가며 채점했다.
직접 재 보기 A
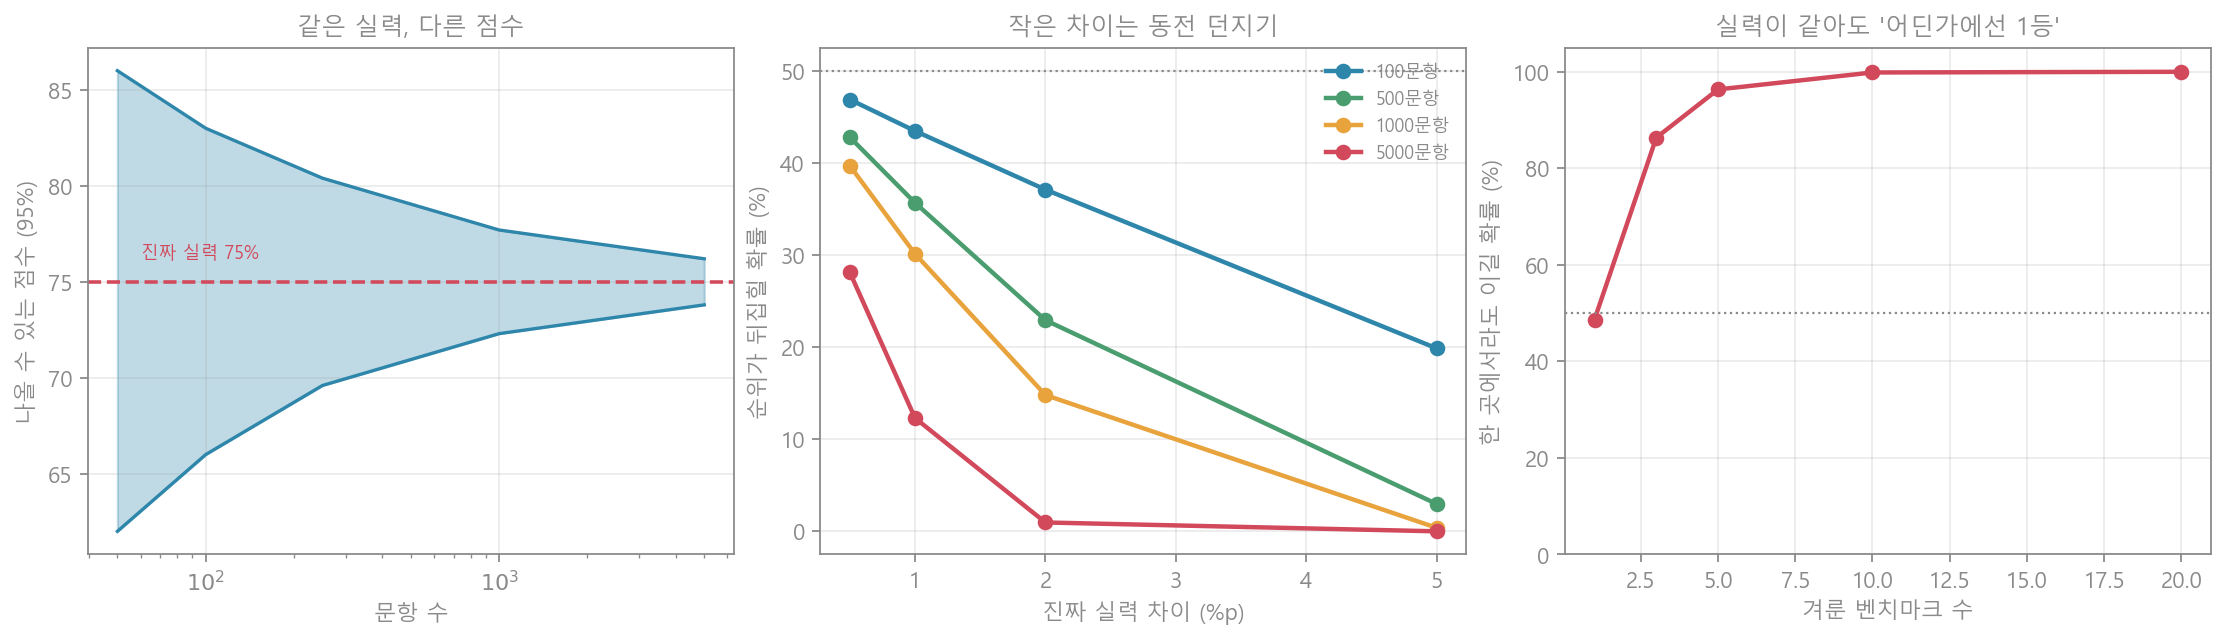
| 문항 수 | 50 | 100 | 250 | 1,000 | 5,000 |
|---|---|---|---|---|---|
| 점수 표준편차 | 6.12%p | 4.34%p | 2.73%p | 1.37%p | 0.61%p |
| 95% 구간 | 62.0~86.0% | 66.0~83.0% | 69.6~80.4% | 72.3~77.7% | 73.8~76.2% |
| 구간 폭 | 24.0%p | 17.0%p | 10.8%p | 5.4%p | 2.4%p |
실력은 내내 75%다. 흔들리는 것은 점수뿐이다. 그런데 100문항에서는 66%가 나올 수도 83%가 나올 수도 있다. 17%p 폭이다. 벤치마크가 수백 문항 규모인 경우가 흔하다는 점을 떠올리면, 소수점 한 자리는 말할 것도 없고 몇 %p 차이도 해석하기 어렵다.
오차는 이라(노트) 문항을 4배로 늘려야 오차가 절반이 된다. 정밀한 평가가 비싼 이유이고, 그래서 논문들이 여러 시드로 반복하고 신뢰구간을 함께 싣는다.
2. 순위 뒤집힘 — 더 나은 모델이 지는 확률
실무에서 궁금한 것은 점수가 아니라 순위다. 진짜로 더 나은 모델이 시험에서 지는 일은 얼마나 흔할까.
직접 재 보기 B
| 문항 수 \ 진짜 실력 차 | 0.5%p | 1%p | 2%p | 5%p |
|---|---|---|---|---|
| 100문항 | 46.9% | 43.5% | 37.1% | 19.9% |
| 500문항 | 42.8% | 35.7% | 22.9% | 3.0% |
| 1,000문항 | 39.7% | 30.1% | 14.8% | 0.4% |
| 5,000문항 | 28.1% | 12.3% | 1.0% | 0.0% |
(값은 순위가 뒤집힐 확률. 50%면 동전 던지기와 같다.)
100문항에서 1%p 우위는 43.5%의 확률로 뒤집힌다 — 거의 동전 던지기다. 5,000문항을 써도 0.5%p 차이는 28.1%가 뒤집힌다. 즉 리더보드에서 1%p 차이로 갈린 순위는 대부분 의미가 없다.
반대로 읽으면 이것도 사실이다 — 5%p 차이는 1,000문항이면 거의 확실하다(뒤집힘 0.4%). “차이가 의미 있으려면 얼마나 커야 하는가”를 문항 수가 정한다.
3. 여러 벤치마크 — “어딘가에서는 1등”
마지막이 가장 고약하다. 실력이 완전히 똑같은 두 모델을 여러 벤치마크(각 500문항)에서 겨루게 했다.
직접 재 보기 C
| 벤치마크 수 | 1 | 3 | 5 | 10 | 20 |
|---|---|---|---|---|---|
| 한 곳에서라도 이길 확률 | 48.7% | 86.4% | 96.3% | 99.9% | 100.0% |
| 가장 유리한 곳의 평균 격차 | +0.01%p | +2.31%p | +3.19%p | +4.21%p | +5.12%p |
두 모델의 실력은 완전히 같다. 그런데 벤치마크 10개를 돌리면 99.9%의 확률로 어느 한 곳에서는 이기고, 그 최고 성적은 평균 4.21%p 앞선다. 20개면 5.12%p다.
그러니 “우리 모델이 X 벤치마크에서 4%p 앞섰다”는 문장은, 몇 개의 벤치마크 중에서 고른 것인지를 모르면 아무 정보가 없다. 이것이 통계에서 말하는 다중 비교 문제이고, 모델 발표 자료가 유리한 지표만 고르는(cherry-picking) 유혹에 노출되는 구조적 이유다. 악의가 없어도 일어난다 — 여러 지표를 보고 가장 잘 나온 것을 소개하는 것은 자연스러운 일이기 때문이다.
4. 흔한 오해와 한계
- “78.2% vs 77.5%면 앞선 것” — 문항 수를 먼저 물어야 한다. 100문항이면 그 차이는 잡음에 묻힌다(2절).
- “큰 벤치마크면 괜찮다” — 5,000문항도 0.5%p 차이는 28.1%가 뒤집힌다.
- “여러 벤치마크에서 이겼으니 확실하다” — 몇 개 중 몇 개인지가 핵심이다(3절).
- “점수만 보면 된다” — 데이터 편의 오염까지 겹치면 점수와 실력의 거리는 더 멀어진다. 여기서 잰 것은 오염이 전혀 없을 때도 남는 불확실성이다.
- 이 글의 실험 — 모든 문항이 독립이고 난이도가 같다고 가정한 모의실험이다. 실제 벤치마크는 문항끼리 상관이 있어 실제 오차는 이보다 더 클 수 있다. 요점은 점수에는 폭이 있고, 순위는 그보다 더 불안정하며, 지표를 늘리면 우연한 승리가 반드시 생긴다는 구조다.
5. 한 문단 요약
벤치마크 점수는 실력이 아니라 실력의 추정치이고, 추정에는 폭이 있다. 실력이 정확히 75%인 모델도 100문항에서는 66~83% 아무 값이나 나왔다. 순위는 더 불안정해서, 진짜로 1%p 앞선 모델이 100문항 시험에서 43.5%의 확률로 진다. 그리고 실력이 완전히 같은 두 모델도 벤치마크 10개를 돌리면 99.9% 확률로 어딘가에서 이기고, 그 최고 성적은 평균 4.21%p 앞선다. 그러니 표를 읽을 때 물어야 할 것은 세 가지다 — 문항이 몇 개인가, 차이가 오차보다 큰가, 몇 개의 지표 중에서 고른 것인가.