인지야공/딥러닝 기초 정리/10번째 글
가중치 초기화 — 첫 걸음의 크기
실행:
python NN_53_initialization.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
nn.Linear 를 만들면 PyTorch가 가중치를 알아서 뿌려 준다. 그래서 초기화는 신경 쓸 일이 아닌 것처럼 보인다.
그런데 정규화와 잔차 편의 장치들이 없던 시절에는 초기화가 곧
깊이의 한계였다. 지금도 정규화 없이 층을 쌓거나 직접 층을 만들 때는 그대로 문제가 된다.
1. 층마다 곱해지는 배율 — 그림으로 먼저
선형층 하나를 지나면 출력의 분산은 입력의 분산에 어떤 배율을 곱한 값이 된다. 층이 20개면 그 배율이 20번 곱해진다. 배율이 0.9면 , 1.1이면 이다. 1에서 조금만 벗어나도 깊이가 그것을 부풀린다.
그 배율을 1로 맞추는 조건이 초기화 규칙이다. 입력이 개인 선형층에서 가중치 분산이 이면 출력 분산은 대략 배가 된다. 그런데 ReLU는 음수 절반을 0으로 만들어 분산을 반으로 줄인다.
| 기호 | 뜻 |
|---|---|
| 번째 층의 출력 | |
| 그 층의 입력 개수(fan-in). 이 실험에서는 256 | |
| 가중치를 뿌리는 정규분포의 분산 | |
| ReLU가 절반을 0으로 만드는 몫 |
숫자로 따라가 보자. , 이면 배율은 , 표준편차로는 배다. 층마다 0.113배, 20층이면 이 줄어든다. He는 , 정확히 1배다.
2. 직접 재 보기
폭 256짜리 층을 20개 쌓고, 표준편차 1인 입력을 넣어 층마다 출력의 표준편차를 쟀다.
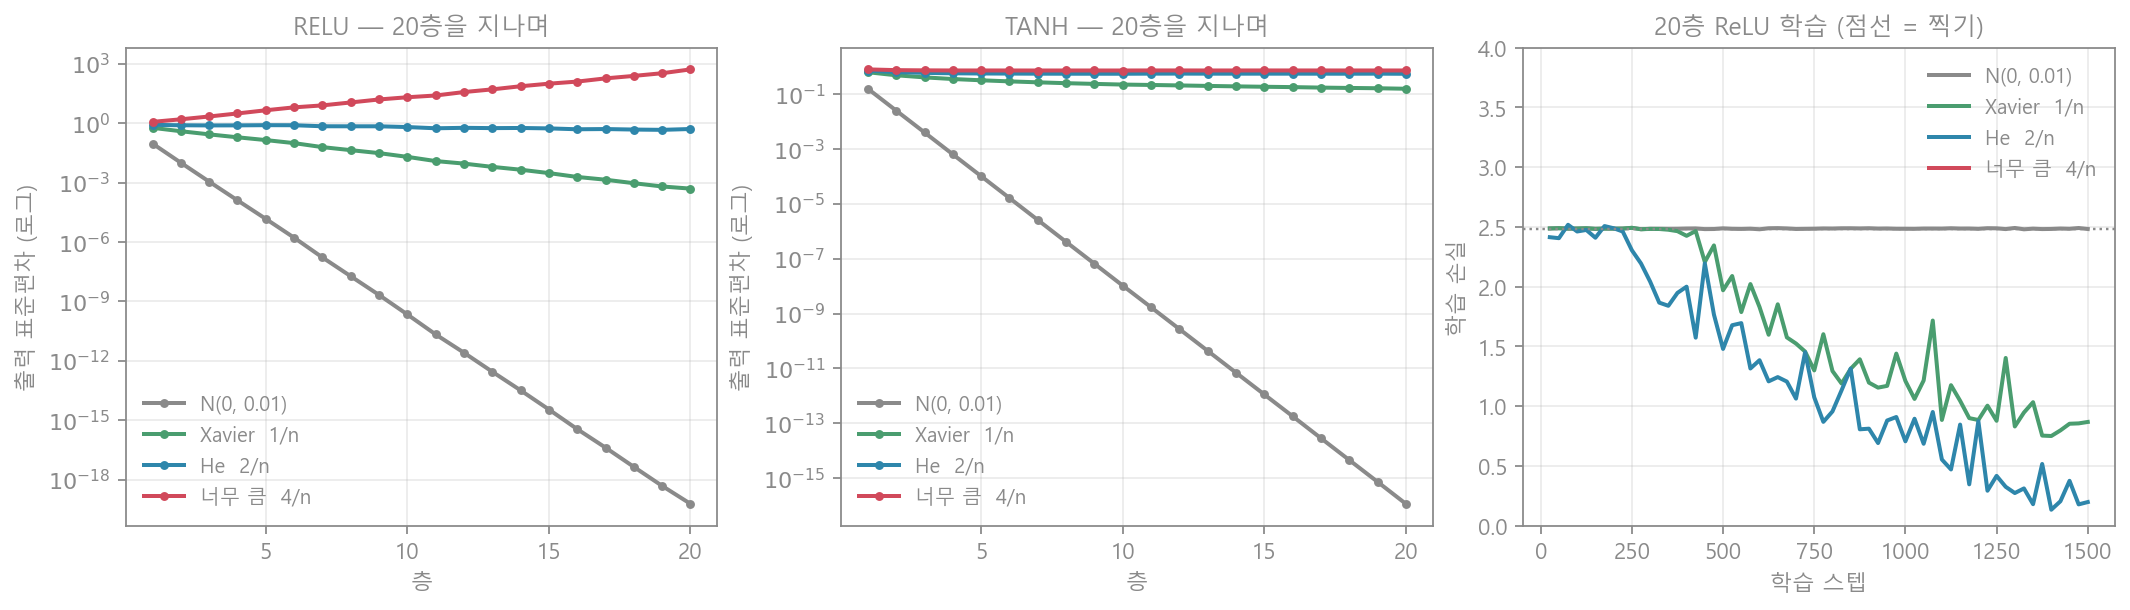
[A] 신호가 20층을 지나면
| 활성화 | 초기화 | 1층 | 5층 | 10층 | 20층 |
|---|---|---|---|---|---|
| ReLU | 0.094 | ||||
| ReLU | Xavier | 0.586 | 0.141 | 0.020 | |
| ReLU | He | 0.829 | 0.798 | 0.641 | 0.511 |
| ReLU | 1.17 | 4.51 | 20.5 | 523 | |
| tanh | 0.157 | ||||
| tanh | Xavier | 0.629 | 0.319 | 0.223 | 0.157 |
| tanh | He | 0.722 | 0.566 | 0.553 | 0.552 |
| tanh | 0.797 | 0.729 | 0.726 | 0.727 |
ReLU 쪽은 계산과 그대로 맞는다. 은 1층→5층 사이가 배인데, 계산한 와 같다. Xavier는 ReLU의 “반으로 줄이기”를 모르니 층마다 약 0.7배()씩 줄고, 은 약 1.4배()씩 는다. He만 20층 뒤에도 0.51로 남는다.
tanh는 모양이 다르다. tanh는 값을 사이로 누르기 때문에 폭발하지 않는다. 은 0.727에 머문다. 그렇다고 좋은 것은 아니다. 대부분의 값이 근처로 밀리면 그 자리의 미분 이 0에 가까워 기울기가 흐르지 않는다 (포화). 그리고 tanh에서 Xavier도 천천히 줄어든다(0.629 → 0.157). Xavier의 은 tanh를 기울기 1인 직선으로 본 근사인데, 실제 tanh는 입력보다 조금씩 작은 값을 내기 때문이다.
[B] 그 차이가 학습을 가르는가
20층 ReLU 망을 정규화 없이, 같은 옵티마이저(SGD, 모멘텀 0.9)로 1,500스텝 학습시켰다.
| 초기화 | 첫 층 기울기 크기 | 500스텝 손실 | 시험 정확도 |
|---|---|---|---|
| 2.488 | 8.3% | ||
| Xavier | 1.969 | 43.2% | |
| He | 1.478 | 67.4% | |
| 발산 (nan) | 8.3% |
찍기의 손실은 , 정확도는 8.3%다.
은 500스텝이 지나도 손실이 찍기와 같은 2.488이다. 첫 층까지 오는 기울기가 이라 파라미터가 사실상 움직이지 않는다. 은 기울기가 규모라 첫 몇 걸음에 값이 튀어 nan이 되었다. 신호의 크기가 앞으로 가는 방향([A])과 기울기가 뒤로 가는 방향이 같은 배율을 겪는다. 역전파 편의 연쇄법칙이 층마다 곱하는 그 국소 미분이다.
[C] 대칭 깨기 — 같은 값으로 시작하면
크기가 문제의 전부는 아니다. 가중치를 모두 같은 값으로 두면 어떻게 될까. 은닉층 256개짜리 2층 망에서 쟀다.
| 초기화 | 학습 후 1층 뉴런 중 서로 다른 것 | 시험 정확도 |
|---|---|---|
| 모두 0.05 | 1 / 256 | 8.3% |
| 모두 0 | 1 / 256 | 8.3% |
| He (무작위) | 256 / 256 | 79.6% |
같은 값에서 출발한 뉴런은 같은 입력을 받아 같은 출력을 내고, 역전파에서도 똑같은 기울기를 받는다. 그래서 1,500스텝 뒤에도 256개가 완전히 같다. 뉴런을 256개 가졌지만 1개와 같은 망이다. 초기화에 무작위가 들어가야 하는 이유는 크기가 아니라 이 대칭을 깨기 위해서다.
3. 흔한 오해와 한계
1. “작게 초기화하면 안전하다” — 반대다. [B]에서 이 가장 확실하게 학습을 막았다. 작은 값은 폭발은 안 하지만 층마다 곱해져 신호와 기울기를 함께 없앤다.
2. “tanh는 폭발하지 않으니 초기화가 덜 중요하다” — 크기는 안 터지지만 포화로 기울기가 죽는다. 표준편차만 보면 0.727로 멀쩡해 보이는 이 그런 경우다.
3. “He 초기화면 깊이 문제는 끝났다” — 20층 He도 0.83 → 0.51로 조금씩 준다. 유한한 폭(256)에서의 흔들림이 쌓인 것이다. 100층, 1000층은 초기화만으로 버티지 못한다. 그래서 정규화와 잔차 편의 정규화가 매 층 크기를 되돌리고, 잔차 연결이 “배율 1”을 구조로 보장한다.
4. 이 실험은 PyTorch 기본값을 쓰지 않았다 — nn.Linear 의 기본 초기화는 균등분포로 대략 이다.
정규화 없이 ReLU를 깊게 쌓는다면 nn.init.kaiming_normal_ 로 He를 직접 주는 것이 안전하다.
4. 한 문단 요약
선형층을 지날 때마다 신호의 분산은 배, ReLU를 지나면 다시 절반이 된다. 그 배율이 층 수만큼 곱해지므로 1에서 조금만 벗어나도 깊이가 부풀린다. 20층 ReLU에서 은 신호를 까지 줄였고 기울기도 이라 학습이 찍기 수준(손실 2.488)에서 멈췄다. 은 523까지 불어나 발산했다. 분산을 으로 맞춘 He는 20층 뒤에도 0.51을 남기고 67.4%까지 배웠다. 그리고 무작위가 필요한 이유는 크기가 아니라 대칭이다 — 모든 가중치를 같은 값으로 두면 뉴런 256개가 끝까지 1개처럼 움직였다.