인지야공/딥러닝 기초 정리/35번째 글
문맥 내 학습과 유도 헤드 — 능력이 켜지는 순간
실행:
python NN_38_induction.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
언어모델에 예시 몇 개를 보여 주면 학습을 하지 않고도 새 규칙을 따라 한다. 가중치는 하나도 안 바뀌는데 어떻게 그럴까. 기계적 해석가능성 편에서 회로를 들여다봤다면, 이번에는 그중 가장 유명한 회로인 유도 헤드가 생기는 순간을 잡아 본다.
과제는 이렇다. 무작위 수열 한가운데에 [키][값]이 한 번 나오고, 맨 끝에 같은 키가 다시 나온다.
다음 토큰을 맞혀야 한다. 핵심은 키와 값이 문장마다 새로 뽑힌다는 것이다 — 외울 수가 없고,
그 문장 안에서 읽어 내는 수밖에 없다. 이것이 문맥 내 학습의 가장 벌거벗은 형태다.
1. 왜 두 단계인가 — 그림으로 먼저
마지막 자리에서 답을 내려면 “아까 이 키가 나온 자리의 바로 다음 칸”을 봐야 한다. 그런데 어텐션은 내용으로 찾는다. 키가 있는 자리는 찾을 수 있지만, 정답은 그 옆 칸에 있다.
1층이 각 칸에 “내 바로 앞은 무엇이었나”를 적어 둔다. 그러면 값 칸은 자기가 어떤 키 뒤에 있었는지를 품게 된다. 2층에서 마지막 키가 그 표시를 내용으로 찾아가 값을 집어 온다. 두 단계다 — 그래서 어텐션 한 층으로는 원리적으로 안 된다.
2. 직접 재 보기 A — 능력이 켜지는 순간
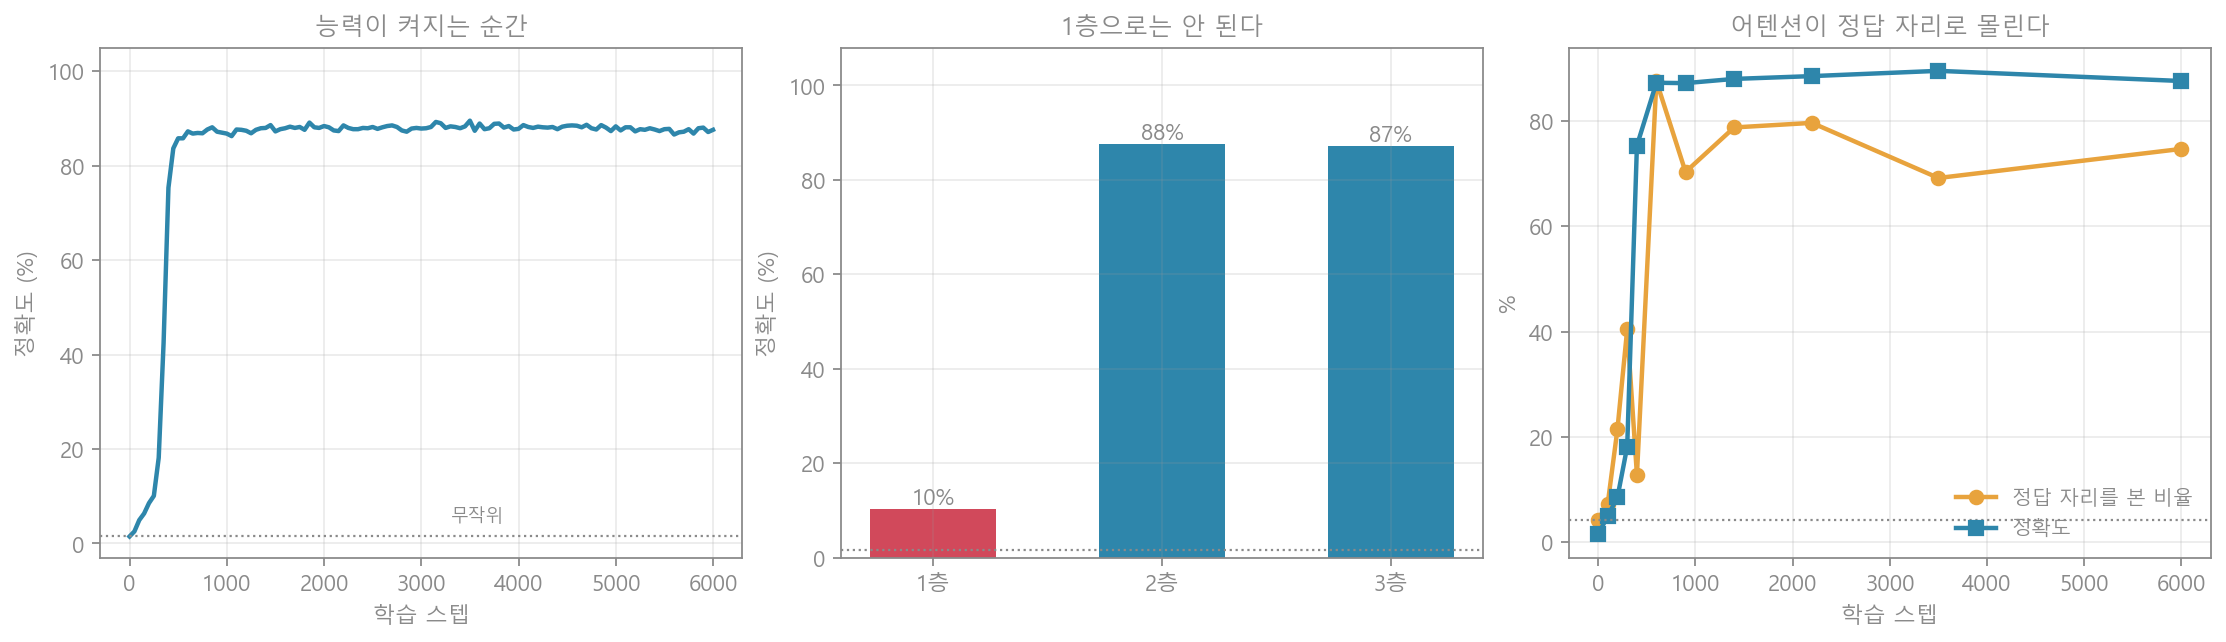
| 학습 스텝 | 0 | 100 | 200 | 300 | 400 | 600 | 6,000 |
|---|---|---|---|---|---|---|---|
| 정확도 | 1.5% | 4.9% | 8.5% | 18.1% | 75.3% | 87.3% | 87.6% |
무작위로 찍으면 1.6%다. 그런데 곡선이 완만하지 않다. 10%를 넘은 것이 250스텝, 80%를 넘은 것이 450스텝 — 200스텝 사이에 갈아탄다. 그 앞의 250스텝 동안에는 거의 아무 일도 없어 보인다.
이 모양이 중요하다. 밖에서 보면 없던 능력이 갑자기 생긴 것처럼 보이지만, 안에서는 회로가 조금씩 맞춰지다가 쓸 만해지는 순간 한꺼번에 반영된 것이다. 큰 모델에서 보고되는 “창발”의 상당수가 이런 모양이고, 그래서 손실 곡선만 보면 놓치기 쉽다.
(천장은 89.5%다. 키가 우연히 문맥 안에 한 번 더 나오면 답이 갈리기 때문이고, 모델 탓이 아니다.)
3. 직접 재 보기 B — 층이 둘이어야 한다
1절의 설명이 맞다면 1층으로는 안 되어야 한다. 층 수만 바꿔 같은 과제를 학습시켰다.
| 어텐션 층 수 | 1층 | 2층 | 3층 |
|---|---|---|---|
| 정확도 | 10.2% | 87.6% | 87.1% |
1층은 10.2%에 머문다 — 무작위 1.6%보다는 낫지만 과제를 못 푼다.. 2층에서 87.6%로 뛰고, 3층을 더 쌓아도 달라지지 않는다. 필요한 단계가 정확히 둘이기 때문이다.
이 “층 하나 차이로 되고 안 되고가 갈리는” 현상은 긴 문맥 편에서 같은 과제를 쓸 때도 만났다. 능력이 파라미터 수가 아니라 구조가 허락하는 단계 수에 묶여 있다는 뜻이다.
4. 직접 재 보기 C — 어텐션이 어디로 가는지 보기
능력이 켜지는 그 구간에 어텐션 지도를 찍었다. 마지막 자리(주황 가로선)에서 정답 자리(초록 세로선, 키 바로 다음 칸)를 얼마나 보는지가 관심사다.
| 학습 스텝 | 0 | 200 | 300 | 600 | 2,200 |
|---|---|---|---|---|---|
| 정답 자리를 본 비율 | 4.2% | 21.5% | 40.5% | 87.6% | 79.6% |
| 정확도 | 1.5% | 8.5% | 18.1% | 87.3% | 88.5% |
아무 데나 보면 4.2%(1/24)다. 처음에는 딱 그 수준이다 — 지도가 균일하다. 그러다 정확도가 오르는 바로 그 구간에서 어텐션이 한 칸으로 몰린다(87.6%). 애니메이션에서 밝은 점 하나가 초록 선 위로 올라붙는 것이 그 순간이다.
즉 “정확도가 올랐다”와 “어텐션이 정답 자리를 가리키게 됐다”가 같은 사건이다. 성능 지표 뒤에 무엇이 바뀌었는지를 볼 수 있다는 점에서, 이것이 기계적 해석가능성이 하려는 일의 축소판이다.
(이 표는 예시 한 문장의 어텐션이라 값이 조금 출렁인다. 400스텝에서 12.8%로 튄 것도 그 때문이다.)
5. 흔한 오해와 한계
- “문맥 내 학습은 학습이 아니다” — 가중치는 안 바뀌지만, 모델 안에서 문맥을 읽어 규칙을 세우는 계산이 실제로 일어난다. 그 계산을 하는 회로가 이 글의 유도 헤드다.
- “능력은 서서히 늘어난다” — 2절처럼 갈아타는 모양일 때가 있다. 중간에 멈추면 “안 되는 모델”로 보인다.
- “층이 많을수록 낫다” — 3절에서 3층은 2층과 같았다. 필요한 단계를 넘으면 그 과제에서는 이득이 없다.
- “어텐션 지도가 곧 설명이다” — 조심해야 한다. 여기서는 과제가 단순해 지도와 성능이 맞아떨어졌지만, 복잡한 모델에서 어텐션 지도만으로 해석하는 것은 위험하다는 지적이 많다.
- 이 글의 실험 — 어텐션만 있는 2층 장난감이다. 87.6%·200스텝 같은 수는 이 설정의 값이고, 요점은 문맥 내 학습에는 최소 두 단계가 필요하고, 그 회로가 갖춰지는 순간 능력이 한꺼번에 켜진다는 구조다.
6. 한 문단 요약
프롬프트의 예시만 보고 규칙을 따라 하는 일은 문맥에서 찾아 복사하는 회로로 설명된다. 그 회로는 두 단계다 — 1층이 각 칸에 “내 앞은 무엇이었나”를 적고, 2층이 그것을 내용으로 찾아가 값을 가져온다. 그래서 어텐션 1층으로는 10.2%, 2층부터 87.6%였고 3층을 더 쌓아도 달라지지 않았다. 학습 곡선은 완만하지 않았다. 250스텝까지 10%에 머물다가 200스텝 만에 80%로 갈아탔고, 바로 그 구간에서 어텐션이 정답 자리로 4.2%에서 87.6%까지 몰렸다. 능력이 켜지는 것과 회로가 갖춰지는 것은 같은 사건이다.