인지야공/딥러닝 기초 정리/3번째 글
합성곱 신경망 — 같은 필터를 어디에나 댄다
실행:
python NN_52_cnn.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 데이터는 이 연재의 도형 12종이고, 생성기는딥러닝/shapes.py에 있다.
뒤의 비전 트랜스포머 편에서는 이미지를 조각내 토큰으로 넣는다. 그보다 10년 넘게 먼저 이미지를 다룬 방법이 합성곱이다. 그리고 지금도 작은 데이터, 작은 모델에서는 합성곱이 이긴다. 왜 이기는지를 재 본다.
1. 같은 필터를 어디에나 — 그림으로 먼저
완전연결층(MLP)은 픽셀마다 따로 가중치를 둔다. 왼쪽 위 모서리의 원을 알아보는 가중치와 오른쪽 아래 모서리의 원을 알아보는 가중치가 서로 다른 파라미터다. 그래서 원을 모든 자리에서 한 번씩 보여 줘야 한다.
합성곱은 작은 필터 하나(예: 3×3)를 이미지 전체에 미끄러뜨리며 같은 가중치로 곱한다. 한 자리에서 배운 것을 모든 자리에서 쓴다.
| 성질 | 무엇이 만드나 | 뜻 |
|---|---|---|
| 가중치 공유 | 합성곱 | 같은 필터를 모든 위치에 쓴다. 파라미터가 이미지 크기와 무관하다 |
| 등변(equivariance) | 합성곱 | 입력을 옮기면 특징 맵도 같이 옮겨진다 |
| 불변(invariance) | 전체 평균·풀링 | 입력을 옮겨도 출력이 같다 |
둘째와 셋째를 구분하는 것이 이 글의 절반이다. 합성곱만으로는 “어디 있든 같은 답”이 되지 않는다.
| 기호 | 뜻 |
|---|---|
| 입력 이미지의 픽셀 | |
| 3×3 필터의 가중치 9개 — 모든 에서 같다 | |
| 특징 맵의 칸 | |
| 수용장 | 출력 한 칸이 영향을 받는 입력 영역의 폭. 3×3 을 층 쌓으면 |
2. 직접 재 보기
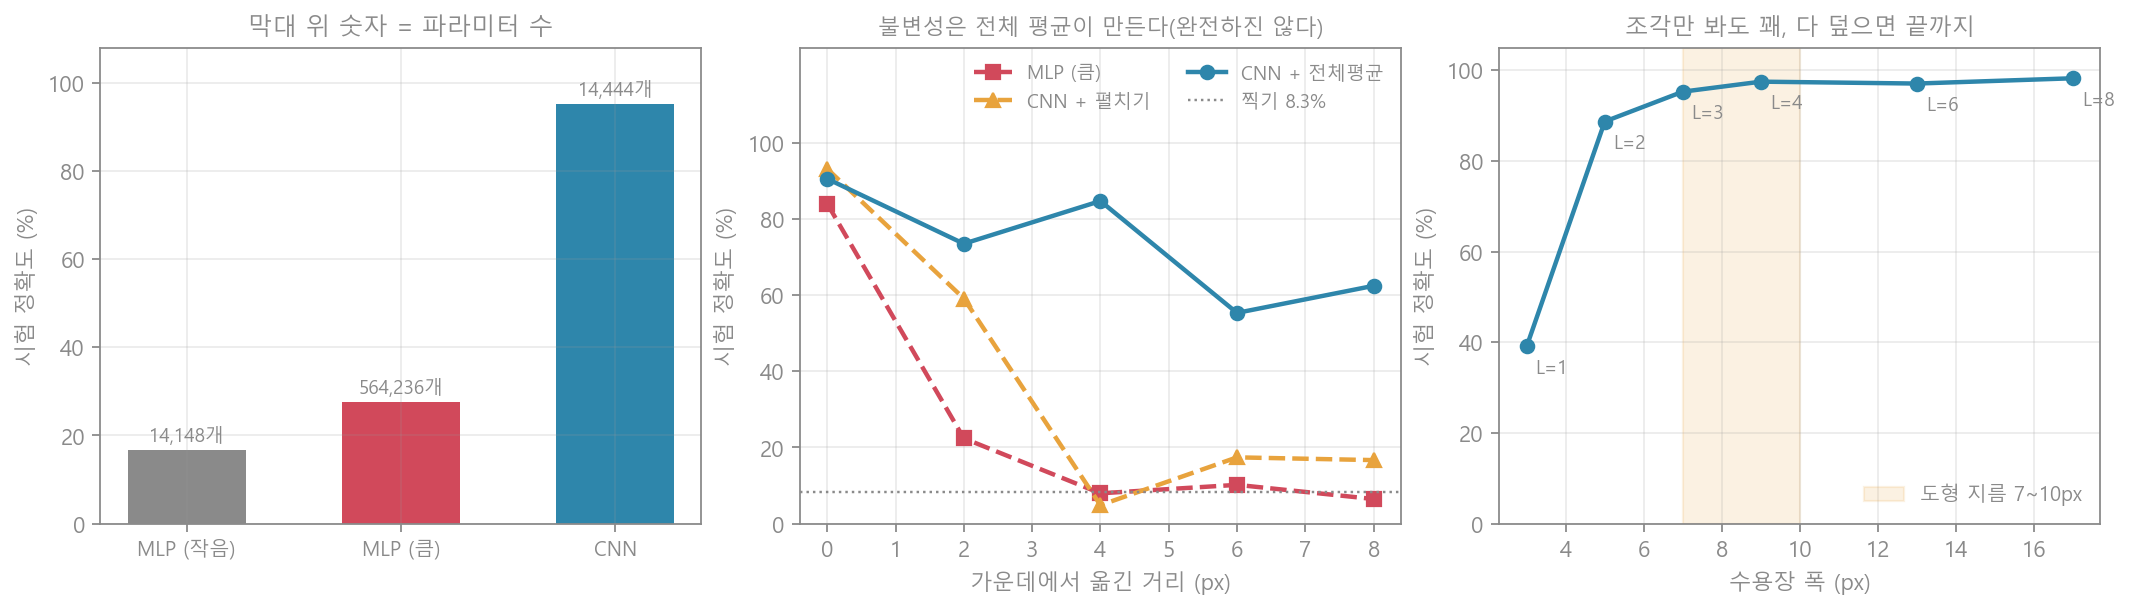
[A] 같은 예산이면
도형 12종을 24×24 캔버스 어디에나 놓았다(학습 3,600장, 시험 2,400장).
| 모델 | 파라미터 | 학습 정확도 | 시험 정확도 |
|---|---|---|---|
| MLP (작음) | 14,148 | 87.1% | 16.8% |
| MLP (큼) | 564,236 | 100.0% | 27.5% |
| CNN (합성곱 3층 + 전체 평균) | 14,444 | 98.0% | 95.1% |
큰 MLP는 학습 데이터를 100% 외웠지만 시험에서 27.5%다. 3,600장으로는 12종 × 수백 가지 위치를 다 보여 줄 수 없다. CNN은 파라미터가 40분의 1인데 95.1%다. 한 위치에서 배운 모서리·곡선 감지기를 모든 위치에 그대로 쓰기 때문이다.
[B] 가운데서만 배우고 옆으로 옮기면
이번에는 학습 데이터를 가운데(±1px)에만 두고, 시험 때 도형을 옆으로 픽셀 옮겼다. 합성곱 부분은 같고 끝만 다른 CNN 두 개를 비교한다 — 특징 맵을 펼쳐서(flatten) 붙이는 것과 전체 평균을 내는 것.
| 옮긴 거리 | MLP (큼) | CNN + 펼치기 | CNN + 전체 평균 |
|---|---|---|---|
| 0 px | 84.0% | 93.2% | 90.6% |
| 2 px | 22.4% | 59.1% | 73.5% |
| 4 px | 7.9% | 4.8% | 84.7% |
| 6 px | 10.2% | 17.4% | 55.3% |
| 8 px | 6.4% | 16.7% | 62.4% |
(찍기는 8.3%)
MLP는 2픽셀만 옮겨도 무너진다. 그런데 펼친 CNN도 4픽셀에서 4.8%로 찍기보다 낮다. 합성곱이 만든 특징 맵은 도형을 따라 옮겨졌지만(등변), 그 뒤 완전연결층이 “가운데 칸에 반응이 있으면 원”이라고 위치를 외웠기 때문이다. 위치를 지운 것은 전체 평균이었다.
그리고 전체 평균도 완전하지 않았다. 2px(73.5%)보다 4px(84.7%)가, 6px(55.3%)보다 8px(62.4%)가 낫다. 4의 배수로 옮길 때가 더 좋다. 이 CNN은 2×2 풀링을 두 번 해서 전체 보폭이 4다. 4의 배수로 옮기면 풀링 격자와 딱 맞아 같은 값이 나오고, 그 사이로 옮기면 격자에 걸치는 방식이 달라져 특징이 바뀐다. 알려진 현상이고(Zhang, 2019), 풀링 전에 흐리게 해서(anti-aliasing) 줄인다. 가운데서 멀어질수록 떨어지는 것은 캔버스 테두리의 0 채움(padding) 근처를 학습 때 한 번도 못 봤기 때문이다.
[C] 수용장 — 필터가 한 번에 보는 넓이
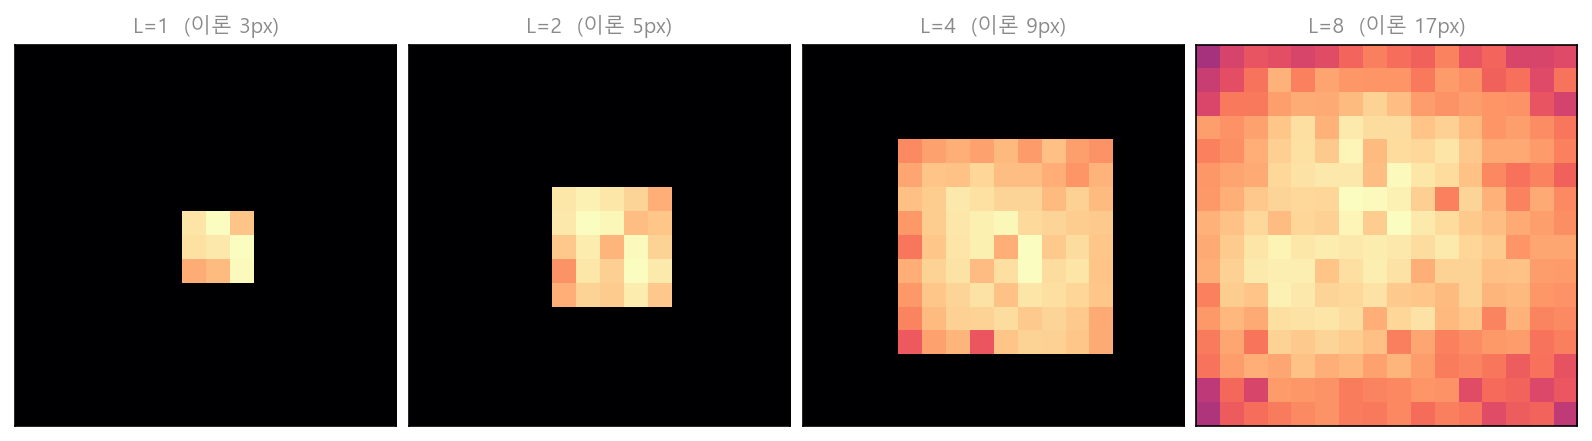
풀링 없이 3×3 합성곱만 층 쌓고 전체 평균을 냈다(16×16, 도형 지름 7~10px). 수용장은 가운데 출력 한 칸을 입력으로 미분해서, 기울기가 0이 아닌 영역의 폭을 실제로 재었다.
| 층 수 | 이론 | 실측 폭 | 시험 정확도 |
|---|---|---|---|
| 1 | 3 px | 3 px | 39.1% |
| 2 | 5 px | 5 px | 88.7% |
| 3 | 7 px | 7 px | 95.3% |
| 4 | 9 px | 9 px | 97.5% |
| 6 | 13 px | 13 px | 97.1% |
| 8 | 17 px | 16 px | 98.3% |
실측 폭은 이론과 정확히 같다. 의 16px은 캔버스가 16px이라 거기서 잘린 것이다.
예상과 달랐던 것은 다. 수용장 5px은 도형(710px)의 반쯤밖에 못 보는데 88.7% 가 나왔다. 모서리 한 조각만
봐도 원(곡선)인지 사각형(직각)인지 마름모(비스듬한 변)인지가 꽤 갈리기 때문이다. 조각의 통계를 전체 평균으로 모으면
그것만으로 상당히 맞힌다. 도형을 다 덮는 79px부터 97% 근처의 한계에 닿는다.
3. 흔한 오해와 한계
1. “CNN은 평행이동에 불변이다” — 합성곱은 등변이고, 불변은 전체 평균이나 풀링이 만든다. [B]에서 펼친 CNN은 4px 이동에 4.8%로 무너졌다. 그리고 풀링까지 있어도 보폭의 배수가 아닌 이동에는 흔들렸다.
2. “파라미터가 많을수록 낫다” — [A]에서 40배 많은 MLP가 3.5분의 1 정확도였다. 파라미터 수보다 구조에 담긴 가정 (가까운 픽셀끼리 관계가 있다, 어디서든 같은 무늬는 같은 뜻이다)이 작은 데이터에서는 더 크게 작용한다.
3. 그 가정이 틀리는 과제도 있다 — “도형이 왼쪽에 있으면 A, 오른쪽이면 B”처럼 위치 자체가 답인 과제에서 전체 평균은 필요한 정보를 지운다. 불변성은 공짜 이득이 아니라 과제에 대한 가정이다.
4. ViT와의 관계 — 비전 트랜스포머는 이 가정을 거의 넣지 않고 데이터로 배운다. 그래서 데이터가 적을 때는 CNN이, 아주 많을 때는 ViT가 이기는 경향이 있다(비전 트랜스포머 편).
4. 한 문단 요약
합성곱은 작은 필터 하나를 이미지 전체에 미끄러뜨려 같은 가중치로 계산한다. 그래서 도형이 24×24 어디에나 놓이는 과제에서 파라미터 1만 4천 개 CNN이 95.1%, 56만 개 MLP가 27.5%였다. 다만 합성곱 자체는 등변(옮기면 반응도 옮겨짐)일 뿐이다. 가운데서만 배우고 4px 옮겨 시험하자 특징 맵을 펼친 CNN은 4.8%로 무너졌고, 위치를 지우는 전체 평균을 쓴 CNN만 84.7%로 버텼다. 그마저 풀링 보폭 4 때문에 4의 배수로 옮길 때만 잘 버텼다. 수용장은 이론대로 로 넓어졌고, 5px만 돼도 88.7%였다. 모서리 조각에도 도형 종류가 드러나기 때문이다.