인지야공/딥러닝 기초 정리/53번째 글
확산 모델 — 잡음에서 되돌아오는 법
실행:
python NN_28_diffusion.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 필요한 수학: 정규분포와 재매개변수화 노트.
비전 트랜스포머와 CLIP 편에서 이미지를 읽는 법을 봤다. 이번엔 만드는 쪽이다. 생성은 어렵다 — 그럴듯한 이미지의 분포는 엄청나게 좁고 복잡해서, 한 번에 맞히기가 어렵다.
확산 모델의 발상은 문제를 뒤집는 것이다. 이미지를 잡음으로 망가뜨리는 일은 누구나 할 수 있고 정확히 안다. 그러니 그 길을 아주 잘게 쪼개 놓고, 각 한 걸음을 되돌리는 법만 배우자. 한 걸음은 거의 안 망가진 것을 조금 되돌리는 일이니 쉽다. 그 쉬운 걸음 수백 개를 이어 붙이면 잡음에서 이미지가 나온다.
1. 전방 과정 — 망가뜨리는 길은 공짜다
데이터에 잡음을 조금씩 더한다. 단계의 한 걸음은 이렇다.
원래 신호를 조금 줄이고() 그만큼 잡음을 채운다. 그런데 정규분포끼리 더하면 다시 정규분포이므로 (노트), 이 걸음들을 한 번에 건너뛸 수 있다.
| 기호 | 뜻 |
|---|---|
| 원본 데이터 | |
| 단계까지 망가진 데이터 | |
| 그 단계에서 신호를 남기는 비율 | |
| 누적곱. 까지 남은 신호의 비율 |
이 한 줄이 확산 모델을 실용적으로 만든다 — 학습할 때 를 무작위로 뽑아 그 시점의 데이터를 즉시 만들 수 있고, 400단계를 순서대로 밟을 필요가 없다.
직접 재 보기 A
한 걸음씩 400번 밟은 것과, 닫힌 형식으로 단번에 만든 것을 비교했다(표본 20,000개).
| 1 | 50 | 100 | 200 | 400 | |
|---|---|---|---|---|---|
| 한 걸음씩 (표준편차) | 2.8380 | 2.7561 | 2.5353 | 1.8762 | 1.0578 |
| 닫힌 형식 (표준편차) | 2.8380 | 2.7585 | 2.5362 | 1.8842 | 1.0654 |
| (남은 신호) | 1.000 | 0.967 | 0.879 | 0.602 | 0.132 |
| 원본과의 상관 | +1.000 | +0.996 | +0.982 | +0.904 | +0.360 |
두 길이 같은 분포를 만든다(차이 0.008 이하). 그리고 가 갈수록 원본의 기여가 13%까지 줄어든다. 다만 상관이 0.36으로 아직 흔적이 남아 있다 — 여기서는 까지만 돌렸기 때문이고, 실제 DDPM은 으로 더 밀어 완전한 잡음에 가깝게 만든다.
2. 역방향 — 잡음을 맞히는 문제로 바꾼다
이제 거꾸로 걸어야 한다. 에서 로 가려면 어떤 잡음이 섞였는지 알면 된다. 그래서 모델이 배우는 것은 이미지가 아니라 잡음이다. 손실은 놀랄 만큼 단순하다 — 그냥 제곱 오차다.
“이 흐릿한 그림에 섞인 잡음이 뭐였게?”를 온갖 에 대해 맞히다 보면, 모델은 어느 방향이 데이터다운가를 알게 된다. 그리고 잡음을 맞히면 원본 추정이 따라 나온다(). 이 값이 사실 확률밀도의 기울기(스코어)와 같은 것이라, 확산 모델을 “스코어 기반 모델”이라고도 부른다.
직접 재 보기 B
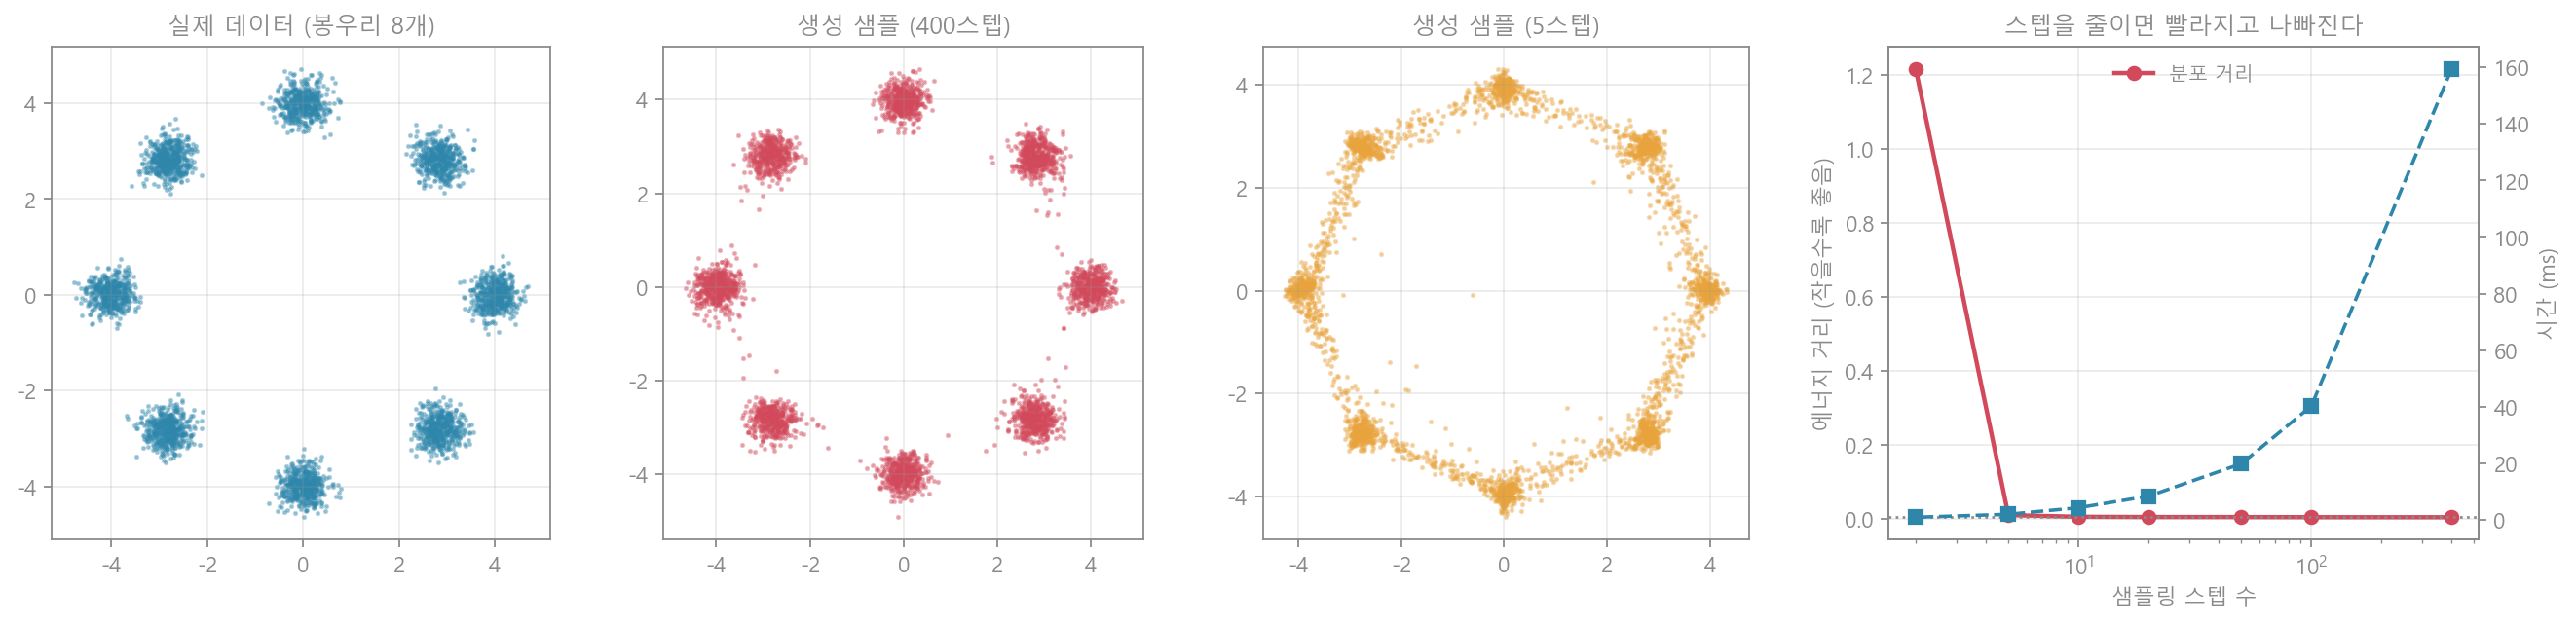
원 위에 봉우리 8개가 있는 2차원 분포를 학습시키고(11초), 잡음에서 4,000개를 생성했다.
| 가장 적은 봉우리 | 가장 많은 봉우리 | 중심까지 평균거리 | |
|---|---|---|---|
| 실제 데이터 | 12.0% | 12.9% | 0.309 |
| 생성 샘플 | 11.6% | 13.4% | 0.302 |
8개 봉우리를 거의 고르게 덮는다. 분포 거리(에너지 거리)는 0.0041이고, 실제 데이터를 두 번 뽑아 비교한 기준선이 0.0022이니 거의 구분되지 않는 수준이다.
여기서 눈여겨볼 것은 모드 붕괴가 없다는 점이다. GAN은 판별자를 속이기만 하면 되므로 쉬운 봉우리 한둘만 찍어내는 실패가 잦았다. 확산 모델의 손실은 모든 데이터의 잡음을 다 맞혀야 줄어들기 때문에, 분포 전체를 덮는 쪽으로 밀린다. 오늘날 이미지 생성이 GAN에서 확산으로 넘어간 큰 이유다.
3. 대가는 속도 — 스텝을 줄이는 싸움
단점은 분명하다. 생성 한 번에 모델을 수백 번 돌린다. 문장 한 토큰에 한 번 돌리는 KV 캐시 편의 생성과는 차원이 다른 비용이다. 그래서 스텝을 줄이는 법이 확산 연구의 큰 줄기가 됐다(DDIM은 잡음을 다시 넣지 않고 결정적으로 건너뛴다).
직접 재 보기 C
같은 모델로 샘플링 스텝만 바꿔 가며 쟀다(기준선: 실제 vs 실제 = 0.0029).
| 스텝 | 400 | 100 | 50 | 20 | 10 | 5 | 2 |
|---|---|---|---|---|---|---|---|
| 시간 | 159.5 ms | 40.3 ms | 19.9 ms | 8.4 ms | 4.3 ms | 2.0 ms | 0.9 ms |
| 분포 거리 | 0.0034 | 0.0035 | 0.0039 | 0.0040 | 0.0046 | 0.0092 | 1.2170 |
| 중심까지 거리 | 0.303 | 0.302 | 0.301 | 0.298 | 0.298 | 0.358 | 2.582 |
400스텝에서 20스텝으로 줄이면 19배 빨라지는데 분포 거리는 0.0034에서 0.0040으로 거의 그대로다. 즉 대부분의 스텝은 낭비였다. 그러다 5스텝에서 품질이 두 배 나빠지고, 2스텝에서 통째로 무너진다(거리 1.217, 중심에서 2.58 떨어진 곳에 흩뿌려진다).
완만한 내리막이 아니라 절벽이라는 점이 중요하다. 한 걸음이 감당할 수 있는 변화량에는 한계가 있고, 그 선을 넘는 순간 되돌리기가 실패한다. “몇 스텝까지 줄일 수 있나”가 실무의 질문이 되는 이유이고, 증류(distillation)로 1~4스텝 생성을 만드는 연구가 활발한 이유다.
4. 흔한 오해와 한계
- “모델이 이미지를 만든다” — 모델이 하는 일은 잡음 맞히기뿐이다. 이미지는 그 예측을 수백 번 적용하는 샘플링 절차가 만든다. 그래서 같은 모델에 다른 샘플러를 끼우면 속도·품질이 달라진다.
- “스텝이 많을수록 좋다” — 3절처럼 어느 선을 넘으면 거의 늘지 않는다(400 vs 20이 0.0034 vs 0.0040).
- “확산은 느려서 못 쓴다” — 잠재 공간에서 돌리고(Stable Diffusion) 스텝을 줄이면 실용 속도가 된다.
- “텍스트 생성에도 쓰면 된다” — 그대로는 어렵다. 확산은 연속값에 잡음을 더하는 구조인데 토큰은 이산이라, 이산 확산은 별도의 설계가 필요하다.
- 이 글의 실험 — 2차원 8봉우리라는 장난감이다. 19배·1.217 같은 수는 이 설정의 값이고, 요점은 망가뜨리기의 역과정을 잘게 쪼개 배운다, 그리고 스텝 수는 절벽을 갖는다는 구조다.
5. 한 문단 요약
확산 모델은 생성을 역방향 잡음 제거로 바꾼다. 전방(망가뜨리기)은 공짜로 알고, 정규분포의 덧셈 덕에 아무 시점의
잡음 낀 데이터를 한 번에 만들 수 있어 학습이 간단한 제곱 오차가 된다 — “섞인 잡음을 맞혀라”. 그렇게 배운 모델로
잡음에서 되돌아오니 봉우리 8개를 모두 고르게(11.613.4%, 실제 12.012.9%) 덮었다. 모든 데이터를 다 맞혀야
손실이 줄기 때문에 모드 붕괴가 없다는 것이 GAN 대비 강점이다. 대가는 속도인데, 스텝을 400에서 20으로 줄이면
19배 빨라지면서 품질은 거의 그대로이고, 대신 2스텝에서는 절벽처럼 무너진다(분포 거리 0.004 → 1.217).
참고
- Ho 외 — Denoising Diffusion Probabilistic Models (2020) — DDPM
- Song 외 — Denoising Diffusion Implicit Models (2020) — DDIM, 적은 스텝
- Rombach 외 — High-Resolution Image Synthesis with Latent Diffusion Models (2021) — Stable Diffusion
- 연재: 비전 트랜스포머와 CLIP · KV 캐시 · 수학: 정규분포와 재매개변수화