인지야공/딥러닝 기초 정리/55번째 글
강화학습 기초 — 가치가 퍼져 나간다
실행:
python NN_42_rl_basics.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
RLHF와 DPO 편에서 선호로 배우는 이야기를 했는데, 정작 그 바탕인 강화학습 자체는 건너뛰었다. 여기서 메운다. 핵심 개념은 딱 하나다 — 가치.
환경은 21×21 격자다. 벽이 있고, 시작점에서 4칸 거리에 +1, 벽을 돌아 한참 가야 하는 곳에 +10이 있다.
1. 벨만 방정식 — 그림으로 먼저
“이 칸이 얼마나 좋은가”를 어떻게 정할까. 답은 이웃에게 묻는 것이다. 좋은 칸 옆은 좋은 칸이다.
이 한 줄이 벨만 방정식이다.
| 기호 | 뜻 |
|---|---|
| 지금 상태(어느 칸에 있나) | |
| 행동(상·하·좌·우) | |
| 그 행동을 했을 때 가는 칸 | |
| 그때 받는 보상 | |
| 감가율. 한 칸 멀어질 때마다 곱해지는 할인(0~1) | |
| 그 칸의 가치 — 여기서 잘하면 앞으로 받을 총합 |
읽는 법은 “지금 받을 것 + 다음 칸의 좋음을 조금 깎은 값, 그중 가장 좋은 행동”이다. 정의 안에 자기 자신이 들어 있어서, 반복해서 갱신하면 답에 수렴한다.
2. 직접 재 보기 A — 한 번에 한 칸씩
이 갱신을 반복하면서 값이 0이 아닌 칸이 몇 개인지 셌다(갈 수 있는 칸 331개, ).
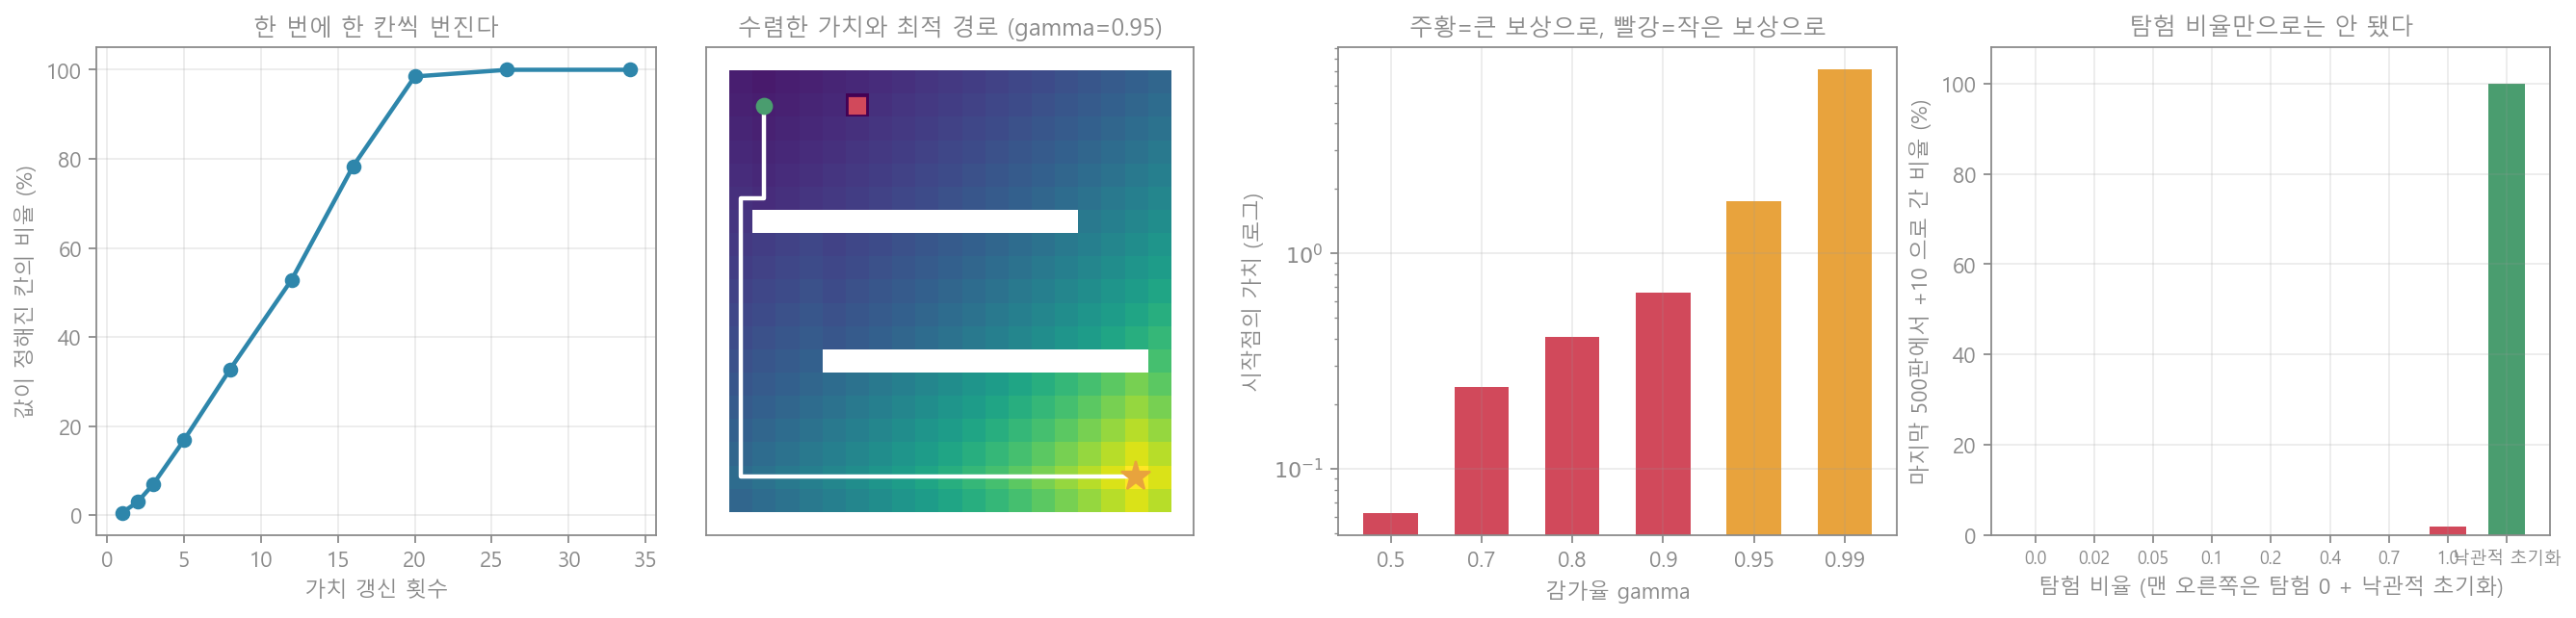
| 갱신 횟수 | 1 | 2 | 3 | 5 | 8 | 12 | 16 | 20 | 26 |
|---|---|---|---|---|---|---|---|---|---|
| 값이 정해진 칸 | 2 | 10 | 18 | 46 | 109 | 176 | 261 | 316 | 331 |
전부 채우는 데 37번이 걸렸다. 이 격자에서 가장 먼 칸까지의 거리와 거의 같다.
당연한 이야기인데 중요하다 — 정보는 이웃을 통해서만 전해진다. 보상이 멀리 있으면 그 소식이 시작점까지 오는 데 그만큼 걸리고, 이것이 강화학습이 지도학습보다 훨씬 느린 근본 이유다 (지도학습은 정답이 모든 예제에 직접 붙어 있다).
번져 나가는 모습을 그대로 찍었다.
오른쪽 아래의 큰 보상(★)에서 밝기가 물결처럼 퍼진다. 벽을 만나면 돌아가고, 틈을 통해 반대편으로 새어 나간다. 최적 경로를 따로 계산한 적이 없는데도, 값이 채워지고 나면 “가장 밝은 이웃으로 가기”만 해도 그게 최적 경로다.
3. 직접 재 보기 B — 감가율이 목표를 바꾼다
는 “미래를 얼마나 쳐 주는가”다. 작으면 근시안이 된다. 이 환경에는 가까운 +1(4칸)과 먼 +10(34칸)이 있으니, 에 따라 어디로 갈지가 갈린다.
| 0.50 | 0.70 | 0.80 | 0.90 | 0.95 | 0.99 | |
|---|---|---|---|---|---|---|
| 시작점의 가치 | 0.0625 | 0.2401 | 0.4096 | 0.6561 | 1.7482 | 7.1055 |
| 따라간 길 | 4칸 | 4칸 | 4칸 | 4칸 | 34칸 | 34칸 |
| 도착한 곳 | +1 | +1 | +1 | +1 | +10 | +10 |
0.90과 0.95 사이에서 목표가 통째로 바뀐다. 환경도, 보상도, 알고리즘도 그대로인데 숫자 하나가 “가까운 것에 만족”과 “멀리 보고 감”을 가른다.
산수는 간단하다. 두 선택지의 가치는 과 이고, 뒤집히는 지점은 , 곧 이다. 실제로 0.90(작은 쪽)과 0.95(큰 쪽) 사이에서 갈렸다.
여기서 가 실무에서 왜 민감한 손잡이인지가 보인다. 그것은 단순한 하이퍼파라미터가 아니라 “이 에이전트가 얼마나 멀리 보는가”를 정하는 값이고, 잘못 잡으면 가까운 보상만 챙기는 행동이 나온다. 명세 게이밍 편에서 본 문제와 같은 뿌리다.
4. 직접 재 보기 C — 탐험 비율만으로는 안 됐다
지금까지는 환경을 다 안다고 가정했다. 실제로는 해 봐야 안다. Q-러닝으로 직접 돌아다니게 하고, 무작위로 행동할 확률 을 바꿔 가며 4,000판을 돌렸다.
| 탐험 비율 | 0.0 | 0.05 | 0.2 | 0.4 | 0.7 | 1.0 |
|---|---|---|---|---|---|---|
| +10을 처음 찾은 판 | 못 찾음 | 못 찾음 | 못 찾음 | 못 찾음 | 못 찾음 | 107번째 |
| 마지막 500판에서 +10으로 간 비율 | 0.0% | 0.0% | 0.0% | 0.0% | 0.0% | 1.8% |
전부 실패했다. 예상과 다른 결과라 이유를 봤더니 분명했다. +1이 4칸 거리라, 무작위로 걷든 그리디로 걷든 거기 먼저 도착하면서 판이 끝난다. 34칸 떨어진 +10까지 헤매 볼 기회 자체가 없다. (완전 무작위)에서조차 4,000판 중 57판만 도달했다.
그럼 무엇이 이 덫을 벗어나게 할까. 두 가지를 더 재 봤다.
| 조건 | +10을 처음 찾은 판 | 마지막 500판에서 +10으로 간 비율 |
|---|---|---|
| +1을 아예 없앤 판 () | 81번째 | 100.0% |
| 낙관적 초기화 () | 13번째 | 100.0% |
| 낙관적 초기화 () | 11번째 | 100.0% |
마지막 줄이 놀랍다. 무작위 행동을 한 번도 하지 않았는데(탐험 비율 0) 11번째 판에 큰 보상을 찾았다.
원리는 이렇다. 모든 행동의 가치를 처음에 10으로 후하게 매겨 두면, 가 본 곳은 실제 값으로 내려가고 안 가 본 곳은 10으로 남는다. 그러면 그리디하게만 골라도 자연히 안 가 본 쪽으로 간다. “탐험”을 무작위성으로 넣는 대신 가치 안에 넣어 둔 셈이다.
이것이 탐험 연구의 출발점이다 — -그리디는 가장 단순한 탐험이지 좋은 탐험이 아니고, 보상이 드문 환경에서는 안 가 본 곳을 좋게 봐 주는 설계가 필요하다(낙관적 초기화, 방문 횟수 보너스, 호기심 보상 등).
5. 흔한 오해와 한계
- “강화학습은 보상을 주면 알아서 배운다” — 보상을 만나야 배운다. 4절에서 만나지 못했다.
- “탐험 비율을 키우면 탐험이 된다” — 아니었다(4절). 무작위 걸음은 멀리 못 간다.
- “는 대충 0.99” — 목표 자체를 바꾼다(3절). 0.90과 0.95 사이에서 갈렸다.
- “가치만 알면 끝” — 여기서는 상태가 331개뿐이라 표로 다 적을 수 있었다. 실제 문제는 상태가 너무 많아 가치를 신경망으로 근사해야 하고, 그때 이 글의 깔끔한 수렴 보장이 사라진다.
- 이 글의 실험 — 격자 세계라는 장난감이고 환경이 결정적이다. 37번·11번째 같은 수는 이 설정의 값이고, 요점은 가치는 이웃을 통해 번진다, 가 시야를 정한다, 탐험은 무작위성이 아니라 설계다라는 구조다.
6. 한 문단 요약
강화학습의 중심 개념은 가치이고, 그 정의인 벨만 방정식은 “지금 받을 것 + 다음 칸의 좋음을 만큼 깎은 값”이다. 자기 자신을 참조하므로 반복 갱신으로 푸는데, 실제로 재 보면 한 번 갱신할 때마다 딱 한 칸씩 번져 331칸을 채우는 데 37번이 걸렸다 — 정보가 이웃을 통해서만 전해지기 때문이고, 강화학습이 느린 근본 이유다. 는 시야를 정한다. 0.90에서는 4칸 거리의 +1로 갔고 0.95에서는 34칸 거리의 +10으로 갔다(뒤집히는 지점은 ). 마지막으로, 환경을 모르는 채 배우게 하자 탐험 비율을 0부터 1까지 전부 돌려도 큰 보상을 쓰지 못했다. 가까운 +1이 판을 먼저 끝내 버리기 때문이다. 그런데 탐험 비율을 0으로 두고 가치를 후하게 초기화하기만 하자 11번째 판에 찾아냈다. 탐험은 주사위를 굴리는 일이 아니라 안 가 본 곳을 어떻게 값 매길 것인가의 문제다.