인지야공/딥러닝 기초 정리/39번째 글
토크나이저의 불평등 — 한국어는 왜 비싼가
실행:
python NN_47_tokenizer_fairness.py(tiktoken 0.11.0, tokenizers 0.22.2) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 함께 보면 좋은 글: 토크나이저와 임베딩 편
토크나이저와 임베딩 편에서 텍스트가 토큰이 되는 과정을 봤다. 그런데 토큰은 단순한 내부 표현이 아니다 — 요금이 토큰으로 매겨지고, 문맥 창도 토큰으로 세고, 생성 속도도 토큰 수에 달려 있다. 그러니 “같은 내용이 몇 토큰인가”는 곧 값이다.
그리고 그 값은 언어마다 다르다.
1. 무엇이 벌어지는가 — 그림으로 먼저
BPE는 말뭉치에서 자주 붙어 나오는 조각부터 차례로 어휘에 넣는다. 어휘 자리는 유한하므로, 말뭉치에 많이 들어간 언어가 자리를 먼저 가져간다.
2. 직접 재 보기 A — 같은 뜻, 다른 값
뜻이 같은 문장 다섯 개를 5개 언어로 쓰고, 실제 GPT 토크나이저에 넣었다.
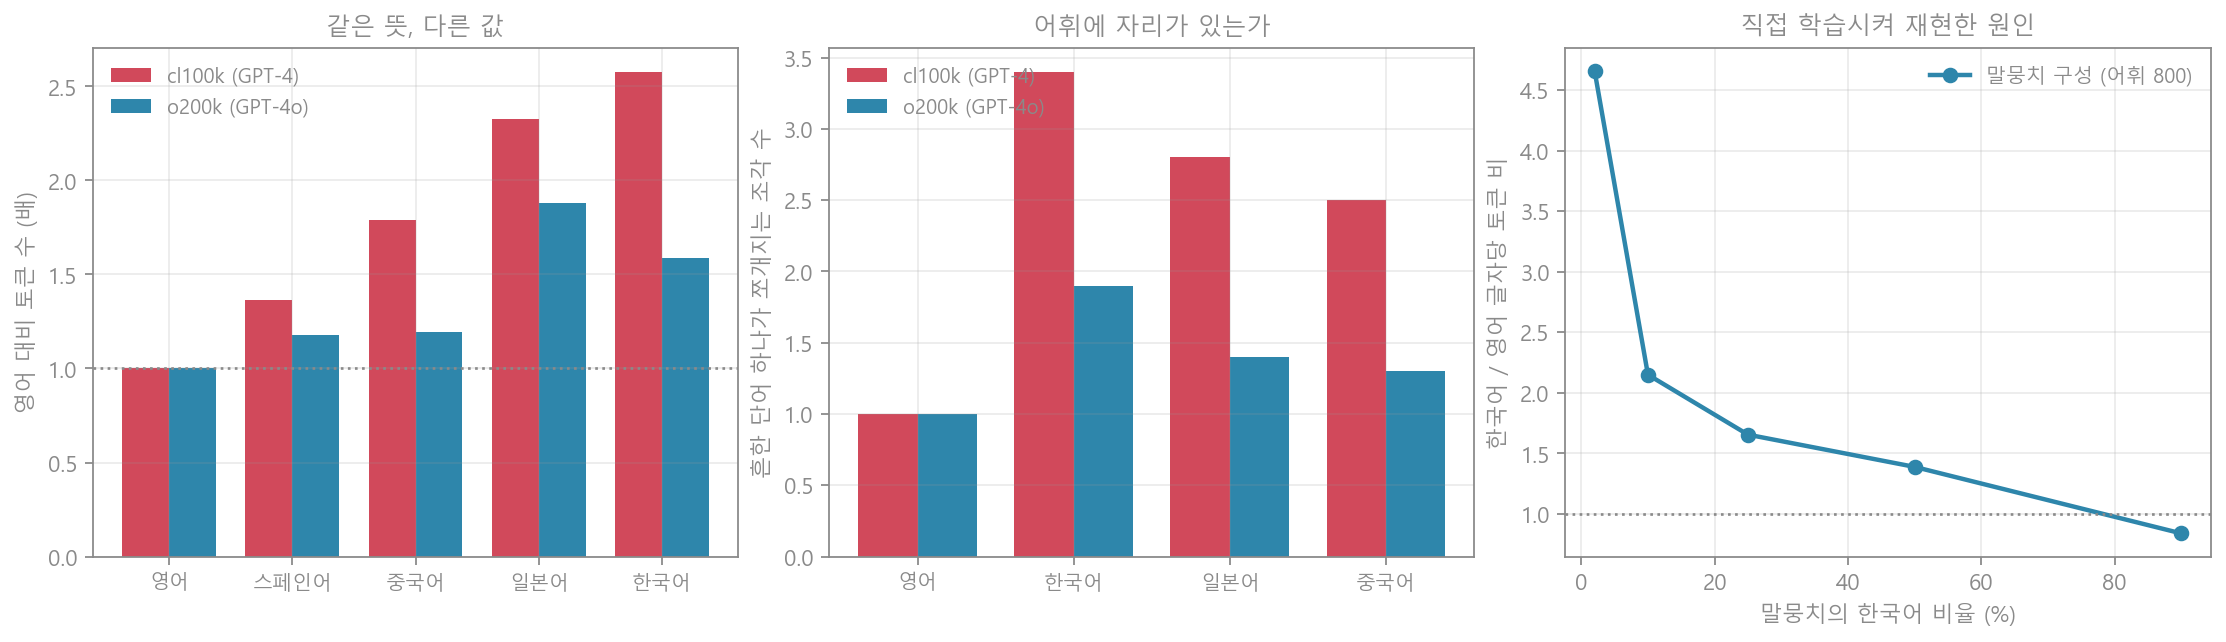
cl100k_base (GPT-4, 어휘 100,277개)
| 언어 | 영어 | 스페인어 | 중국어 | 일본어 | 한국어 |
|---|---|---|---|---|---|
| 토큰 수 | 52 | 71 | 93 | 121 | 134 |
| 글자 수 | 275 | 295 | 86 | 114 | 125 |
| 영어 대비 | 1.00배 | 1.37배 | 1.79배 | 2.33배 | 2.58배 |
o200k_base (GPT-4o, 어휘 200,019개)
| 언어 | 영어 | 스페인어 | 중국어 | 일본어 | 한국어 |
|---|---|---|---|---|---|
| 토큰 수 | 51 | 60 | 61 | 96 | 81 |
| 영어 대비 | 1.00배 | 1.18배 | 1.20배 | 1.88배 | 1.59배 |
같은 내용인데 한국어가 영어의 2.58배다. 요금이 토큰당이라면 2.58배를 내는 것이고, 문맥 창이 128K라면 실질적으로 50K짜리를 쓰는 셈이다.
다행히 세대가 바뀌며 나아졌다 — 어휘를 두 배로 키운 o200k에서 2.58배가 1.59배로 줄었다. 그래도 여전히 영어보다 1.6배 비싸다.
문장 하나가 실제로 어떻게 쪼개지는지 언어별로 찍어 봤다.
영어는 단어 단위로 시원하게 잘리는데, 한국어는 조각이 잘고 많다.
3. 직접 재 보기 B — 어휘에 자리가 있는가
왜 그런지는 단어 하나를 넣어 보면 바로 보인다. 각 언어의 흔한 단어 열 개를 넣고 몇 조각으로 쪼개지는지 셌다.
| 영어 | 중국어 | 일본어 | 한국어 | |
|---|---|---|---|---|
| cl100k — 평균 조각 수 | 1.00 | 2.50 | 2.80 | 3.40 |
| cl100k — 통째로 있는 단어 | 10/10 | 1/10 | 2/10 | 0/10 |
| o200k — 평균 조각 수 | 1.00 | 1.30 | 1.40 | 1.90 |
| o200k — 통째로 있는 단어 | 10/10 | 7/10 | 7/10 | 1/10 |
cl100k에서 “모델”, “문장”, “언어” 같은 기본 단어가 통째로 들어 있는 것은 0개였다. 평균 3.4조각으로 쪼개진다. 한글은 한 글자가 UTF-8로 3바이트라, 어휘에 자리를 못 얻으면 글자 하나가 토큰 여러 개가 되기도 한다.
o200k에서 중국어·일본어는 7/10이 통째로 들어갔는데 한국어는 1/10에 그쳤다. 어휘를 키울 때 어느 언어에 자리를 얼마나 줄지도 선택이라는 뜻이다.
4. 직접 재 보기 C — 원인 확인
“한국어는 원래 그런 언어 아닌가?” 아니다. 말뭉치 구성만 바꿔 BPE를 직접 학습시켜 확인했다. 알고리즘·어휘 크기(800)·문장 구조는 전부 같고, 말뭉치에 한국어가 몇 %인지만 바꿨다.
| 말뭉치의 한국어 비율 | 2% | 10% | 25% | 50% | 90% |
|---|---|---|---|---|---|
| 영어 글자당 토큰 | 0.307 | 0.321 | 0.332 | 0.350 | 0.440 |
| 한국어 글자당 토큰 | 1.432 | 0.691 | 0.549 | 0.485 | 0.369 |
| 한국어/영어 비 | 4.66배 | 2.15배 | 1.65배 | 1.39배 | 0.84배 |
한국어가 2%면 4.66배 비싸고, 90%면 오히려 영어가 비싸진다(0.84배). 언어의 성질이 아니라 어휘를 무엇으로 만들었느냐의 결과다.
그럼 어휘를 키우면 해결될까. 한국어 비율을 10%로 고정하고 어휘 크기만 키워 봤다.
| 어휘 크기 | 400 | 800 | 1,600 | 3,200 |
|---|---|---|---|---|
| 한국어/영어 비 | 2.02배 | 2.15배 | 2.47배 | 1.26배 |
예상과 달리 처음에는 격차가 벌어진다(2.02 → 2.47). 새로 생긴 자리를 다수 언어가 먼저 가져가기 때문이다. 충분히 커진 뒤(3,200)에야 소수 언어에도 자리가 돌아와 1.26배로 줄었다.
2절에서 cl100k(10만)보다 o200k(20만)가 한국어에 후했던 것이 같은 이야기다 — 어휘를 키우는 것은 도움이 되지만, 얼마나 키우느냐와 무엇에 배분하느냐가 함께 정해져야 한다.
5. 흔한 오해와 한계
- “한국어가 정보 밀도가 높아 어쩔 수 없다” — 4절이 반례다. 말뭉치 비율만 바꿔도 뒤집힌다.
- “글자 수가 적으니 오히려 유리하다” — 중국어는 글자 86자로 가장 짧은데 토큰은 93개였다(cl100k). 글자 수와 토큰 수는 다른 이야기다.
- “어휘를 키우면 다 해결된다” — 중간 구간에서는 격차가 오히려 벌어졌다(4절).
- “요금만 더 내면 된다” — 문맥 창도 같은 비율로 줄고, 생성 속도도 토큰 수에 비례한다 (추론 서빙 편). 비용이 세 군데에서 동시에 붙는다.
- 이 글의 실험 — 문장 다섯 개 묶음이고, 4절은 인공 말뭉치다. 2.58배·4.66배 같은 수는 이 설정의 값이고, 요점은 토큰이 값이다, 어휘 자리는 유한하다, 그 배분이 언어별 비용을 정한다는 구조다.
6. 한 문단 요약
토큰은 내부 표현이 아니라 값이다 — 요금도, 문맥 창도, 속도도 토큰으로 센다. 그런데 같은 뜻의 문장 다섯 개가 GPT-4 토크나이저에서 영어 52토큰, 한국어 134토큰이었다(2.58배). 이유는 어휘에 있다. 흔한 한국어 단어 열 개 중 통째로 어휘에 있는 것이 0개로, 평균 3.40조각으로 쪼개진다. 이것이 언어의 성질이 아니라는 것은 직접 학습시켜 확인했다 — 말뭉치의 한국어 비율만 2%에서 90%로 바꾸자 비가 4.66배에서 0.84배로 뒤집혔다. 어휘를 키우면 나아지지만 단순하지 않다. 처음에는 새 자리를 다수 언어가 먼저 가져가 격차가 오히려 벌어졌고(2.02 → 2.47), 충분히 커진 뒤에야 줄었다. GPT-4에서 GPT-4o로 오며 한국어 비가 2.58에서 1.59배로 준 것이 그 과정이다.