인지야공/딥러닝 기초 정리/25번째 글
분산 학습 — 계산을 나누면 통신이 남는다
실행:
python NN_35_parallelism.py(검증 환경: torch 2.8.0+cu129, RTX 5080) [A]와 [C] 뒷부분은 산수, [B]와 [C] 앞부분은 한 GPU에서의 실측이다.
스케일링 법칙 편이 “키우면 좋아진다”고 했고, 큰 배치 편이 배치를 키우는 산수를 봤다. 그런데 한 장에 안 들어가는 모델은 어떻게 학습시킬까. 답은 나누는 것인데, 나누는 순간 통신이 생긴다. 그 값이 얼마인지를 잰다.
나누는 방식은 크게 셋이다.
- 데이터 병렬(DP): 모델을 통째로 복사해 각자 다른 데이터를 본 뒤, 그라디언트를 합친다.
- 텐서 병렬(TP): 한 층의 행렬을 쪼개 여러 장이 나눠 계산하고, 층마다 결과를 합친다.
- 파이프라인 병렬(PP): 층을 구간별로 나눠 맡고, 구간 경계의 활성값만 넘긴다.
1. 통신량 — 무엇을 얼마나 주고받나
7B급 모델을 가정해 셈했다(32층, 은닉 4096, 시퀀스 2048, 마이크로배치 4, bf16).
직접 재 보기 A
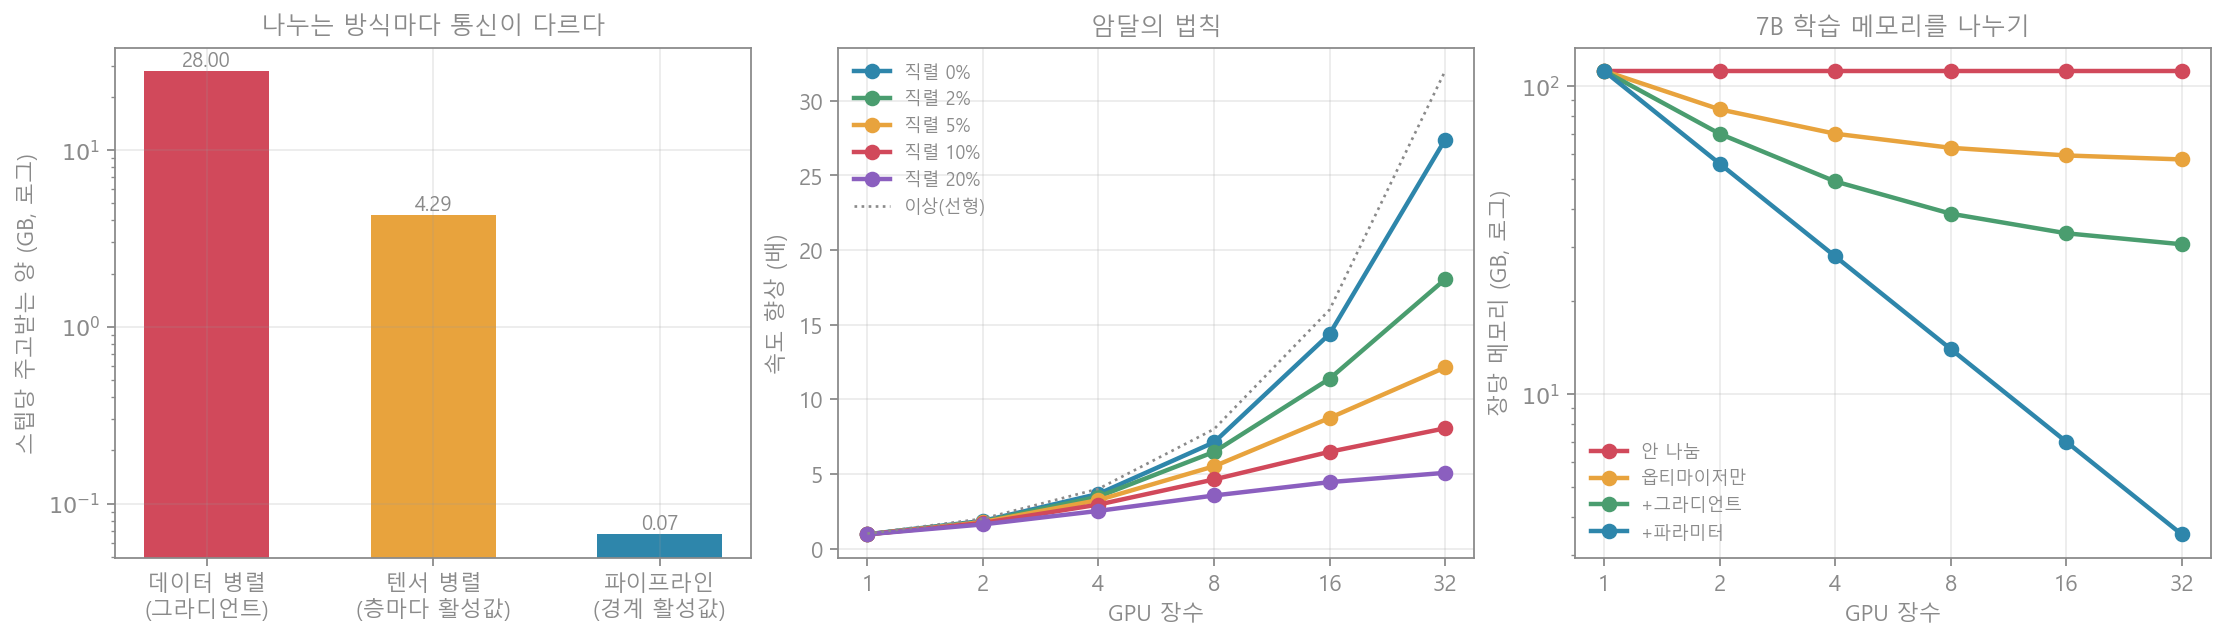
| 방식 | 스텝당 주고받는 양 | 언제 | 무엇을 |
|---|---|---|---|
| 데이터 병렬 | 28.0 GB | 스텝마다 1회 | 그라디언트 전체를 all-reduce |
| 텐서 병렬 | 4.30 GB | 층마다 2회 | 층 출력(활성값)을 all-reduce |
| 파이프라인 | 0.067 GB | 구간 경계마다 | 경계의 활성값만 |
세 자릿수 차이다. 그리고 비례하는 대상이 다르다.
- DP는 파라미터 크기에 비례한다(). 모델이 커지면 통신도 커지지만, 스텝당 한 번이라 계산 시간이 길면 그 안에 숨길 여지가 있다.
- TP는 활성값 크기에 비례하고 층마다 일어난다. 그래서 양은 적어도 횟수가 많아 지연에 민감하다. TP를 보통 한 서버 안의 NVLink로 묶인 GPU끼리만 쓰는 이유다.
- PP는 가장 싸지만, 구간을 순서대로 지나야 해서 거품(bubble)이 생긴다. 마이크로배치를 잘게 쪼개 파이프라인을 채우는 기법이 함께 간다.
실제 대규모 학습은 이 셋을 겹쳐서 쓴다(3D 병렬) — 서버 안은 TP, 서버 사이는 PP, 그 위에 DP. 통신이 싼 곳에 비싼 방식을 놓는 배치 문제다.
2. 암달의 법칙 — 나눌 수 없는 부분이 천장이다
통신·동기화처럼 나눌 수 없는 부분의 비율을 라 하면, 장으로 얻을 수 있는 최대 속도는 이렇다.
| 기호 | 뜻 |
|---|---|
| 나눌 수 없는(직렬) 부분의 비율 | |
| GPU 장수 |
직접 재 보기 B
나눌 수 있는 부분은 실제로 크기로 잘라 재고, 직렬 부분은 그대로 더했다(기준 작업 6.694 ms).
| 직렬 비율 | 2장 | 4장 | 8장 | 16장 | 32장 | 이론 최대 |
|---|---|---|---|---|---|---|
| 0% | 1.84배 | 3.63배 | 7.28배 | 14.44배 | 27.52배 | ∞ |
| 2% | 1.82배 | 3.49배 | 6.49배 | 11.41배 | 18.07배 | 50배 |
| 5% | 1.77배 | 3.26배 | 5.61배 | 8.79배 | 12.14배 | 20배 |
| 10% | 1.72배 | 2.95배 | 4.63배 | 6.49배 | 8.06배 | 10배 |
| 20% | 1.61배 | 2.54배 | 3.56배 | 4.45배 | 5.07배 | 5배 |
직렬 부분이 5%만 있어도 32장에서 12.1배다(이상적이면 32배). 20%면 5.1배에서 사실상 멈춘다. 그리고 장수를 늘릴수록 한 장을 더 붙여 얻는 이득이 빠르게 줄어든다 — 16장에서 32장으로 두 배를 늘려도 5% 곡선은 8.79배에서 12.14배로 1.38배 늘 뿐이다.
여기서 분산 학습의 공학이 왜 통신 최적화에 매달리는지가 나온다. 더 많은 GPU를 붙이는 것보다 를 줄이는 것이 이득이 크기 때문이다. 통신을 계산 뒤에 숨기고(역전파 중 먼저 끝난 층부터 보내기), 여러 층의 그라디언트를 묶어 한 번에 보내고(버킷팅), 정밀도를 낮춰 보내는 기법들이 전부 를 깎는 일이다.
3. 분산은 속도만을 위한 것이 아니다
한 장에 안 들어가서 나누는 경우가 더 많다. 학습에 실제로 무엇이 자리를 차지하는지 쟀다.
직접 재 보기 C
| 무엇 | 메모리 | 파라미터 대비 |
|---|---|---|
| 파라미터 | 201.4 MB | 1.0배 |
| 그라디언트 | 210.5 MB | 1.0배 |
| 옵티마이저 상태(AdamW의 , ) | 402.8 MB | 2.0배 |
| 합계 | 814.7 MB | 4.0배 |
학습에는 파라미터의 4배가 든다. 추론만 할 때와 학습할 때의 메모리가 전혀 다른 이유이고, 최적화 편에서 본 Adam이 값을 두 개 들고 있기 때문이다.
그럼 이것도 나눌 수 있을까. 7B 모델(fp32)을 기준으로, 무엇까지 쪼개느냐에 따라 장당 메모리를 셈했다.
| GPU 장수 | 1 | 4 | 8 | 32 |
|---|---|---|---|---|
| 안 나눔 | 112.0 GB | 112.0 GB | 112.0 GB | 112.0 GB |
| 옵티마이저만 쪼갬 | 112.0 GB | 70.0 GB | 63.0 GB | 57.8 GB |
| + 그라디언트 | 112.0 GB | 49.0 GB | 38.5 GB | 30.6 GB |
| + 파라미터까지 | 112.0 GB | 28.0 GB | 14.0 GB | 3.5 GB |
옵티마이저 상태만 쪼개도 4장에서 112GB가 70GB로 떨어진다(가장 큰 덩어리이기 때문이다). 전부 쪼개면 장당 3.5GB다. 이것이 ZeRO/FSDP가 하는 일이고, 데이터 병렬을 쓰면서도 메모리는 모델 병렬처럼 아끼는 방법이다. 대신 파라미터까지 쪼개면 필요할 때마다 모아 와야 해서 통신이 늘어난다 — 다시 2절의 이야기로 돌아온다.
4. 흔한 오해와 한계
- “GPU를 2배 늘리면 2배 빨라진다” — 직렬 부분이 결정한다(2절). 5%면 32장에서 12.1배다.
- “통신량이 적은 방식이 항상 낫다” — 아니다. TP는 양이 적지만 횟수가 많아 지연에 약하다(1절).
- “메모리는 파라미터 크기만큼” — 학습에는 4배가 든다(3절). 여기에 활성값이 더 얹힌다 (혼합정밀도 편).
- “ZeRO는 공짜” — 쪼갠 만큼 모아 오는 통신이 생긴다. 메모리와 통신의 거래다.
- 이 글의 실험 — GPU 한 장에서 잰 값과 산수를 섞었다. 실제 다중 노드에서는 네트워크 대역폭·지연, 거품, 부하 불균형이 더해져 이보다 나쁘다. 27.5배·3.5GB 같은 수는 이 가정의 값이고, 요점은 통신이 남는다, 직렬이 천장을 정한다, 분산은 메모리를 위한 것이기도 하다는 구조다.
5. 한 문단 요약
모델이 한 장에 안 들어가면 나눠야 하고, 나누면 통신이 남는다. 방식마다 값이 다르다 — 데이터 병렬은 스텝마다 28GB(파라미터에 비례), 텐서 병렬은 4.3GB지만 층마다, 파이프라인은 0.067GB다. 그리고 나눌 수 없는 부분이 전체의 5%만 돼도 32장에서 12.1배, 20%면 5.1배에서 멈춘다(암달의 법칙) — 그래서 GPU를 더 붙이는 것보다 통신을 계산 뒤에 숨기는 공학이 값어치를 한다. 마지막으로 분산은 속도만을 위한 것이 아니다. 학습에는 파라미터의 4.0배(그라디언트 1배 + AdamW 상태 2배)가 드는데, 이것을 쪼개면 7B 기준 장당 112GB가 3.5GB가 된다. 계산을 나누는 문제는 결국 무엇을 나누고 무엇을 주고받을지를 고르는 문제다.