인지야공/딥러닝 기초 정리/42번째 글
긴 꼬리 — 전체 정확도 88%가 숨기고 있는 것
실행:
python NN_49_long_tail.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
현실의 데이터는 고르게 생기지 않았다. 의료 영상에서 정상은 흔하고 희귀 질환은 드물다. 검색 질의는 상위 몇 개가 대부분을 차지하고 나머지는 한 번씩 들어온다. 이런 모양을 긴 꼬리라고 부른다.
이 글은 긴 꼬리에서 세 가지를 잰다. 전체 정확도가 무엇을 숨기는지, 흔히 쓰는 처방이 정말 듣는지, 그리고 지표를 바꾸면 우승자가 바뀌는지.
과제는 16×16 그림에서 도형 12종을 맞히는 것이다. 학습 데이터의 클래스별 개수만 기울였다.
클래스   0     1    2    3    4    5   6   7   8   9  10  11
개수  1000  658  433  285  187  123  81  53  35  23  15  10
가장 흔한 클래스가 가장 드문 클래스의 100배다. 시험 데이터는 클래스마다 250개로 균등하다.
1. 왜 기울어진 데이터가 경계를 미는가 — 그림으로 먼저
분류기는 결국 경계를 어디에 긋느냐의 문제다. 그리고 경계의 위치는 “이 근처에서 틀리면 손실이 얼마나 늘어나는가”로 정해진다. 흔한 클래스는 근처에 표본이 많으니, 경계를 그쪽으로 조금만 밀어도 손실이 크게 늘어난다. 드문 클래스 쪽으로 미는 건 싸다. 그래서 경계는 드문 쪽으로 밀린다.
밀린 경계를 되미는 가장 값싼 방법이 로짓 보정이다. 점수를 매긴 뒤, 클래스가 흔한 만큼 깎아 준다.
| 기호 | 뜻 |
|---|---|
| 클래스 번호 (여기서는 0~11) | |
| 클래스 의 학습 데이터 개수 (1000부터 10까지) | |
| 클래스 의 사전확률. 학습 데이터에서 그 클래스가 차지하는 비율 | |
| 모델이 클래스 에 매긴 로짓 — 소프트맥스에 들어가기 전의 점수 | |
| 최종 예측 |
숫자로 한 번 따라가 보자. 클래스 0은 1000개라 , 클래스 11은 10개라 다. , 이다. 즉 흔한 클래스 0의 점수에서는 만 깎고, 드문 클래스 11의 점수에는 을 더해 준다. 두 클래스의 점수 차가 안쪽이면 판정이 뒤집힌다.
이 수식이 어디서 나오는지는 간단하다. 학습 데이터로 배운 모델은 를 근사한다. 그런데 우리가 알고 싶은 건 클래스가 균등한 세상에서의 다. 베이즈 정리로 두 식을 나누면 가 지워지고 사전확률의 비만 남는다. 로그를 씌우면 위의 뺄셈이 된다. 같은 이유로, 학습할 때 로짓에 를 더해 두고 배우는 방식도 쓴다. 둘 다 재 본다.
2. 직접 재 보기
[A] 전체 정확도는 무엇을 숨기나
먼저 아무 처방 없이 그냥 학습했다.
| 어떻게 쟀나 | 정확도 |
|---|---|
| 시험셋이 현실처럼 긴 꼬리일 때 전체 정확도 | 87.4% |
| 시험셋이 균등할 때 전체 정확도 | 61.8% |
| 흔한 쪽 4개 클래스 평균 | 90.8% |
| 드문 쪽 4개 클래스 평균 | 24.7% |
같은 모델인데 87.4%로도 보이고 61.8%로도 보인다. 차이는 모델이 아니라 시험셋의 모양이다. 현실에서 긁어 온 시험셋은 학습 데이터와 같은 긴 꼬리이므로, 전체 정확도는 자연히 흔한 클래스의 점수가 된다. 클래스별로 풀면 이렇게 생겼다.
클래스  0    1    2    3    4    5    6    7    8    9   10   11
정확도 96%  88%  90%  88%  81%  84%  66%  50%  25%  28%  26%  20%
개수 1000  658  433  285  187  123   81   53   35   23   15   10
애니메이션은 100스텝부터 3000스텝까지 클래스별 정확도가 어떻게 자리를 잡는지 보여 준다. 학습 초반에는 모두 낮다가, 흔한 쪽이 먼저 올라가고 드문 쪽은 거의 그 자리에 남는다. 전체 숫자만 보면 “학습이 잘 되고 있다”로 읽힌다.
그런데 여기서 가장 놀란 수치가 하나 나왔다.
드문 클래스 4개의 학습 데이터 정확도는 100.0%다.
10장, 15장, 23장, 35장짜리 클래스를 모델은 하나도 빠짐없이 맞힌다. 그런데 시험에서는 24.7%다. 즉 꼬리 클래스는 덜 배운 것이 아니다. 있는 건 다 배웠고, 볼 것이 모자란 것이다. 이 구분이 중요한 이유는 처방이 갈리기 때문이다 — 덜 배운 거라면 더 세게 배우게 하면 되지만, 볼 것이 모자란 거라면 더 세게 배워 봐야 그 몇 장에 더 매달릴 뿐이다.
[B] 흔히 쓰는 처방들 — 정말 듣나
여섯 가지를 같은 조건(3000스텝, 같은 구조·같은 시드)에서 비교했다. 정확도는 모두 균등 시험셋 기준이다. 마지막 두 열은 왜 그런 결과가 나왔는지 보려고 같이 잰 것이다.
| 방법 | 균형 정확도 | 흔한 쪽 | 드문 쪽 | 꼬리라고 말한 비율 | 그중 맞은 비율 |
|---|---|---|---|---|---|
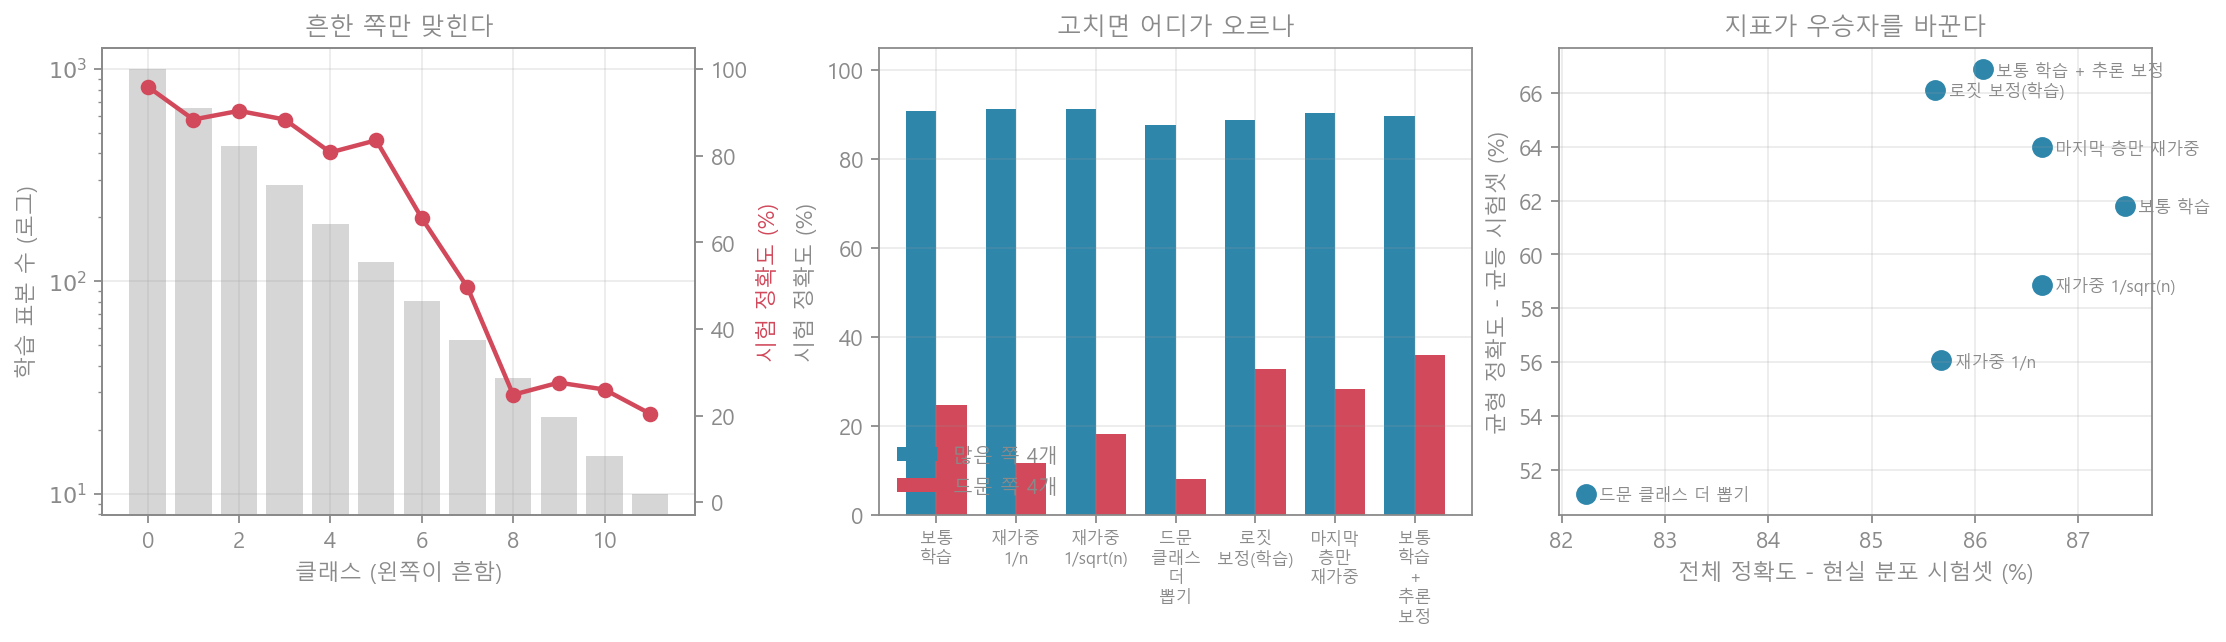
| 보통 학습 | 61.8% | 90.8% | 24.7% | 14.0% | 58.7% |
| 재가중 | 56.1% | 91.3% | 11.6% | 9.9% | 39.1% |
| 재가중 | 58.9% | 91.2% | 18.3% | 11.3% | 53.8% |
| 드문 클래스 더 뽑기(재표집) | 51.1% | 87.7% | 8.1% | 8.2% | 32.9% |
| 로짓 보정 (학습 때) | 66.1% | 88.8% | 32.7% | 20.9% | 52.2% |
| 마지막 층만 재가중 | 64.0% | 90.3% | 28.4% | 16.3% | 58.2% |
| 보통 학습 + 추론 때 보정 | 66.9% | 89.7% | 35.9% | 20.4% | 58.7% |
균등 시험셋에서 꼬리 4개가 차지하는 비율은 다. 그러니 “꼬리라고 말한 비율”의 이상값은 33.3%다.
교과서와 반대로 나온 것부터 보자. 불균형 하면 제일 먼저 나오는 처방인 재가중과 재표집이 보통 학습보다 나빠졌다. 그것도 하필 살리려던 드문 쪽이 24.7%에서 11.6%·8.1%로 떨어졌다.
왜인지는 마지막 두 열이 말해 준다. 재가중·재표집은 꼬리 클래스를 덜 말한다(14.0% → 9.9%, 8.2%). 꼬리를 세게 밀었는데 꼬리 예측이 줄어든 것이다. 게다가 꼬리라고 말했을 때 맞는 비율도 58.7%에서 39.1%·32.9%로 떨어졌다. 자신 있게 틀린다는 뜻이다. 흔한 쪽까지 87.7%로 내려간 걸 보면 모델 자체가 나빠졌다.
가설은 이랬다. 10장짜리 클래스에 100배 가중치를 주면, 그 10장을 통과시키려고 앞쪽 층의 표현까지 끌려간다. 앞쪽 층은 모든 클래스가 같이 쓰는 부품인데, 그걸 표본 10장에 맞춰 비틀면 전부 손해다. 반면 로짓 보정은 표현은 건드리지 않고 경계만 옮긴다.
그래서 가설을 가르는 실험을 하나 더 했다. 똑같은 재가중을, 앞쪽 층은 얼려 두고 마지막 층에만 거는 것이다.
def retrain_head(base, steps=1500, seed=7):
    """표현(앞쪽 층)은 보통 학습 그대로 두고, 마지막 층만 재가중으로 다시 배운다."""
    m = copy.deepcopy(base)
    for prm in m.parameters():
        prm.requires_grad_(False)
    m[-1] = nn.Linear(256, K).to(dev)          # 분류기만 새로
    w = (1.0 / PRIOR); w = w / w.mean()
    o = torch.optim.AdamW(m[-1].parameters(), lr=3e-3)
    for _ in range(steps):
        i = torch.randint(0, len(Y_TR), (256,), device=dev, generator=g)
        loss = F.cross_entropy(m(X_TR[i]), Y_TR[i], weight=w)
        o.zero_grad(); loss.backward(); o.step()
    return m
같은 가중치인데 56.1% → 64.0%로 8.9%p 올랐다. 흔한 쪽도 90.3%로 거의 그대로다. 즉 재가중이 나쁜 게 아니라, 재가중으로 표현까지 배우게 한 것이 나빴다. 이건 실제로 알려진 결론이기도 하다 — 표현은 원래 분포로 배우고, 분류기만 따로 고치는 쪽이 낫다.
가장 잘한 건 학습을 아예 다시 하지 않은 것이다. 보통 학습한 모델의 로짓에서 추론할 때 만 빼 줬더니 66.9%가 나왔다. 학습 비용 0이고, 이미 배포된 모델에도 바로 걸 수 있다. “꼬리라고 말한 비율”은 14.0%에서 20.4%로 올랐는데 맞는 비율은 58.7%로 그대로다 — 경계만 제자리로 돌아갔지 함부로 지르게 된 게 아니라는 뜻이다.
[C] 지표가 우승자를 바꾼다
같은 후보 여섯 개를 두 지표로 줄 세웠다. 전체 정확도는 현실과 같은 긴 꼬리 시험셋에서, 균형 정확도는 균등 시험셋에서 쟀다.
| 방법 | 전체 정확도 (현실 분포) | 균형 정확도 (균등) |
|---|---|---|
| 보통 학습 | 87.4% ← 1등 | 61.8% |
| 재가중 | 85.7% | 56.1% |
| 재가중 | 86.6% | 58.9% |
| 재표집 | 82.2% | 51.1% |
| 로짓 보정 (학습 때) | 85.6% | 66.1% |
| 마지막 층만 재가중 | 86.6% | 64.0% |
| 보통 학습 + 추론 때 보정 | 86.1% | 66.9% ← 1등 |
우승자가 다르다. 전체 정확도로 고르면 아무것도 하지 않은 모델이 1등이고, 균형 정확도로 고르면 보정한 모델이 1등이다. 둘은 서로 다른 세상을 가정하고 있다. 전체 정확도는 “앞으로 들어올 데이터도 지금처럼 기울어져 있다”를, 균형 정확도는 “모든 클래스가 똑같이 중요하다”를 가정한다.
어느 쪽이 맞는지는 데이터가 아니라 용도가 정한다. 추천 목록의 클릭률을 올리는 일이라면 흔한 것을 잘 맞히는 게 실제로 이득이다. 희귀 질환을 놓치지 않는 일이라면 정반대다. 그래서 순서가 중요하다 — 모델을 고르기 전에 지표를 먼저 정해야 한다. 거꾸로 하면 이미 고른 모델을 잘 보이게 하는 지표를 고르게 된다.
3. 흔한 오해와 한계
1. “정확도 90%면 잘 하는 모델이다” — 클래스가 기울어져 있으면 아니다. 극단적으로, 99%가 정상인 데이터에서 무조건 정상이라고 답하는 모델도 99%다. 위 실험의 87.4%도 절반은 그런 종류의 점수다. 불균형 데이터에서는 전체 정확도 한 줄로 보고하지 말고 클래스별로 풀어서 봐야 한다.
2. “불균형이면 일단 재가중” — 이 실험에서는 그게 가장 나쁜 선택 중 하나였다(56.1%, 재표집은 51.1%). 다만 이건 이 조건의 결과다. 클래스가 12개뿐이고 꼬리가 10장까지 내려가는 극단적인 설정이며, 사전학습 없이 작은 MLP를 처음부터 학습했다. 표현이 이미 충분히 좋은 상황 (대규모 사전학습 모델을 파인튜닝하는 경우)이라면 재가중이 표현을 망칠 여지도 그만큼 줄어든다. 확실한 건 재가중이 공짜가 아니라는 것이고, 걸었으면 클래스별로 재서 확인해야 한다는 것이다.
3. “꼬리 클래스는 더 오래 학습시키면 된다” — 학습 데이터 정확도가 이미 100%다. 더 배울 게 남아 있지 않다. 남은 방법은 경계를 옮기거나(보정), 표본을 실제로 늘리거나(수집·증강), 다른 데이터에서 배운 표현을 빌려 오는 것(전이학습)이다. “더 세게 배우게 하기”는 이 셋 중 어디에도 해당하지 않는다.
4. 로짓 보정은 경계를 옮길 뿐, 없는 정보를 만들지 않는다 — 66.9%도 흔한 쪽 89.7% / 드문 쪽 35.9%로 여전히 크게 갈라져 있다. 보정은 밀린 만큼 되미는 것이지 데이터 부족을 메우는 것이 아니다. 균형 정확도가 5.1%p 오르는 동안 현실 분포 전체 정확도는 87.4%에서 86.1%로 1.3%p 내렸다 — 공짜가 아니다.
5. 를 시험 분포로 착각하기 쉽다 — 빼 주는 건 학습 데이터의 클래스 비율이다. 배포 환경의 클래스 비율을 따로 안다면 그만큼 다시 더해 주면 된다. 이 실험에서는 배포 환경을 균등으로 가정했다.
4. 한 문단 요약
클래스 빈도가 100대 1로 기운 데이터로 학습하니 전체 정확도는 87.4%가 나왔는데, 드문 클래스 4개의 정확도는 24.7%였다. 같은 모델을 균등한 시험셋에서 재면 61.8%다 — 전체 정확도는 흔한 클래스의 점수다. 더 중요한 건 그 드문 클래스들의 학습 데이터 정확도가 100%였다는 사실이다. 꼬리는 덜 배운 게 아니라 볼 것이 모자란 것이고, 그래서 “더 세게 배우게 하는” 처방은 듣지 않는다. 실제로 재가중()은 56.1%, 재표집은 51.1%로 아무것도 안 한 61.8%보다 나빴다 — 꼬리 10장에 맞춰 앞쪽 층의 표현까지 비틀렸기 때문이다. 같은 재가중을 표현은 얼린 채 마지막 층에만 걸자 64.0%로 8.9%p 올랐다. 가장 잘한 건 학습을 다시 하지 않고 추론할 때 로짓에서 를 빼 준 것으로 66.9%였다. 그리고 이 후보들을 전체 정확도로 줄 세우면 아무것도 하지 않은 모델이 1등, 균형 정확도로 줄 세우면 보정한 모델이 1등이다 — 모델을 고르기 전에 지표를 먼저 정해야 한다.