인지야공/딥러닝 기초 정리/32번째 글
긴 문맥 — 위치는 왜 외삽되지 않는가
실행:
python NN_31_long_context.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
“문맥 100만 토큰”이 광고 문구가 된 지 오래다. 그런데 모델은 학습에서 본 길이 바깥을 잘 못 다룬다. 위치 인코딩 편에서 위치를 넣는 법을 봤다면, 이번엔 그 위치가 본 적 없는 범위로 나갔을 때 무슨 일이 생기는지를 잰다.
과제는 키-값 회상이다. 긴 수열 어딘가에 키 값이 나오고, 맨 끝에서 그 키를 다시 묻는다.
이건 어텐션 두 층이 필요한 전형적인 유도 헤드 과제다(앞 토큰을 보는 층 + 같은 키를 찾는 층).
1. 외삽 실패 — 본 적 없는 위치는 뜻이 없다
위치를 학습 가능한 임베딩으로 주면, 학습에서 안 나온 위치의 임베딩은 학습된 적이 없다. 아예 정보가 없다. 그럼 RoPE처럼 위치를 계산하는 방식은 어떨까. RoPE는 질의·키 벡터를 위치에 비례한 각도만큼 회전시킨다.
회전의 내적은 두 위치의 차이에만 의존하므로, 512번째 위치도 계산은 된다. 그래서 “RoPE는 외삽된다”는 기대가 있었다. 정말 그런지 쟀다.
| 기호 | 뜻 |
|---|---|
| 질의·키의 위치 | |
| 위치 에 해당하는 회전 | |
| 차원 쌍마다 다른 회전 속도(주파수) |
직접 재 보기 A
길이 16~64만 학습한 모델을 512까지 밀어 봤다. 천장은 같은 모델을 512까지 추가 학습한 것으로, “길수록 방해 토큰이 많아 과제 자체가 어려워지는 몫”을 흡수한다.
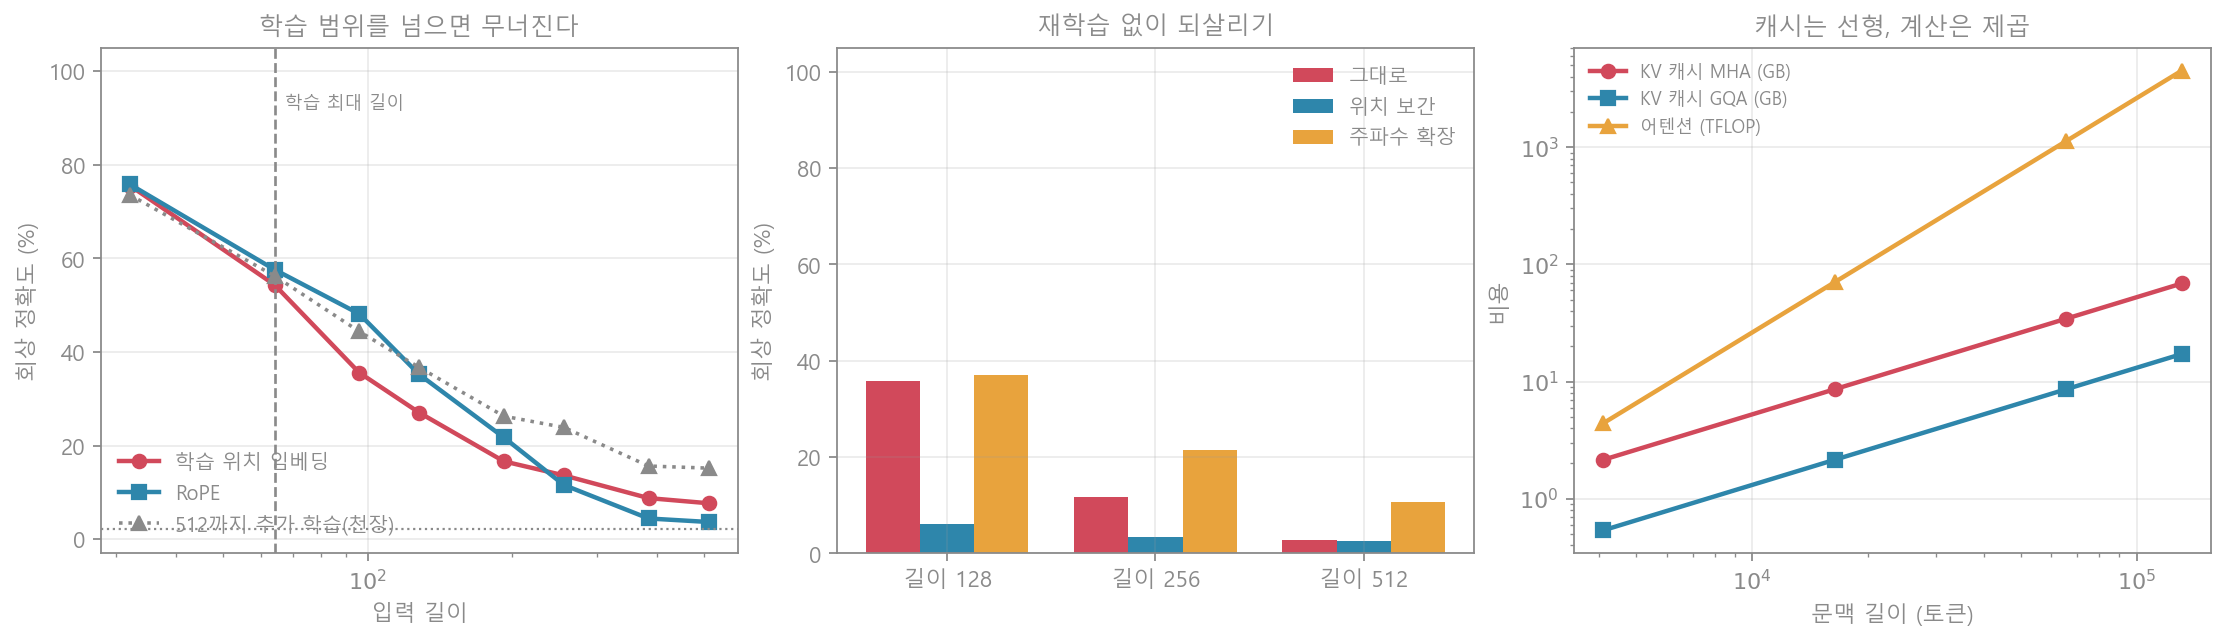
| 입력 길이 | 32 | 64 | 96 | 128 | 256 | 512 |
|---|---|---|---|---|---|---|
| 학습 위치 임베딩 | 75.6% | 54.4% | 35.6% | 27.1% | 13.7% | 7.7% |
| RoPE | 75.8% | 57.6% | 48.2% | 35.2% | 11.6% | 3.7% |
| 천장(512까지 추가 학습) | 73.6% | 56.2% | 44.4% | 36.7% | 23.9% | 15.2% |
(무작위 2.2%. 학습 범위는 64까지다.)
읽는 법이 중요하다. 천장도 길이가 늘면 떨어진다(73.6% → 15.2%) — 방해 토큰이 늘어 과제가 실제로 어려워지기 때문이다. 그러니 “길면 성능이 떨어진다”만으로는 아무것도 말할 수 없다. 천장과의 격차가 순수한 외삽 실패다.
- 학습 범위 안(32·64)에서는 세 모델이 사실상 같다(75% / 57%). 천장이 공정하다는 뜻이다.
- 256에서 RoPE는 11.6%인데 천장은 23.9% — 절반이다.
- 512에서 RoPE는 3.7%로 사실상 무작위인데, 천장은 15.2%다.
즉 RoPE도 외삽되지 않는다. 계산은 되지만, 학습에서 본 적 없는 회전 각도의 조합을 어텐션이 어떻게 해석해야 할지 배운 적이 없다. 위치는 “수식”이 아니라 학습된 습관이다.
2. 처방 — 눌러 담기와 주파수 늘리기
그래서 실무는 재학습 없이 위치를 학습 범위로 되돌리는 요령을 쓴다.
- 위치 보간(PI): 긴 입력의 위치를 학습 범위 안으로 눌러 담는다().
- 주파수 확장(NTK): 기저를 키워 같은 각도가 더 긴 거리를 덮게 한다().
직접 재 보기 B
같은 RoPE 모델에 두 요령을 적용했다(가중치는 그대로, 추론만 바꿈).
| 입력 길이 | 128 | 256 | 512 |
|---|---|---|---|
| 그대로 | 35.9% | 11.7% | 2.8% |
| 위치 보간 | 6.2% | 3.4% | 2.5% |
| 주파수 확장 | 37.1% | 21.5% | 10.7% |
주파수 확장은 재학습 한 번 없이 512에서 2.8%를 10.7%로 올렸다 — 추가 학습한 천장(15.2%)의 70% 수준이다. 공짜에 가까운 이득이다.
그런데 위치 보간은 오히려 나빠졌다(128에서 35.9% → 6.2%). 예상과 반대라 이유를 봤더니 분명했다. 보간은 위치를 8분의 1로 눌러 담는데, 이 과제의 핵심은 “키 바로 다음 토큰”을 집는 일이다. 눌러 담으면 인접한 두 위치의 각도 차이도 8분의 1이 되어, 바로 옆과 두 칸 옆을 구분할 해상도가 무너진다.
이건 위치 보간이 나쁜 기법이라는 뜻이 아니라, 보간은 파인튜닝을 전제로 한 기법이라는 뜻이다(원 논문도 소량 파인튜닝을 함께 쓴다). 반면 주파수 확장은 고주파(가까운 거리) 성분을 거의 건드리지 않아, 추론만 바꿔도 인접 관계가 살아남는다. 무엇을 희생하는지가 다르다.
3. 진짜 벽은 메모리
위치 문제를 다 풀어도 남는 것이 있다. KV 캐시 편에서 본 대로 생성은 캐시에 묶인다. 7B급 가정(32층, 헤드 차원 128, KV 헤드 32/8, fp16)으로 셈했다.
직접 재 보기 C
| 문맥 길이 | 4K | 16K | 64K | 128K |
|---|---|---|---|---|
| KV 캐시 (MHA 32헤드) | 2.15 GB | 8.59 GB | 34.36 GB | 68.72 GB |
| KV 캐시 (GQA 8헤드) | 0.54 GB | 2.15 GB | 8.59 GB | 17.18 GB |
| 어텐션 계산 | 4.4 TFLOP | 70.4 TFLOP | 1,126 TFLOP | 4,504 TFLOP |
캐시는 길이에 비례해 늘고(선형), 어텐션 계산은 제곱으로 는다. 128K 문맥에서 MHA 캐시는 68.7GB — 모델 가중치보다 훨씬 크고, 사용자 한 명이 GPU 한 장을 통째로 먹는다. GQA(KV 헤드를 8개로 줄여 공유)가 표준이 된 이유가 이것이다. 계산 쪽은 플래시 어텐션 편과 상태공간모델·선형 어텐션 편이 맡는다.
4. 흔한 오해와 한계
- “RoPE는 상대 위치라 외삽된다” — 계산은 되지만 성능은 안 따라온다(1절, 512에서 무작위 수준).
- “문맥 창이 100만이면 100만을 다 쓴다” — 창의 크기와 실제로 쓰는 범위는 다르다. 긴 문맥 벤치마크에서 중간이 잘 안 읽히는 현상(“lost in the middle”)이 보고되는 이유다.
- “보간이 항상 낫다” — 이 실험에선 오히려 해로웠다(2절). 파인튜닝과 함께 쓸 때의 기법이다.
- “긴 문맥이면 RAG가 필요 없다” — 비용이 다르다. 3절처럼 128K는 캐시만 수십 GB인데, RAG 편은 필요한 조각만 넣는다.
- 이 글의 실험 — 2층·64차원의 장난감이고, 과제도 단일 회상이다. 15.2%·10.7% 같은 수는 이 설정의 값이고, 요점은 외삽은 공짜가 아니다, 처방마다 희생하는 것이 다르다, 벽은 결국 메모리라는 구조다.
5. 한 문단 요약
긴 문맥의 첫 번째 문제는 위치가 외삽되지 않는다는 것이다. 길이 64까지 배운 모델은 512에서 3.7%로 무작위(2.2%) 수준이 됐고, 같은 길이를 추가 학습한 천장은 15.2%였다 — 그 격차가 순수한 외삽 실패다. RoPE가 상대 위치를 쓴다고 해서 면제되지 않는다. 처방으로 기저 주파수를 늘리면 재학습 없이 10.7%까지, 천장의 70%가 되살아났지만 위치 보간은 2.5%로 오히려 나빠졌다 — 위치를 눌러 담느라 “바로 다음 토큰”을 구분할 해상도를 잃기 때문이고, 그래서 보간은 파인튜닝과 짝으로 써야 한다. 그리고 이 모든 걸 해결해도 128K 문맥의 KV 캐시는 68.7GB다. 긴 문맥은 위치 문제이자, 결국 메모리 문제다.