인지야공/딥러닝 기초 정리/31번째 글
추론 시간 계산 — 더 생각하면 더 맞히나
실행:
python NN_29_test_time_compute.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 필요한 공학: 한 번에 풀기의 벽 노트.
⚠ 고친 기록 (2026-09-23) — 1절에서 길이 3이 안 풀리는 이유를 “조합이 많아 못 외운다”로 설명했는데, 추가 검증에서 틀린 설명으로 드러났다. 조합 수의 8.9배를 학습시켜도 학습 손실이 내려오지 않았다. 원인은 암기 용량이 아니라 학습 가능성이다. 아래 1절을 실측으로 다시 썼다.
스케일링 법칙 편은 학습을 키우는 이야기였다. 그런데 요즘 모델이 좋아지는 또 하나의 축은 답할 때 계산을 더 쓰는 것이다. 생각을 길게 쓰게 하고, 여러 번 풀어 보게 하고, 확인해 보게 한다. 얼마나 도움이 되는지, 그리고 어디까지인지를 잰다.
과제는 순열 합성이다. 5개짜리 순열(120가지)을 개 이어 붙여 합성한 결과를 맞힌다. 순서가 중요하고 지름길이 없어, “한 번에 보기”와 “한 단계씩 풀기”의 차이가 드러난다.
1. 사고 사슬 — 깊이를 시간으로 사기
사고 사슬(chain-of-thought)은 모델에게 답만 내지 말고 중간 과정을 써 가며 풀게 하는 것이다. 왜 도움이 될까. 흔한 설명은 “모델이 차근차근 생각해서”인데, 구조적으로 보면 더 단순하다 — 한 번의 순전파는 고정된 만큼만 계산하지만, 토큰을 더 뱉으면 그만큼 계산을 더 하기 때문이다.
직접 재 보기 A
같은 과제를 두 방식으로 학습시켰다. 한 번에는 길이 짜리 문제를 통째로 받아 답을 내고(길이마다 따로 학습), 한 단계씩은 두 원소의 합성만 배운 뒤 추론 때 번 적용한다.
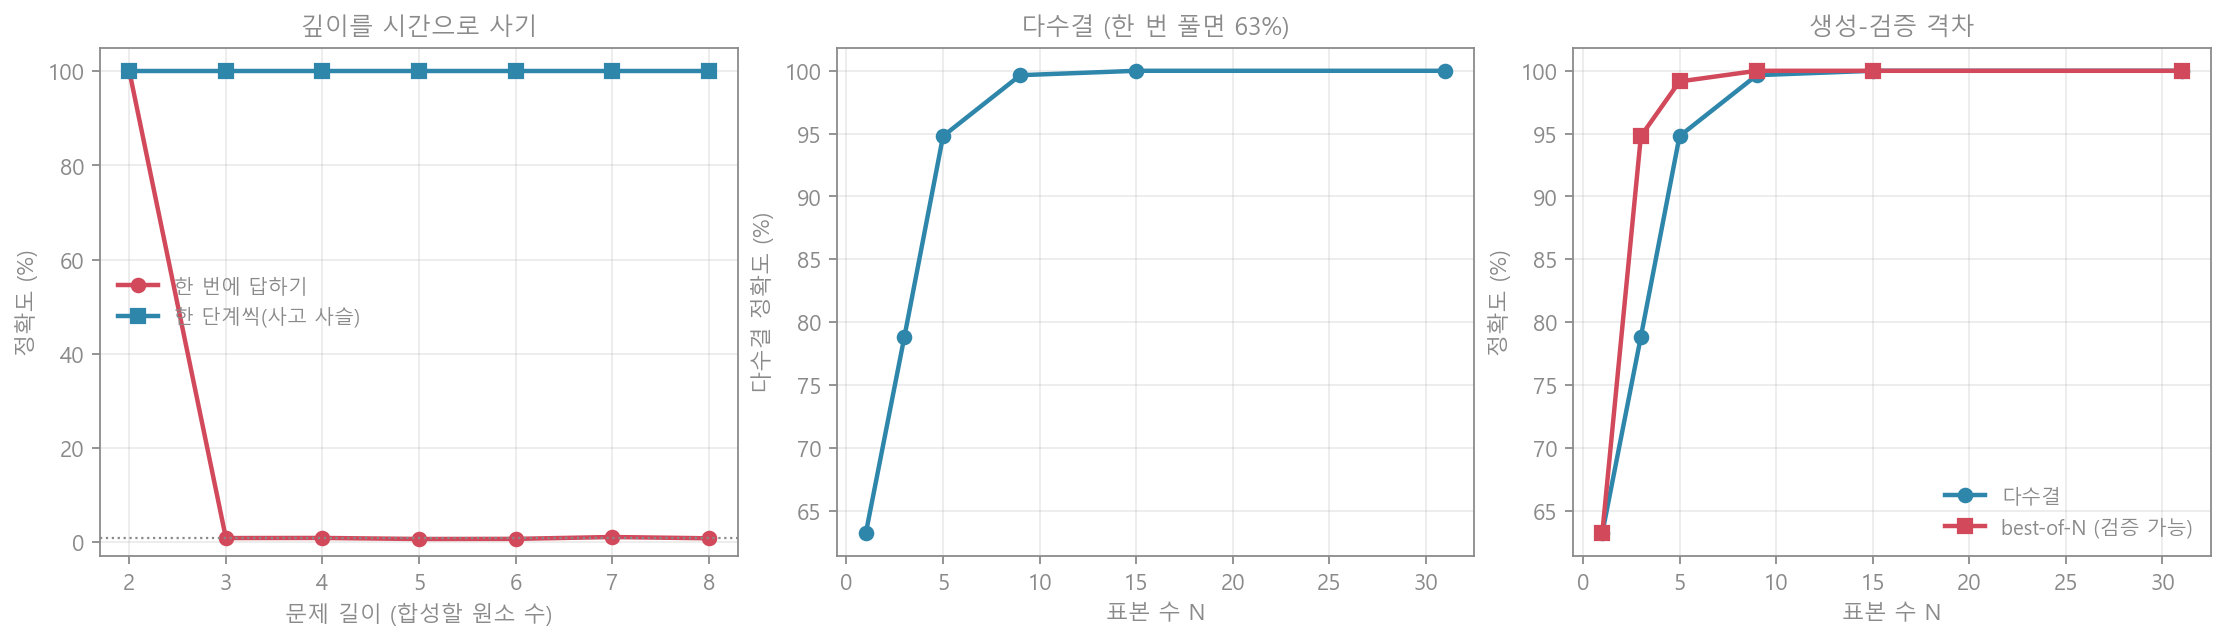
| 문제 길이 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|
| 한 번에 답하기 | 100.0% | 0.9% | 0.9% | 0.7% | 0.7% | 1.1% | 0.9% |
| 한 단계씩(사고 사슬) | 100.0% | 100.0% | 100.0% | 100.0% | 100.0% | 100.0% | 100.0% |
무작위가 0.8%다. 한 번에 답하는 모델은 길이 3에서 절벽처럼 무너지고, 한 단계씩 푸는 쪽은 길이 8까지 완벽하다.
왜 하필 3일까. 층을 8배로 늘려도 결과가 같았고, 학습량을 조합 수의 8.9배로 늘려도 같았다 (노트에서 따로 쟀다 — 거기서 세운 가설이 두 번 틀렸다). 결정적인 것은 학습 손실이다. 길이 3에서는 1,536만 개를 보고도 손실이 , 곧 아무것도 모르고 찍는 수준에서 내려오지 않았다. 시험을 못 본 게 아니라 교과서조차 외우지 못한 것이다. 반면 길이 2는 손실이 0.028까지 떨어지며 100%가 된다.
즉 벽은 깊이도 데이터 양도 아니고 학습 가능성이다. 길이 2가 풀린 것은 합성 규칙을 배워서가 아니라 서로 다른 입력 14,400가지를 곱셈표로 외운 것이고, 길이 3부터는 외울 수도(172만 가지) 배울 수도 없다.
사고 사슬이 하는 일이 여기서 분명해진다. 외워야 할 것을 한 단계(14,400가지)로 줄이고, 나머지는 반복으로 처리하는 것이다. 모델이 똑똑해진 게 아니라 문제를 모델이 할 수 있는 크기로 잘라 준 것이다. 루프 트랜스포머 편·잠재 반복 vs 토큰 사슬 편에서 본 “계산을 파라미터가 아니라 시간으로 사기”와 정확히 같은 거래다.
2. 다수결 — 여러 번 풀고 표를 센다
두 번째 방법은 같은 문제를 여러 번 풀어 가장 많이 나온 답을 고르는 것이다(자기 일관성, self-consistency). 풀이가 흔들린다면, 틀리는 방향은 제각각이고 맞는 방향은 하나이므로 표가 모인다.
직접 재 보기 B
풀이기에 온도를 넣어 흔들리게 만들고(온도 3.0에서 한 번 풀기 11.6%), 길이 6짜리 문제 2,000개를 풀었다.
| 표본 수 | 1 | 3 | 5 | 9 | 15 | 31 |
|---|---|---|---|---|---|---|
| 다수결 정확도 | 11.6% | 13.9% | 18.7% | 30.0% | 46.8% | 69.9% |
11.6%가 69.9%로, 6배가 됐다. 모델도 학습도 그대로이고 답할 때 계산만 31배 썼다. 이 곡선이 “추론 시간 계산을 늘리면 좋아진다”는 말의 실체다.
다만 한계가 분명하다. 다수결은 가장 흔한 답이 정답일 때만 듣는다. 모델이 일관되게 틀리는 문제(잘못 배운 규칙, 편향된 오해)에서는 표를 아무리 세도 틀린 답만 굳어진다. 계산을 늘리면 무한정 좋아지는 것이 아니라, 모델이 이미 답을 알고 있되 흔들릴 뿐인 문제에서만 좋아진다.
3. 검증 — 확인할 수 있으면 판이 달라진다
세 번째는 답을 확인하는 것이다. 코드는 테스트를 돌려 보면 되고, 수학은 검산이 되고, 게임은 규칙으로 판정된다. 확인만 된다면 N개 중 맞은 게 하나라도 있으면 이긴다(best-of-N).
직접 재 보기 C
같은 표본으로 다수결과 best-of-N을 나란히 봤다.
| 표본 수 | 1 | 3 | 5 | 9 | 15 | 31 |
|---|---|---|---|---|---|---|
| 다수결 | 11.6% | 13.9% | 18.7% | 30.0% | 46.8% | 69.9% |
| best-of-N (검증 가능) | 11.6% | 33.2% | 48.1% | 68.5% | 85.6% | 97.6% |
| 격차 | 0.0%p | 19.3%p | 29.4%p | 38.6%p | 38.8%p | 27.7%p |
같은 31번의 시도가 다수결로는 69.9%, 검증이 되면 97.6%다. 격차가 최대 38.8%p까지 벌어진다.
이것이 생성-검증 격차다. 정답을 만들기는 어려워도 알아보기는 쉬운 문제가 많고, 그런 문제에서는 “여러 번 시도하고 골라내기”가 압도적으로 강하다. 코딩·수학·정리 증명에서 추론 시간 계산이 유독 잘 먹히는 이유이고, 반대로 검증이 어려운 일(글의 품질, 전략의 타당성)에서 이득이 작은 이유이기도 하다. 그래서 실무는 검증자를 따로 학습시키고(보상 모델, RLHF와 DPO 편), 그 검증자가 틀리면 그만큼 명세 게이밍 편의 문제가 그대로 돌아온다 — 검증자를 속이는 답이 골라지기 때문이다.
4. 흔한 오해와 한계
- “생각을 길게 하면 똑똑해진다” — 정확히는 외울 것을 줄이고 반복으로 바꾸는 것이다(1절). 한 단계가 틀리면 사슬 전체가 틀린다는 점도 같이 따라온다.
- “표본을 늘리면 계속 오른다” — 다수결은 모델이 일관되게 틀리는 문제에서 무력하다(2절).
- “best-of-N이 항상 낫다” — 검증이 될 때만이다. 검증자가 부정확하면 격차는 사라지고, 검증자를 속이는 답이 뽑히는 역효과까지 생긴다.
- “공짜로 성능이 오른다” — 31배의 계산은 31배의 비용이다. 학습을 키우는 것과 추론을 키우는 것 사이의 예산 배분 문제이지, 공짜 점심이 아니다.
- 이 글의 실험 — 순열 합성이라는 장난감이고, 사고 사슬을 “한 단계 모델의 반복”으로 이상화했다. 실제 언어모델의 사고 사슬은 자기 출력을 다시 읽는 것이라 오류가 누적되기 쉽다. 69.9%·97.6%는 이 설정의 값이고, 요점은 직렬화·다수결·검증이라는 세 가지 지렛대와 각각의 한계다.
5. 한 문단 요약
학습을 키우지 않고도 성능을 올리는 세 지렛대를 쟀다. 사고 사슬은 한 번에 풀 수 없는 문제를 잘라 준다 — 한 번에 답하는 모델은 외울 수 있는 길이 2까지만 100%이고 길이 3부터 무작위(0.9%)인데, 한 단계씩 풀게 하니 길이 8까지 100%였다. 다수결은 흔들리는 풀이를 31번 모아 11.6%를 69.9%로 올렸지만, 모델이 일관되게 틀리는 문제에는 듣지 않는다. 검증이 가능하면 같은 31번으로 97.6%까지 가, 다수결과 최대 38.8%p의 격차가 났다 — 만들기보다 알아보기가 쉬운 문제에서 추론 시간 계산이 특히 강하다는 뜻이다. 다만 세 가지 모두 모델이 이미 가진 능력을 꺼내는 장치이고, 검증자가 틀리면 틀린 답을 골라내는 쪽으로 되돌아온다.