인지야공/딥러닝 기초 정리/2번째 글
역전파 — 기울기를 한 번에 다 구하는 법
실행:
python NN_51_backprop.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
loss.backward() 한 줄이 무엇을 하는지는 알고 넘어가야 한다. 이 연재의 모든 학습이 그 줄 위에서
돌아갔고, PyTorch 치트시트 편에서 본 “메모리가 부족하다”는
에러의 절반도 이 줄에서 나온다.
학습은 “손실을 줄이는 방향으로 파라미터를 조금씩 옮기는 일”이다. 그 방향이 기울기다. 파라미터가 수백만 개면 기울기도 수백만 개다. 역전파는 그 수백만 개를 순전파 두세 번 값에 한꺼번에 구하는 방법이다.
1. 뒤에서부터 곱해 온다 — 그림으로 먼저
가장 작은 예로 시작한다. 일 때 를 계산하고, 를 각 입력으로 미분한다.
순전파(파랑)는 왼쪽에서 오른쪽으로 값을 계산한다. , , .
역전파(빨강)는 오른쪽에서 왼쪽으로, 각 자리에서 “그 자리가 1만큼 변하면 가 얼마나 변하나”를 돌려보낸다. 출발점은 이다. 노드 하나를 지날 때마다 그 노드의 국소 미분을 곱하면 된다.
| 노드 | 국소 미분 | 받은 값 × 국소 미분 = 돌려보내는 값 |
|---|---|---|
| 양쪽 모두 | 를 그대로 와 에 | |
| 쪽은 , 쪽은 | 에 , 에 |
직접 미분해서 확인하면 로 같다. 이것이 연쇄법칙이다.
| 기호 | 뜻 |
|---|---|
| 손실 | |
| 번째 층의 출력(중간값) | |
| 번째 층의 파라미터 | |
| 한 층을 지날 때의 국소 미분 (야코비안 노트의 그 행렬) |
역전파가 빠른 이유가 이 식의 모양에 있다. 오른쪽 끝의 부터 왼쪽으로 한 번만 곱해 오면, 지나가는 길에 모든 층의 가 한꺼번에 나온다. 파라미터마다 따로 계산하지 않는다.
대가도 이 식에 있다. 국소 미분을 계산하려면 순전파 때의 중간값이 필요하다. 위 그림에서 노드가 를 돌려보내려면 을 기억하고 있어야 했다. 그래서 역전파는 순전파의 중간값을 전부 들고 있어야 한다.
2. 직접 재 보기
[A] 셋이 같은 값을 내는가
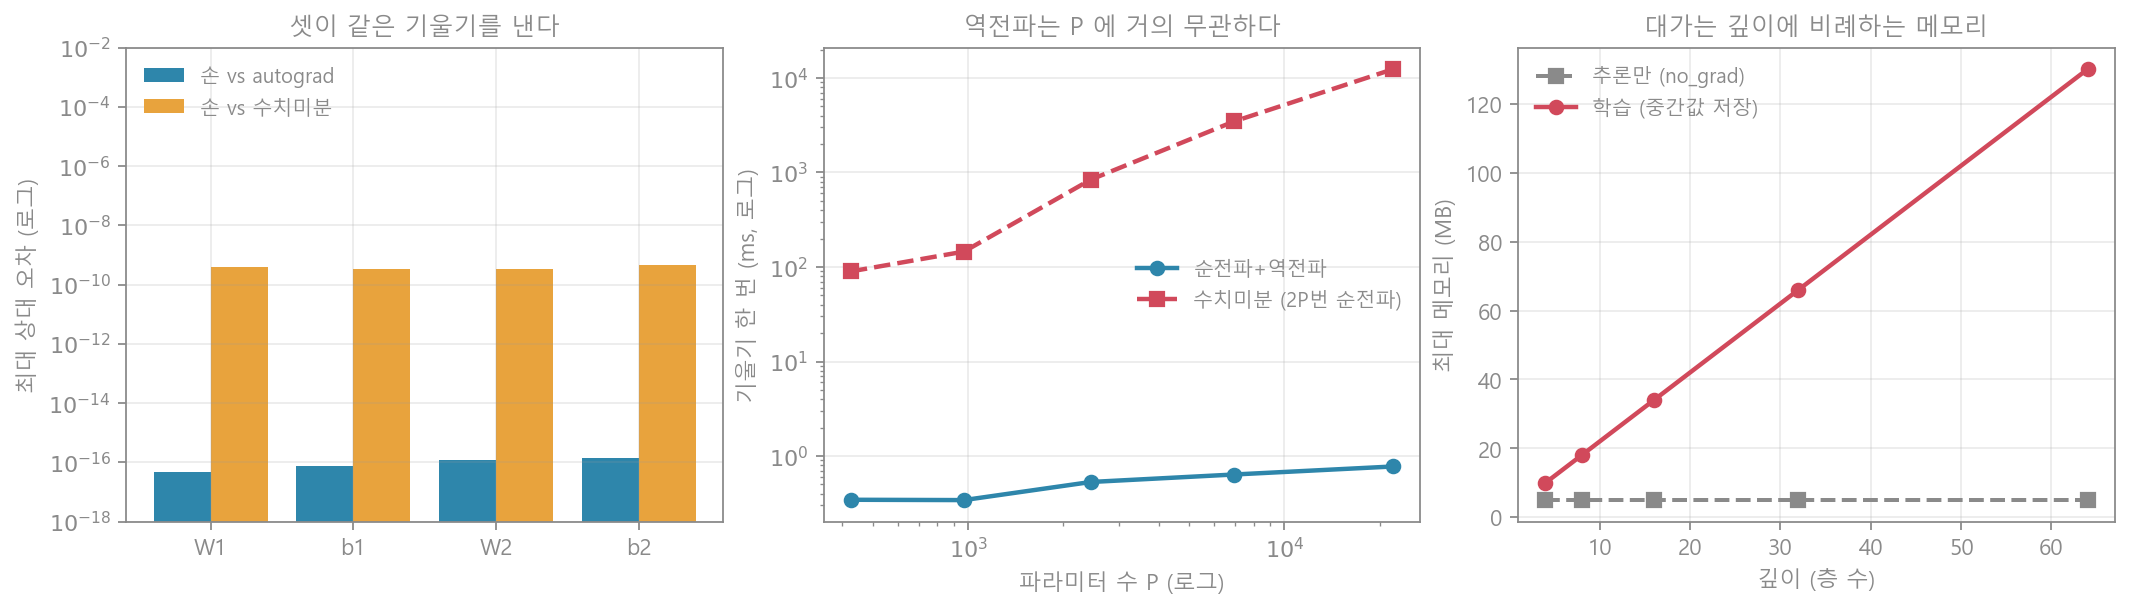
입력 6 → 은닉 8(tanh) → 출력 3인 작은 망(파라미터 83개)에서 기울기를 세 가지로 구했다.
① 위 표처럼 연쇄법칙을 손으로 한 줄씩 쓴 것, ② loss.backward(), ③ 파라미터를 하나씩
만큼 흔들어 손실 변화를 재는 수치미분.
| 파라미터 | 손 vs autograd | 손 vs 수치미분 |
|---|---|---|
(최대 상대 오차, float64)
손으로 쓴 것과 autograd는 float64의 반올림 한계()까지 같다. autograd가 하는 일이 정확히 위의 표라는 뜻이다. 수치미분과는 까지 맞는다. 차이는 흔드는 폭 에서 오는 근사 오차다.
그런데 수치미분에 순전파를 166번 돌렸다. 파라미터 83개마다 앞뒤로 두 번씩이다.
[B] 값어치 — 파라미터가 늘면
망의 폭을 키워 가며 기울기 한 번을 구하는 시간을 쟀다.
| 파라미터 수 | 순전파 1번 | 순전파+역전파 | 배수 | 수치미분 (2P번 순전파) |
|---|---|---|---|---|
| 426 | 0.105 ms | 0.344 ms | 3.3× | 89.8 ms |
| 970 | 0.075 ms | 0.342 ms | 4.6× | 145.5 ms |
| 2,442 | 0.172 ms | 0.531 ms | 3.1× | 840.5 ms |
| 6,922 | 0.250 ms | 0.637 ms | 2.5× | 3,465.1 ms |
| 22,026 | 0.281 ms | 0.775 ms | 2.8× | 12,378.0 ms |
수치미분 열은 “순전파 1번 시간 × 2P”로 추정한 값이다. 추정이 맞는지 가장 작은 망에서는 실제로 돌려 봤다 — 추정 89.8 ms, 실제 71.1 ms로 같은 크기다. (시간은 CPU에서 잰 값이라 실행마다 조금씩 흔들린다.)
역전파는 파라미터 수와 거의 무관하게 순전파의 2.5~4.6배에 머문다. 수치미분은 파라미터 수에 비례해서, 2만 개에서 이미 1만 6천 배 차이가 난다. 파라미터가 수십억 개인 모델에서 수치미분은 선택지가 아니다.
[C] 대가 — 중간값을 기억한다
폭 1024, 배치 512인 층을 쌓아 가며 순전파 직후의 최대 GPU 메모리를 쟀다. 모델 가중치는 빼고 활성값만 센 것이다.
| 깊이 | 추론만 (no_grad) | 학습 (기울기 준비) |
|---|---|---|
| 4 | 5.0 MB | 10.0 MB |
| 8 | 5.0 MB | 18.0 MB |
| 16 | 5.0 MB | 34.0 MB |
| 32 | 5.0 MB | 66.0 MB |
| 64 | 5.0 MB | 130.0 MB |
추론은 깊이와 무관하게 5.0 MB다. 층을 지나면 앞 층의 출력을 버려도 되기 때문이다. 학습은 층마다 정확히 2.0 MB씩 는다. 배치 512 × 폭 1024 × 4바이트 = 2.0 MB, 한 층 출력 하나의 크기다. 역전파 때 그 층의 국소 미분을 계산하려고 전부 들고 있는 것이다.
이것이 혼합정밀도 편의 그래디언트 체크포인팅이 존재하는 이유다. 중간값 일부를 버리고 역전파 때 다시 계산해서, 메모리를 시간과 바꾼다.
(첫 측정에서는 깊이 4의 추론이 학습보다 메모리를 더 쓰는 이상한 값이 나왔다. 첫 행렬곱이 cuBLAS 작업 공간을 따로 잡기 때문이었고, 측정 전에 한 번 돌려 두는 것으로 고쳤다.)
3. 흔한 오해와 한계
1. “역전파는 기울기의 근사다” — 아니다. [A]에서 손으로 쓴 정확한 미분과 부동소수점 한계까지 같았다. 근사는 수치미분 쪽이다.
2. “역전파 비용은 순전파와 같다” — 이 실험에서는 2.5~4.6배였다. 역전파는 층마다 입력 쪽 기울기와 가중치 쪽 기울기를 둘 다 계산해서 대략 행렬곱이 두 배다. 작은 망에서는 파이썬 오버헤드가 섞여 배수가 더 흔들린다.
3. “학습 메모리 = 모델 크기” — [C]에서 가중치를 빼고도 활성값만으로 깊이에 비례해 불어났다. 배치를 두 배로 하면 이 부분도 두 배다. 큰 모델이 학습 때 추론보다 훨씬 많은 메모리를 먹는 주된 이유다.
4. 수치미분은 쓸모없는가 — 검증용으로는 여전히 표준이다. 역전파를 직접 구현했거나 커스텀 연산을 만들었으면,
작은 입력에서 [A]처럼 수치미분과 맞대 보는 것(torch.autograd.gradcheck)이 가장 확실한 검사다.
4. 한 문단 요약
역전파는 손실 쪽에서 로 출발해, 층을 거꾸로 지나며 국소 미분을 곱해 오는 연쇄법칙이다. 손으로 쓴 역전파와 autograd는 , 수치미분과는 까지 같은 기울기를 냈다. 값어치는 속도다 — 파라미터 2만 2천 개에서 수치미분은 12,378 ms, 역전파는 0.775 ms였고, 역전파는 파라미터 수와 무관하게 순전파의 2.5~4.6배에 머물렀다. 대가는 메모리다. 국소 미분에 순전파 중간값이 필요해서 층마다 그 층 출력 크기(2.0 MB)씩 학습 메모리가 늘었고, 추론은 깊이와 무관하게 5.0 MB였다.