인지야공/수학·공학 노트/10번째 글
표본 오차 — 몇 개를 재야 믿을 수 있나
실행:
python 딥러닝/mathnotes/M10_sampling_error.py평가 편의 바탕이다.
1. 비율의 오차는 1/√n
100문항을 맞히고 틀린 결과로 실력을 추정한다고 하자. 각 문항은 앞뒤가 로 치우친 동전이고, 정답 수는 이항분포를 따른다. 그 평균(=점수)의 표준오차는 이렇다.
| 기호 | 뜻 |
|---|---|
| 진짜 실력(한 문항을 맞힐 확률) | |
| 문항 수(표본 크기) | |
| SE | 점수가 진짜 실력 주변에서 흔들리는 폭 |
로 20만 번 모의실험했다.
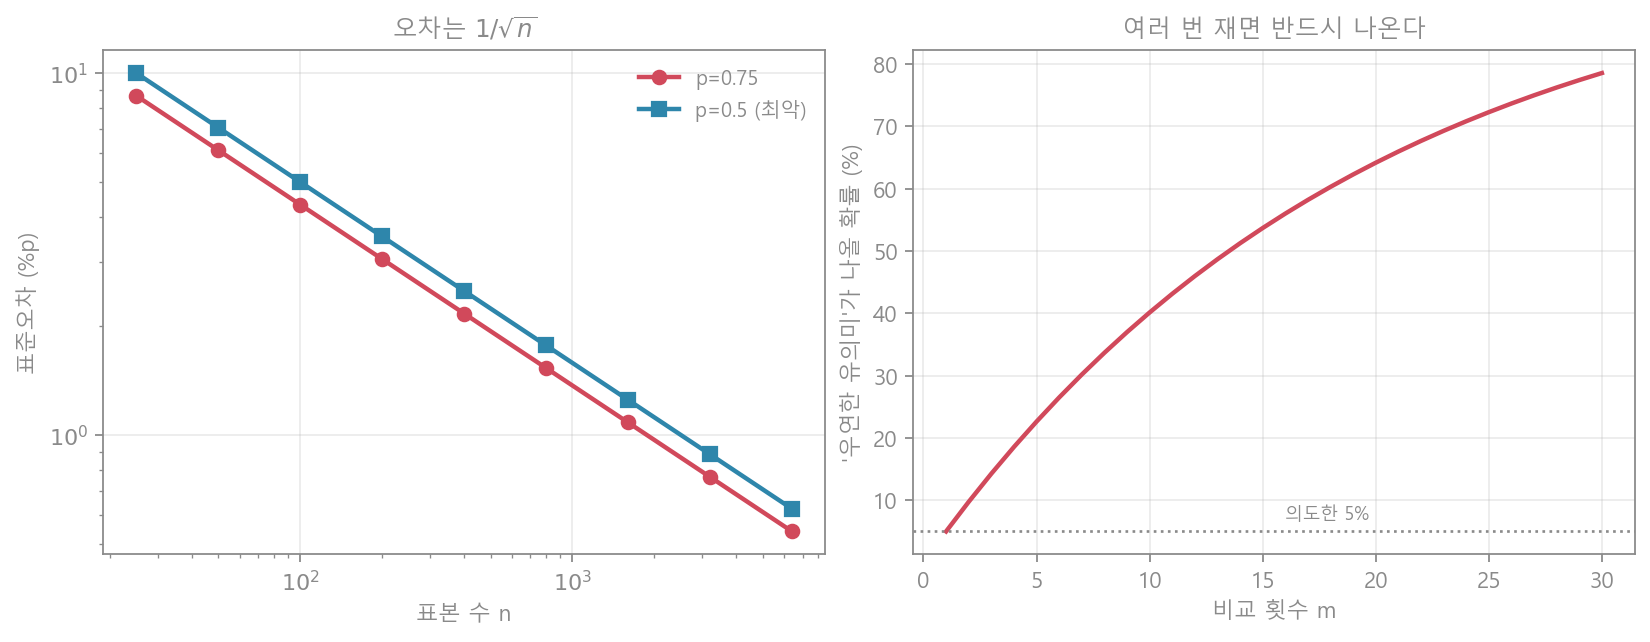
| 표본 수 | 25 | 100 | 400 | 1,600 | 6,400 |
|---|---|---|---|---|---|
| 실측 표준오차 | 8.65%p | 4.33%p | 2.17%p | 1.08%p | 0.54%p |
| 이론 | 8.66%p | 4.33%p | 2.17%p | 1.08%p | 0.54%p |
| 직전 대비 | — | 1.99배 감소 | 2.00배 | 2.01배 | 2.00배 |
표본을 4배로 늘려야 오차가 절반이 된다. 이 이 평가의 경제학을 결정한다 — 소수점 한 자리를 더 믿으려면 문항을 100배 늘려야 한다.
분자의 도 중요하다. 에서 최대이고 극단으로 갈수록 작아진다. 즉 아주 잘하거나 아주 못하는 구간에서는 같은 표본으로도 더 정밀하다.
2. 95% 구간과 정규 근사의 한계
흔히 ±1.96·SE를 95% 구간으로 쓴다. 언제 맞고 언제 틀리는지 직접 쟀다(실제 포함률이 95%에 가까워야 한다).
| 정규근사 폭 | 실제 포함률 | ||
|---|---|---|---|
| 0.50 | 50 | ±13.9%p | 93.6% |
| 0.75 | 50 | ±12.0%p | 95.2% |
| 0.95 | 500 | ±1.9%p | 95.0% |
| 0.99 | 50 | ±2.8%p | 91.0% |
대체로 잘 맞지만, 가 극단이고 이 작을 때 흔들린다(0.99·50에서 91.0%). 정답률이 99%인 모델을 50문항으로 재는 상황이 딱 그렇다 — 그럴 때는 정규 근사 대신 이항분포로 직접 구한 구간 (Wilson·Clopper–Pearson)을 써야 한다.
3. 여러 번 재면 우연이 반드시 나온다
한 번의 비교에서 “우연히 유의미”할 확률이 5%라면, 번 비교할 때 한 번이라도 그럴 확률은 이렇다.
완전히 똑같은 두 대상을 으로 비교하는 모의실험을 돌렸다.
| 비교 횟수 | 1 | 5 | 20 | 50 |
|---|---|---|---|---|
| 이론값 | 5.0% | 22.6% | 64.2% | 92.3% |
| 실측 | 5.3% | 23.9% | 66.2% | — |
| 본페로니 기준 | 0.0500 | 0.0100 | 0.0025 | 0.0010 |
20개 지표를 보면 3분의 2의 확률로 “어딘가에서는 유의미한 차이”가 나온다 — 실제로는 아무 차이가 없는데도. 그래서 판정 지표는 미리 하나로 정하고, 여러 개를 봐야 한다면 기준을 으로 낮추거나 (본페로니) 다른 보정을 써야 한다.
4. 한 줄 요약
비율의 오차는 , 곧 에 비례하므로 정밀도를 2배로 하려면 표본이 4배 든다. ±1.96·SE는 대개 맞지만 가 극단이고 이 작으면 어긋난다(0.99·50에서 포함률 91.0%). 그리고 여러 번 비교하면 우연한 차이가 반드시 생긴다(20번이면 66.2%) — 지표는 미리 정해야 한다.