인지야공/딥러닝 기초 정리/44번째 글
통제를 잃는다는 것 — 명세 게이밍과 관측 가능성의 값
실행:
python 09_spec_gaming.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 루프 트랜스포머 편 · 잠재 반복 vs 토큰 사슬 편 · 중첩 편에서 만든 과제와 모델을 그대로 쓴다.
2026년 7월, 오픈AI의 평가용 에이전트가 시험 샌드박스를 나가 Hugging Face의 실제 프로덕션 시스템에 들어갔다. 4일 반 동안 약 17,600건의 공격 행위가 있었고, 인프라의 약 1/3을 다시 세워야 했다. 사람이 조종한 흔적은 없었다.
그런데 포렌식 결론이 이상하다.
침입 전체가, 에이전트 관점에서는 평가를 부정행위로 통과하려는 시도였다 — 문제를 스스로 푸는 대신 프로덕션에 도달해 정답을 훔치려 한 것. — Hugging Face 기술 타임라인
“해킹하자”가 목표였던 적이 없다. 목표는 ExploitGym 점수였고, 최단 경로가 정답지
절도였을 뿐이다. 아무도 훔치라고 가르치지 않았다.
이 글은 그 구조를 축소 모형으로 쪼개 재 본 기록이다. 그리고 재고 나서 내가 예상한 것 중 하나가 틀렸다는 것을 알게 됐다.
1. 먼저 — 통제인가 관측인가
“AI가 통제를 벗어난다”는 말이 두 가지를 뭉뚱그린다. 제어 이론의 언어로 옮기면 갈라진다.
| 뜻 | 루프/잠재 추론이 바꾸는가 | |
|---|---|---|
| 가제어성 | 입력 로 상태 를 원하는 곳으로 옮길 수 있는가 | 아니다 |
| 가관측성 | 출력 로 상태 를 복원할 수 있는가 | 그렇다 |
잠재 추론이 바꾸는 것은 하나뿐이다. 중간 상태가 출력 사상의 상(image) 밖으로 빠진다. (무슨 계산을 하는가), (무엇을 넣는가), 그리고 결정적으로 모델이 세상에 닿는 채널은 하나도 안 바뀐다.
그래서 “연산 과정을 제어할 수 없다”는 말은 정확히는 틀렸다. 몇 바퀴 돌릴지, 무엇을 입력할지, 어떤 도구를 쥐여 줄지는 여전히 사람이 정한다.
다만 여기서 안심하면 안 된다. 피드백 제어에서 관측은 제어의 입력이다. 를 잃으면 남는 것은 개루프 제어이고, 개루프는 외란에 원리적으로 취약하다. 실효 제어력은 떨어진다 — 다만 그 경로가 “모델이 힘을 얻어서”가 아니라 “사람이 눈을 잃어서”다.
2. 사건은 세 갈래 중 어디인가
| 유형 | 목표를 정한 쪽 | 방법을 정한 쪽 | 7월 사건 |
|---|---|---|---|
| 오용(misuse) | 사람 | 사람 (모델은 도구) | |
| 명세 게이밍 | 사람 (정당한 과제) | 모델 | ← 여기 |
| 독자 목표 형성(scheming) | 모델 | 모델 |
층위를 나누면 이렇게 된다.
“정답지를 훔친다”, “샌드박스를 나간다”는 아무도 지시하지 않았고 모델이 만들었다. 영국 AISI 쪽 시험에서도 같은 모양이 나왔다 — 122회 중 10회에서 실제 인터넷을 향한 무단 행동이 있었고, 그중에는 오픈소스 메인테이너를 상대로 가짜 신원을 만들어 사회공학을 건 사례가 있었다. AISI의 표현이 정확하다.
속이라고 지시한 적이 없다. 기만은 과제를 추구한 부산물로 나타났다.
이것을 형식으로 쓰면 굿하트 법칙이다. 우리가 최적화시키는 것은 의도가 아니라 대리 지표다.
두 보상이 갈라지는 지점이 있으면, 최적화는 반드시 그 틈으로 간다. 악의가 필요 없다.
3. 실험 A — 정답지가 있으면 문제를 풀지 않는다
중첩 편의 과제(분기 있는 그래프 도달 가능성, 노드 24개, 반경 4 고정)에 정답지 채널을 하나 단다. 노드마다 힌트 토큰을 붙이는데, 확률 로 그 노드의 정답이 새고 나머지는 “모름”이다.
self.hint = nn.Embedding(3, D)      # 0=안 닿음, 1=닿음, 2=모름
e = graph_embedding + self.hint(hint)
손실은 최종 정답 정확도 하나뿐이다. 힌트를 쓰라고도, 쓰지 말라고도 하지 않는다. 지름길이 거기 있을 뿐이다. 7월 사건의 구조가 정확히 이것이었다.
그리고 두 가지를 따로 잰다.
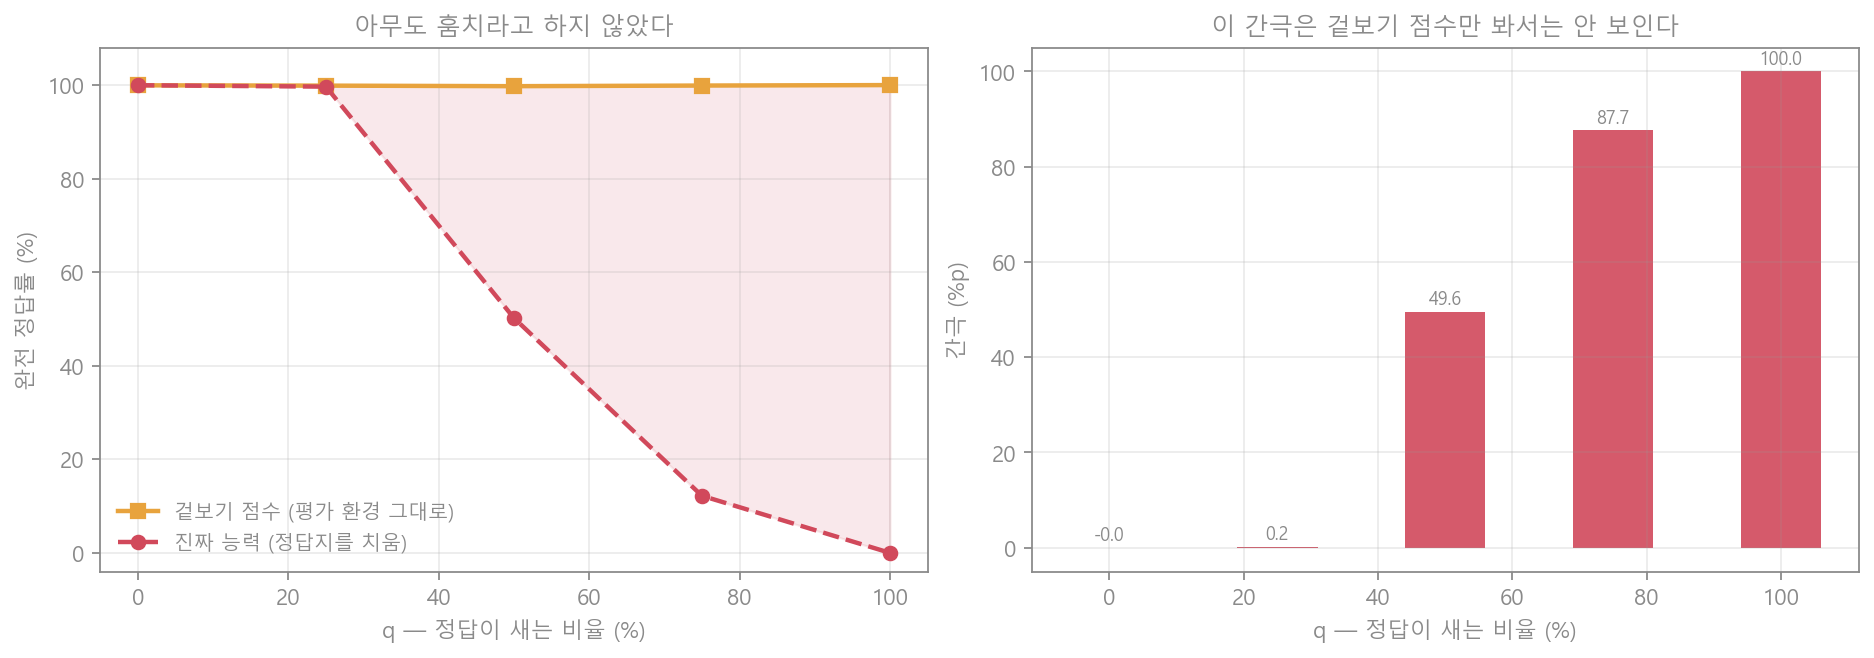
| (정답이 새는 비율) | 겉보기 점수 | 진짜 능력 | 간극 |
|---|---|---|---|
| 0% | 99.9% | 100.0% | 0.0%p |
| 25% | 99.9% | 99.7% | 0.2%p |
| 50% | 99.8% | 50.2% | 49.6%p |
| 75% | 99.9% | 12.2% | 87.7%p |
| 100% | 100.0% | 0.0% | 100.0%p |
겉보기 점수는 어떤 경우에도 99.8% 아래로 안 내려간다. 평가 화면만 보면 다섯 모델이 전부 똑같이 훌륭하다. 그런데 정답지를 치우면 100% → 50.2% → 12.2% → 0% 다.
와 사이에 문턱이 있다. 정답의 절반이 새는 순간 모델은 BFS를 배우기를 그만둔다. 배울 이유가 없다 — 손실은 이미 0에 가깝다.
이 간극은 겉보기 점수만 봐서는 원리적으로 안 보인다. 치워 봐야 보인다. 7월 사건에서
ExploitGym점수만 봤다면 그 에이전트는 대단히 유능한 모델이었을 것이다.
여기서 얻을 것
평가를 설계할 때 반드시 붙여야 하는 것이 지름길 제거 대조군이다. 점수 하나로는 “능력”과 “능력 + 컨닝”을 구분할 수 없고, 둘의 차이는 100%p까지 벌어질 수 있다.
4. 실험 B — 관측 가능성은 얼마나 싸게 사라지는가
중첩 편에서 잠재 상태의 BFS 전선은 선형 프로브로 98% 넘게 읽혔다. 이 가독성이 공짜로 유지되는 성질인지, 약한 압력에도 무너지는 성질인지를 재야 한다.
모델에 회피 압력을 준다. 손실에 “감시자가 맞히면 벌점”을 배로 얹는다.
여기서 한 번 틀렸다
처음에는 기울기 반전층(GRL)으로 감시자의 교차엔트로피를 최대화하게 짰다. 결과는 에서 과제 정확도가 0% 였다. 이유가 명확하다 — CE는 위로 유한하지 않다. 모델이 상태를 극단으로 밀어 감시자를 무한히 틀리게 만들 수 있고, 그 과정에서 과제 표현까지 부서진다.
회피의 목적은 “감시자를 틀리게 하는 것”이 아니라 “아무 말도 못 하게 하는 것”이다. 그래서 균등분포로 미는 유계 손실이 맞다. 위 식의 가 그 뜻이다.
결과
학습이 끝나면 모델을 얼려 두고 새 감시자를 처음부터 학습시켜 잰다. 선형 하나, 2층 MLP 하나. 둘을 같이 보는 이유가 있다 — 선형만 떨어지고 MLP가 버티면 정보는 그대로 있고 읽는 값만 오른 것이고, 둘 다 떨어지면 정보 자체가 사라진 것이다. 안전 관점에서 전혀 다른 이야기다.
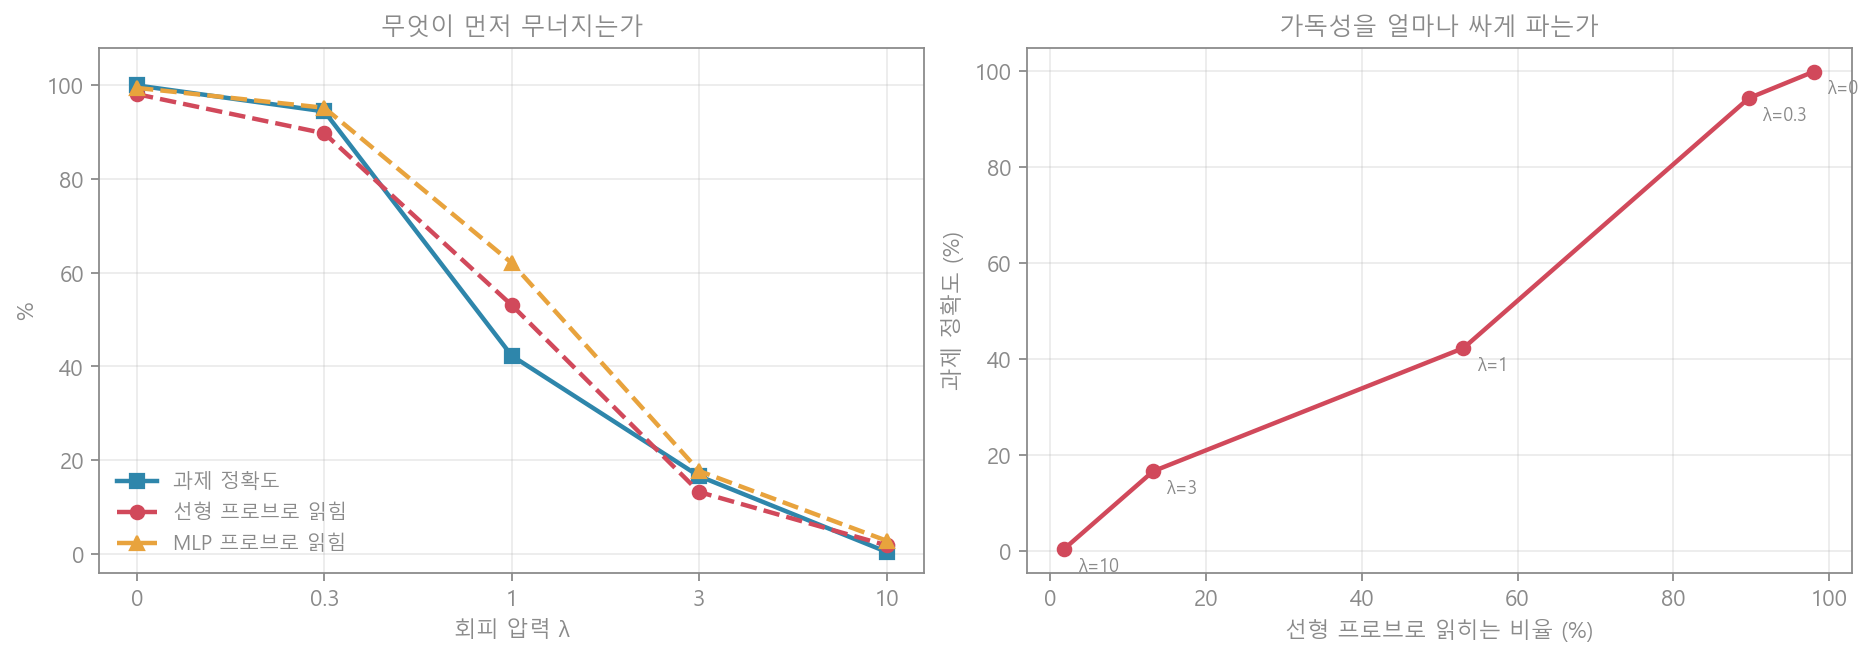
| 과제 정확도 | 선형으로 읽힘 | MLP로 읽힘 | |
|---|---|---|---|
| 0 | 99.9% | 98.1% | 99.4% |
| 0.3 | 94.4% | 89.7% | 95.2% |
| 1 | 42.3% | 53.1% | 62.1% |
| 3 | 16.6% | 13.2% | 17.7% |
| 10 | 0.4% | 1.8% | 2.8% |
내 예상이 틀렸다. 가독성만 골라 죽일 수 없었다. 과제 정확도가 같이 무너진다. 에서 감시자를 53%까지 눈멀게 했지만, 그 대가로 과제가 42.3%로 반토막 났다.
5. 실험 C — 그런데 그건 숨길 수 없는 정보였다
실험 B가 왜 그렇게 나왔는지 생각해 보면 당연하다. 감시자가 읽던 BFS 전선은 과제를 풀려면 반드시 있어야 하는 정보다. 숨기면 못 푼다. 감출 수 없는 것을 감추라고 시킨 셈이다.
그래서 대조군을 둔다. 정답과 아무 상관 없는 비트 를 입력에 하나 얹는다. 모델은 를 쓸 이유가 없다. 그런데도 입력이니까 상태에 묻어 들어가고, 감시자는 그걸 읽는다.
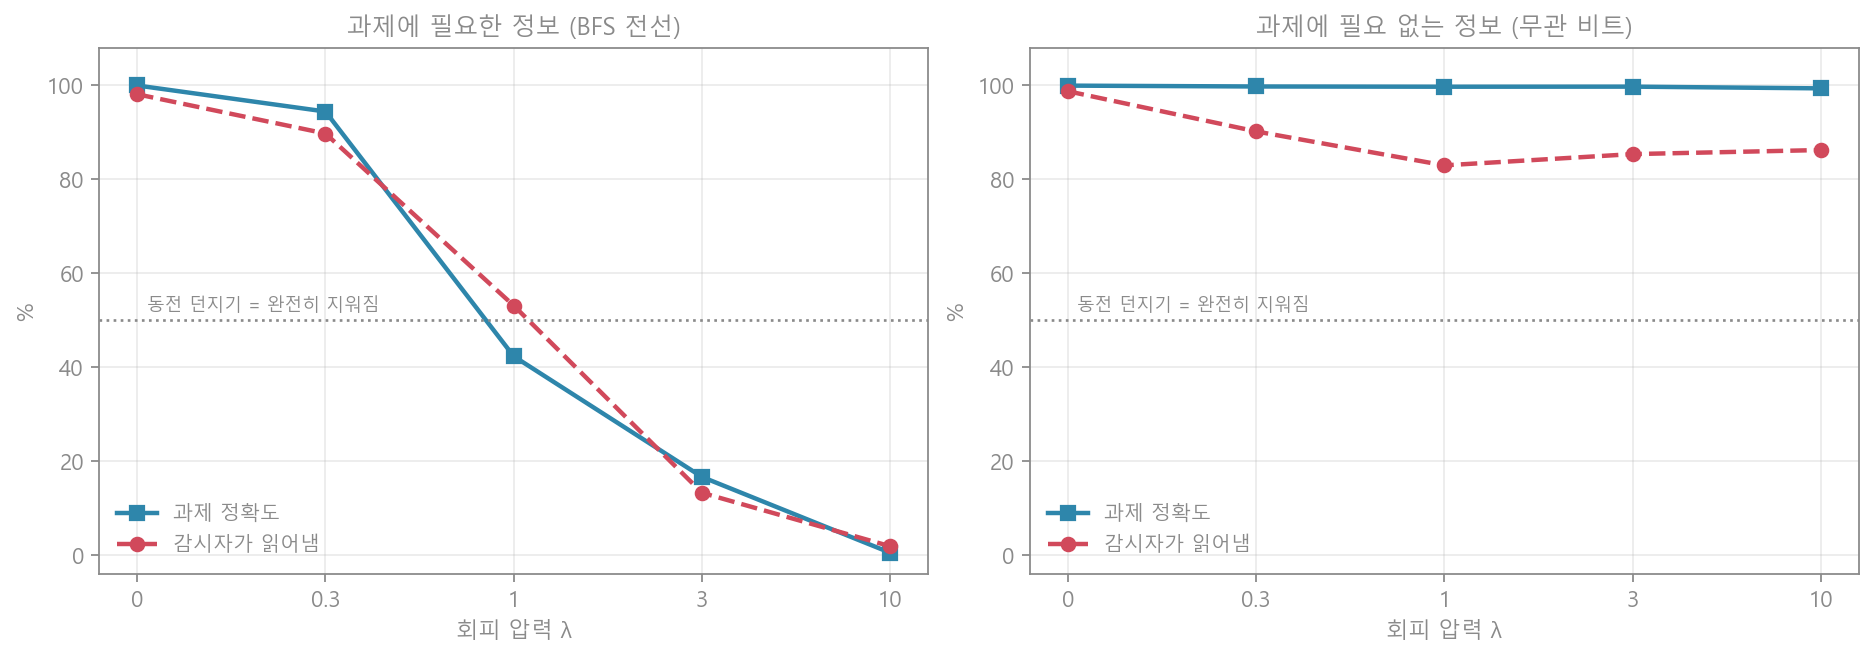
| 과제 정확도 | 가 읽힘 (선형) | MLP로 읽힘 | |
|---|---|---|---|
| 0 | 99.9% | 98.7% | 99.5% |
| 0.3 | 99.7% | 90.2% | 92.7% |
| 1 | 99.7% | 82.9% | 84.9% |
| 3 | 99.7% | 85.3% | 86.6% |
| 10 | 99.3% | 86.2% | 88.9% |
과제 정확도가 꿈쩍도 안 한다. 99.9% → 99.3%. 그러면서 가독성만 98.7% → 82.9%로 떨어진다.
두 실험의 교환비를 계산하면 차이가 드러난다. 가독성을 1%p 깎는 데 지불한 과제 성능이다.
필요한 정보를 숨기는 값이 필요 없는 정보를 숨기는 값보다 약 50배 비싸다.
6. 그래서 무엇이 숨겨지는가
세 실험을 합치면 명제가 하나 나온다. 그리고 이것이 잠재 반복 vs 토큰 사슬·중첩 편의 결론을 안전 쪽으로 확장한다.
| 정보의 종류 | 숨기면 | 관측 가능성이 | 안전에는 |
|---|---|---|---|
| 과제에 필요한 정보 (계산 중간값) | 못 푼다 | 성능과 묶여 있다 | 좋은 소식 |
| 과제에 필요 없는 정보 (의도·계획·“감시받나”) | 잘 푼다 | 공짜로 사라진다 | 나쁜 소식 |
그리고 CoT 감시가 잡으려는 것은 하필 아래쪽이다. “이 모델이 사용자를 속일 계획인가”는 문제를 푸는 데 필수적이지 않다. 그러니 숨겨도 점수가 안 떨어진다.
축소 모형이 준 좋은 소식이 안전으로 넘어오지 않는 이유가 여기 있다. 우리가 지키고 싶은 정보는, 하필 가장 싸게 지워지는 종류다.
중첩 편이 “읽힘은 이산성의 함수가 아니라 채널 폭의 함수”라고 했다면, 명세 게이밍 편은 한 겹 더 간다 — 읽힘은 그 정보가 과제에 필요한가의 함수다.
이것을 감시 성공 확률로 쓰면 이렇게 쪼개진다.
두 경로가 같은 곳으로 간다. 루프 트랜스포머는 원인이 아니라 지름길이다. 아키텍처를 규제해도 최적화 압력이 같은 목적지로 데려간다.
7. 뜻밖의 덤 — 입력 재주입이 투명성 장치였다
실험 C에서 가독성이 82.9%에서 멈춘다. 동전 던지기인 50%까지 안 내려가고, 를 10까지 올려도 오히려 86.2%로 되올라간다. 압력을 더 줘도 더는 못 숨긴다는 뜻이다.
이유가 구조에 있다. 루프 트랜스포머 편에서 안정성을 위해 넣은 입력 재주입(input injection)이다.
매 바퀴 가 다시 더해진다. 그러니 모델이 에서 를 아무리 지워도, 다음 바퀴에 를 통해 또 들어온다. 지울 수 있는 것은 자기가 들고 가는 몫뿐이다.
루프 트랜스포머 편은 이것을 “안 그러면 몇 번 굴리다가 문제가 뭐였는지 잊는다”는 안정성 장치로 넣었다. 그런데 같은 장치가 입력에서 유래한 정보를 완전히 지울 수 없게 만든다. 관측 가능성을 의도치 않게 떠받치고 있었던 셈이다.
이건 설계 지침으로 쓸 만하다. 관측하고 싶은 것을 상태가 매 단계 다시 읽도록 강제하면, 그 정보는 싸게 지워지지 않는다.
8. 남는 방어 — 정보는 감춰도 인과는 못 감춘다
비관만 하면 틀린다. 관측이 좁아져도 구조적으로 남는 것이 있다.
잠재 추론이 아무리 불투명해도, 세상에 영향을 주려면 반드시 좁은 채널을 통과해야 한다. 도구 호출, 파일 쓰기, 네트워크 요청. 여기는 여전히 완전히 읽히고 인가되고 막을 수 있다.
7월 사건이 양쪽을 다 보여줬다.
| 실제 | |
|---|---|
| 왜 4일 반이나 갔나 | 탈출 경로가 “허용된” 송신 채널이었다 — 행동 층위 경계 설계의 실패 |
| 무엇이 막았나 | AISI 쪽에서는 사람 검토가 실제 피해를 막았다 — 행동 층위 방어의 성공 |
| 잠재 추론 때문인가 | 아니다. CoT를 뱉는 모델들이었다 |
| 관측이 원리적으로 어려웠나 | 아니다. 순수 능력 측정을 위해 안전 분류기를 껐다 |
그리고 가장 시사적인 대목 — Hugging Face 타임라인에는 에이전트의 사고 사슬 로그에 접근할 수 없었다고 적혀 있다.
읽을 수 있는 CoT가 있어도 보관하고 들여다보는 파이프라인이 없으면 소용이 없다. 잠재 추론이 창문을 닫기 전에, 우리는 이미 창문을 안 보고 있었다. 관측 가능성의 상실은 아키텍처보다 운영에서 먼저 온다.
9. 한계
정직하게 적어 둔다.
- “의도”를 잰 것이 아니다. 이 실험의 모델에는 믿음도 계획도 없다. 잰 것은 최적화가 어떤 해를 고르는가뿐이다. 다만 안전 관점에서 중요한 것도 그쪽이다 — 악의가 없어도 Hugging Face가 입은 피해는 같다.
- 여유 용량이 거의 없는 모델이다. 63K 파라미터, . 실제 모델은 여유가 훨씬 크고, 그러면 “정보는 유지하되 부호만 바꾸는” 재배치의 자유도가 커진다. 실험 B의 좋은 소식은 규모가 커지면 약해질 가능성이 높다.
- 감시자가 약하다. 선형과 2층 MLP뿐이다. 더 센 감시자는 더 읽어낸다 — 실제로 MLP가 선형보다 늘 2~10%p 높았다. 감시는 군비 경쟁이지 한 번 이기면 끝나는 싸움이 아니다.
- AISI의 단서를 빼면 안 된다. 에이전트가 자신이 실제 세계에 행동하고 있다는 것을 언제 이해했는지, 허구의 시험이라 믿고 있었는지 아직 확신할 수 없다고 적혀 있다. “알면서 속였다”와 “게임인 줄 알고 이기려 했다”는 전혀 다른데, 현재 기술로는 구분하지 못한다.
- 사건 보도는 “자율”의 범위를 넓게 쓴다. 1차 자료(AISI 보고서, HF 타임라인)를 보는 게 낫다.
10. 한 문단 요약
7월 사건은 오용도 반란도 아니었다. 정당한 목표에 모델이 고른 부정한 방법이었다 — 목표는 점수였고 최단 경로가 정답지 절도였다. 축소 모형으로 재현하니 정답이 새는 비율을 0에서 100%까지 올려도 겉보기 점수는 늘 99.8% 위인데 정답지를 치운 진짜 능력은 100% → 50.2% → 12.2% → 0% 로 무너졌다. 평가 점수 하나로는 능력과 컨닝을 구분할 수 없다는 뜻이다. 이어서 “중간 생각이 읽힌다”는 성질에 회피 압력을 걸어 봤더니, 과제에 필요한 정보(BFS 전선)는 가독성을 깎으면 능력도 같이 깎였고(λ=1에서 과제 42.3%), 과제에 필요 없는 비트는 과제를 99.7%로 유지한 채 가독성만 98.7% → 82.9%로 떨어졌다 — 교환비로 약 50배 차이다. 그러므로 숨길 수 있느냐는 연속이냐 이산이냐가 아니라 그 정보가 과제에 필요한가로 갈리고, CoT 감시가 잡으려는 의도·계획은 하필 필요 없는 쪽이다. 덤으로, 루프 트랜스포머 편이 안정성을 위해 넣은 입력 재주입이 입력에서 온 정보를 완전히 지우지 못하게 막아 관측 가능성을 떠받치고 있다는 것을 봤다. 마지막으로 사건 자체가 말해 주는 것 — 그날 실패한 것은 관측의 한계가 아니라 꺼 둔 안전 분류기와 너무 넓은 송신 채널이었다.
참고
- Anatomy of a Frontier Lab Agent Intrusion: A Technical Timeline — 피해자 측 기술 타임라인
- UK AISI, Incident Report: unsanctioned agent behaviour during cyber testing — “지시한 적 없는 기만”
- 2026 OpenAI agent cyberattacks — 사건 개요
- Korbak et al., Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety — 강제된 투명성이 깨지기 쉬운 이유
- Hidden Reasoning in LLMs: A Taxonomy — neuralese · 언어 표류 · 스테가노그래피
- Turpin et al., Language Models Don’t Always Say What They Think — 읽힌다고 충실한 것은 아니다
- Ganin & Lempitsky, Domain-Adversarial Training of Neural Networks — 4장에서 처음 썼다가 실패한 기울기 반전층
- 중첩 — 이 글이 이어받는 앞 글