인지야공/딥러닝 기초 정리/11번째 글
정규화와 잔차 — 깊이를 견디는 법
실행:
python NN_11_normalization_residual.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 트랜스포머 층 해부 편에서 쌓은 층이 왜 깊게 쌓여도 학습되는지를 잰다.
트랜스포머 층 해부 편까지 우리는 트랜스포머의 층을 하나씩 해부했다. 그런데 정작 “왜 수십 층을 쌓아도 학습이 되는가” 는 건너뛰었다. 순진하게 층만 쌓으면 깊은 망은 학습이 안 된다. 그걸 가능하게 하는 두 장치가 잔차 연결과 정규화다. 이 글은 각각이 무엇을 고치는지 직접 잰다.
1. 문제 — 깊이는 곱셈이다
층을 개 쌓으면, 입력 에 대한 출력의 변화(그라디언트)는 각 층의 야코비안을 전부 곱한 것이다.
| 기호 | 뜻 |
|---|---|
| 번째 층 | |
| 그 층의 야코비안 (입력 변화가 출력에 얼마나 전해지나) | |
| 출력이 입력에 얼마나 반응하나 = 학습 신호 |
야코비안의 크기를 대략 라 하면, 곱은 이다.
가 1 에서 조금만 벗어나도 제곱이 되어, 입력에서 먼 층일수록 학습 신호가 지수적으로 사라지거나 터진다. 이것이 그라디언트 소실/폭발이다.
직접 재 보기 A
블록 64개짜리 망(정규화 없음)에서, 학습 시작 시점의 블록별 그라디언트 노름을 쟀다.
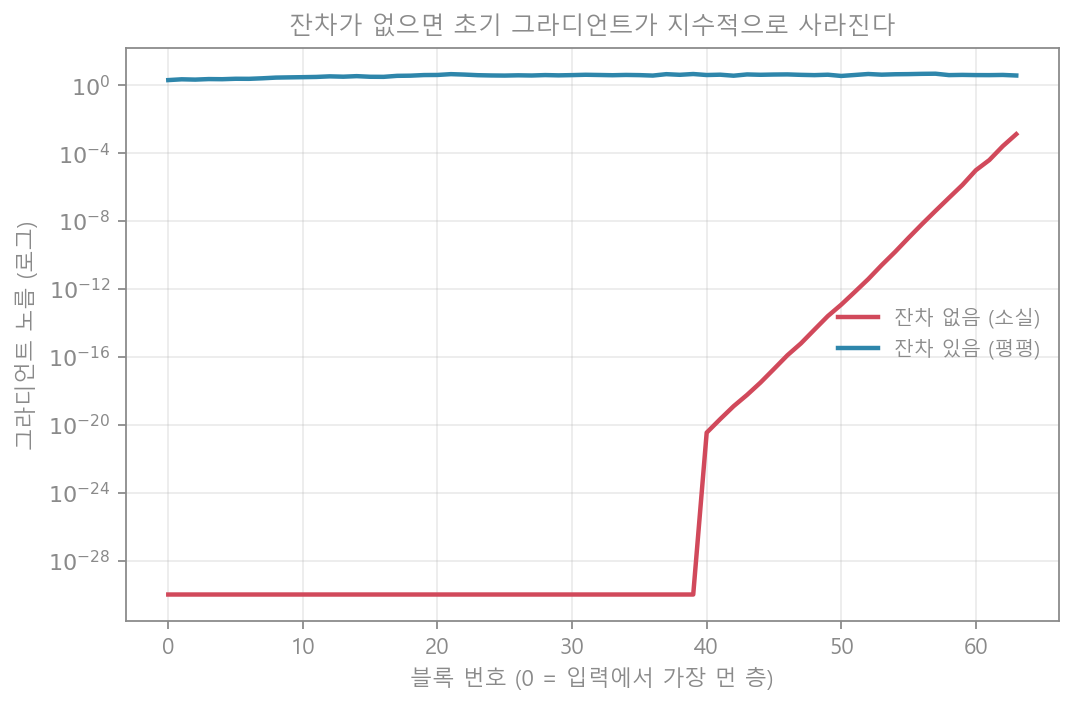
| 첫 블록(입력쪽) | 끝 블록(출력쪽) | 끝/첫 비율 | |
|---|---|---|---|
| 잔차 없음 | 0.00 (언더플로) | 1.28e-3 | 10^27 이상 |
| 잔차 있음 | 1.96 | 3.65 | 1.9배 |
잔차가 없으면 입력쪽 40개 블록의 그라디언트가 아예 0으로 언더플로했다(그림에서 바닥에 깔린 빨간 선). 블록당 약 2.8배씩 줄어(로그10 기울기 +0.443) 64블록이면 신호가 완전히 사라진다. 입력쪽 층은 학습 신호를 못 받는다.
2. 잔차 연결 — 곱셈에 1을 심는다
잔차 연결(residual connection) 은 층의 출력을 입력에 더한다.
| 기호 | 뜻 |
|---|---|
| 블록의 입력 (잔차 스트림) | |
| 블록이 계산한 변화분 | |
| 항등행렬 — 입력을 그대로 통과시키는 지름길 |
핵심은 야코비안에 항등행렬 가 더해진다는 것이다. 이제 개를 쌓아도
곱의 각 항에 1(항등) 이 들어 있어, 각 층이 만드는 변화분이 작을 때 전체 곱이 로 무너지지 않고 O(1) 로 유지된다. 위 실험에서 잔차를 넣자 첫 블록도 그라디언트 1.96 을 받아, 끝/첫 비율이 1.9배로 평평해졌다. 층은 “새 표현을 처음부터 만드는” 대신 잔차 스트림에 조금씩 더한다. 루프 트랜스포머 편의 루프 트랜스포머가 같은 블록을 몇 번이고 다시 통과시켜도 무너지지 않는 것도 이 지름길 덕분이다.
3. 정규화 — 스케일이 표류하지 않게
잔차가 그라디언트를 살렸지만, 문제가 하나 더 있다. 잔차 스트림에 계속 더하다 보면 값의 크기(분산)가 층마다 표류한다. 커지면 폭발하고, 작아지면 뒤 층이 아무것도 못 본다. 정규화(normalization) 는 각 부분층에 들어가는 입력의 스케일을 매번 다시 1 로 맞춘다.
| 기호 | 뜻 |
|---|---|
| 그 벡터의 평균·분산 (특징 차원에 대해) | |
| 학습되는 크기·이동 — 정규화 뒤 필요한 스케일은 되찾게 | |
| 0으로 나누는 것 방지 | |
| 특징 차원 수 |
RMSNorm 은 LayerNorm 에서 평균 빼기()와 이동()을 뺀 것이다. 평균 중심화 없이 크기(RMS)만 맞춘다. 계산이 더 싸고, 요즘 큰 모델(LLaMA 계열 등)이 이걸 쓴다.
직접 재 보기 B
블록 40개에서 각 부분층에 들어가는 입력의 분산을 쟀다.
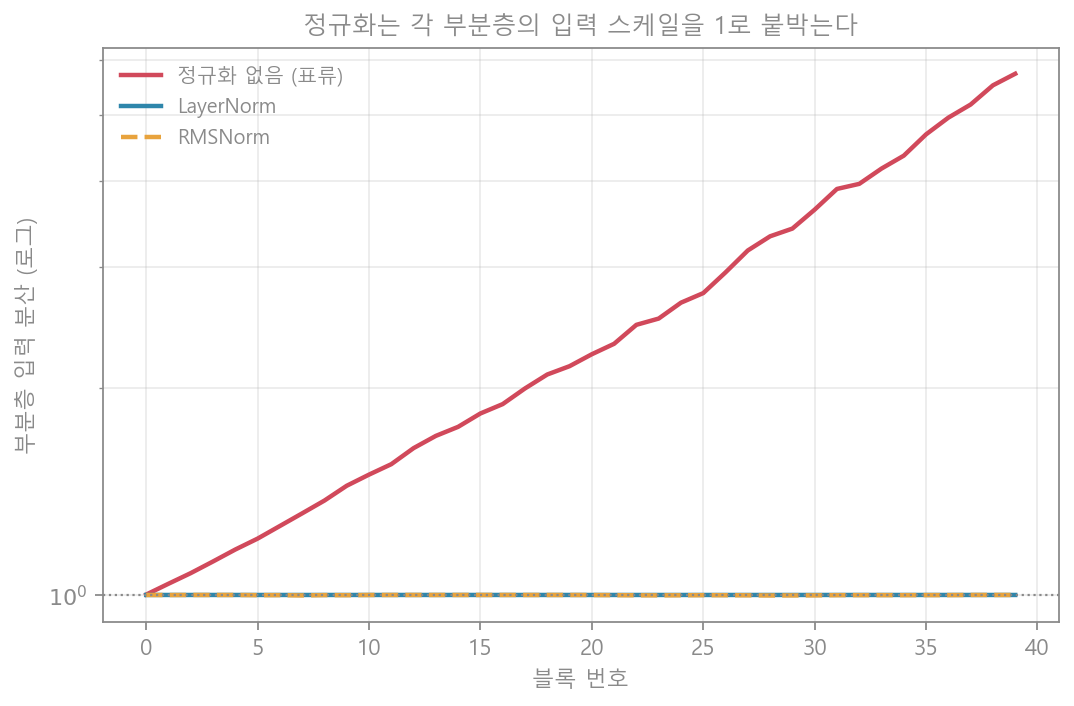
| 정규화 | 첫 블록 분산 | 끝 블록 분산 |
|---|---|---|
| 없음 | 1.00 | 6.05 (표류) |
| LayerNorm | 1.000 | 1.000 |
| RMSNorm | 1.000 | 0.986 |
정규화가 없으면 분산이 40블록에 걸쳐 1 → 6 으로 계속 커졌다. LayerNorm·RMSNorm 은 끝까지 1 근처로 붙박았고, 둘의 차이는 거의 없었다(RMSNorm 0.986). 뒤 층이 항상 같은 스케일의 입력을 받으니 학습이 안정된다.
4. 어디에 넣나 — pre-norm vs post-norm
잔차와 정규화를 어떤 순서로 조합하느냐가 남았다. 두 방식이 있다.
- post-norm (원조 트랜스포머, 2017): 잔차를 더한 뒤 정규화. 정규화가 잔차 스트림 위에 놓여, 지름길 도 매 층 다시 스케일된다 → 깊어지면 그라디언트가 흔들려 워밍업·조심스러운 초기화가 필요하다.
- pre-norm (요즘 표준): 정규화를 부분층 입력에만 걸고, 잔차 스트림은 손대지 않는다. 지름길 가 깨끗이 남아 깊어져도 그라디언트가 안정적이다 → 워밍업 없이도 깊게 학습된다.
직접 재 보기 C
깊이를 2에서 64까지 늘리며, 같은 스텝만큼 학습한 뒤 손실을 쟀다.
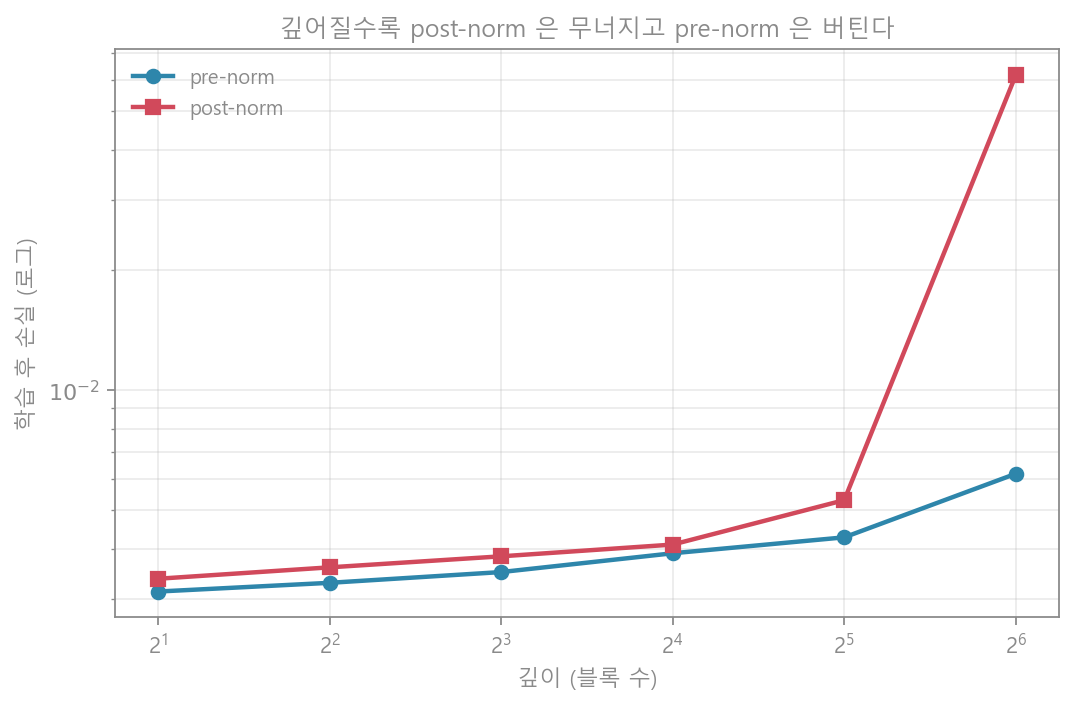
| 깊이 | 2 | 8 | 16 | 32 | 64 |
|---|---|---|---|---|---|
| pre-norm 손실 | 0.0032 | 0.0032 | 0.0036 | 0.0045 | 0.0062 |
| post-norm 손실 | 0.0033 | 0.0037 | 0.0041 | 0.0053 | 0.0706 |
깊이 32까지는 둘이 비슷했지만, 깊이 64에서 post-norm 손실이 pre-norm 의 약 11배로 무너졌다(0.0706 vs 0.0062). 얕을 땐 안 보이던 차이가 깊어지자 벌어진다. 그래서 요즘 큰 모델은 대부분 pre-norm을 쓴다.
한편 같은 pre-norm 에서 LayerNorm(0.0045)과 RMSNorm(0.0043) 은 깊이 32에서 거의 같았다 — RMSNorm 이 더 싸면서 성능은 같으니, 큰 모델이 갈아탄 이유가 여기 있다.
5. 정리
| 장치 | 무엇을 고치나 | 핵심 |
|---|---|---|
| 잔차 연결 | 그라디언트 소실/폭발 | 야코비안에 를 심어, 곱 대신 O(1) 로 |
| 정규화 | 스케일 표류 | 부분층 입력 분산을 매번 1 로 |
| pre-norm | 깊이에서의 불안정 | 잔차 지름길을 정규화가 건드리지 않게 |
| RMSNorm | 계산 비용 | 평균 중심화를 빼도 성능은 같다 |
한 문단으로: 층을 쌓으면 그라디언트는 야코비안의 곱이라 로 소실·폭발한다(재 보니 잔차 없는 64블록에서 입력쪽 그라디언트가 0으로 언더플로, 끝/첫 배). 잔차 연결은 그 곱에 항등 를 심어 O(1)로 살리고 (끝/첫 1.9배), 정규화는 층마다 표류하는 입력 분산(1→6)을 다시 1로 붙박는다. 둘을 pre-norm으로 조합하면 잔차 지름길이 깨끗이 남아 깊이 64에서도 버티지만(post-norm 은 11배로 무너진다), RMSNorm은 더 싸게 같은 일을 한다. 깊게 쌓아도 학습이 되는 것은 이 세 선택 덕분이다.
참고
- Vaswani 외 — Attention Is All You Need (2017) — 원조 post-norm 트랜스포머
- Xiong 외 — On Layer Normalization in the Transformer Architecture (2020) — pre-norm 이 워밍업 없이 학습되는 이유
- Zhang & Sennrich — Root Mean Square Layer Normalization (2019) — RMSNorm
- He 외 — Deep Residual Learning (2015) — 잔차 연결
- 연재: 트랜스포머 층 해부 · 루프 트랜스포머