인지야공/딥러닝 기초 정리/26번째 글
LoRA — 적은 파라미터로 적응하기
실행:
python NN_21_lora.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 필요한 수학: 저계수와 SVD 노트.
거대 모델을 새 과제에 맞추려면 수십억 파라미터를 전부 다시 학습해야 할까? LoRA(Low-Rank Adaptation)는 아니라고 답한다 — 기반 모델은 얼려 두고, 작은 저계수 업데이트만 학습한다. 왜 그것으로 충분한지를 잰다.
1. 핵심 관찰 — 적응은 저계수다
미세조정이 바꾸는 것은 가중치 다. 그런데 새 과제로 옮길 때 필요한 변화량 는 대개 저계수다 — 몇 개의 방향으로만 움직이면 된다(저계수·SVD 노트).
직접 재 보기 A
과제 A로 학습한 모델을 과제 B로 전체 미세조정한 뒤, 바뀐 양 의 특이값을 봤다.
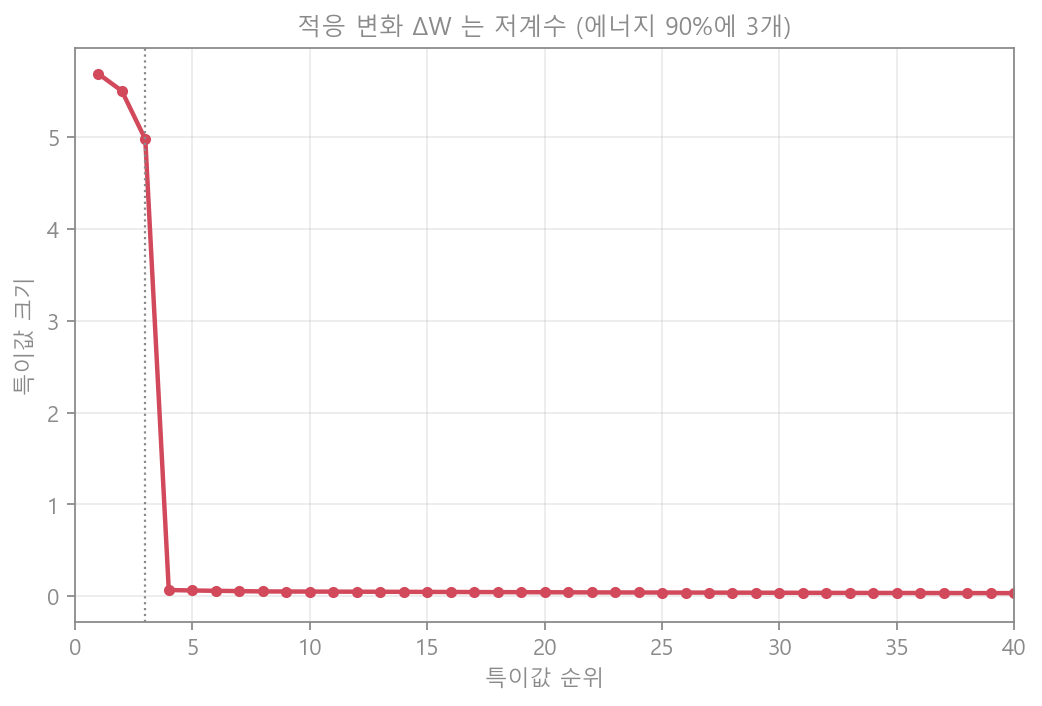
| 특이값 순위 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 크기 | 5.7 | 5.5 | 5.0 | 0.07 | 0.06 |
상위 3개가 지배하고 나머지는 거의 0이다(에너지 90%를 계수 3개가 담는다). 적응에 필요한 변화는 사실상 rank 3 이었다. 그렇다면 그 변화를 처음부터 저계수로 두고 학습하면 된다.
2. LoRA — 저계수 어댑터만 학습
를 통째로 바꾸는 대신, 를 두 작은 행렬의 곱으로 두고 그것만 학습한다.
| 기호 | 크기 | 뜻 |
|---|---|---|
| 얼린 기반 가중치(학습 안 함) | ||
| 저계수 어댑터 | ||
| 저계수 어댑터 | ||
| (작음) | rank — 보통 4~64 |
학습 파라미터는 의 개뿐이다. 기반 개는 얼어 있다.
직접 재 보기 B
기반을 얼리고 rank 어댑터만 학습해 과제 B 손실을 쟀다.
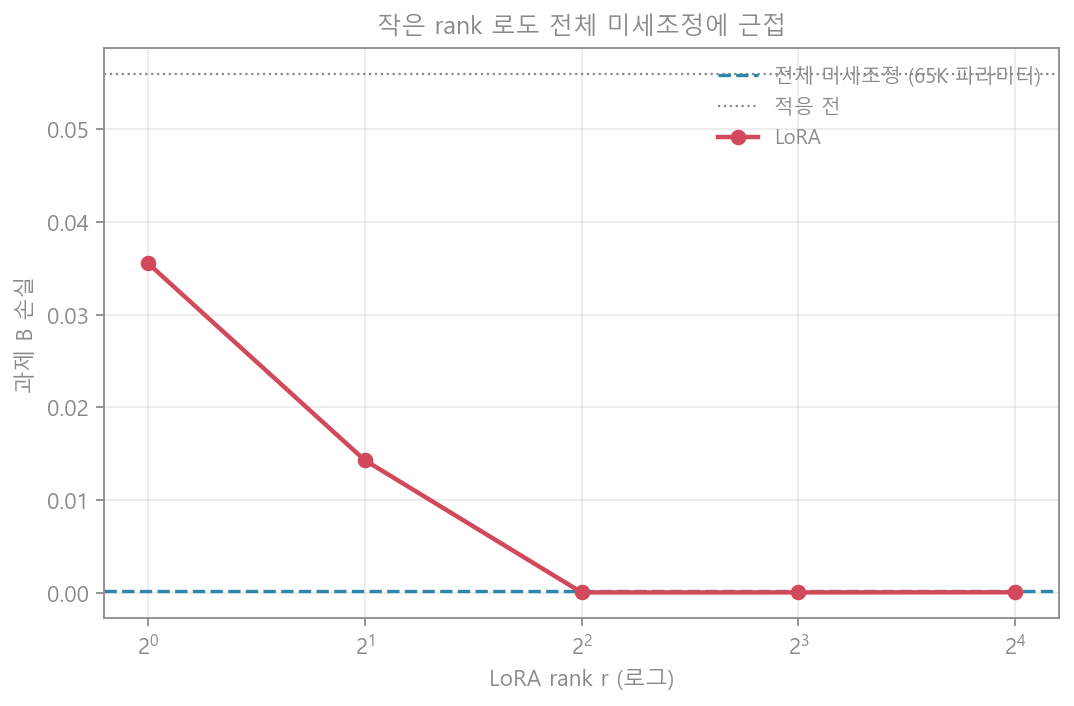
| 손실 | 학습 파라미터 | |
|---|---|---|
| 적응 전 | 0.056 | 0 |
| 전체 미세조정 | 0.0001 | 65,920 |
| LoRA r=1 | 0.0355 | 384 |
| LoRA r=2 | 0.0143 | 768 |
| LoRA r=4 | 0.0001 | 1,536 (전체의 1/42) |
rank 4면 전체 미세조정과 똑같은 손실(0.0001)을 1/42 파라미터로 냈다. 1절에서 적응이 rank 3이었으니, rank 4로 충분한 것이 당연하다. rank 1·2는 부족했다(변화의 계수보다 작아서).
3. 절감 — 얼마나 작아지나
층에서 LoRA 파라미터는 , 전체는 .
| 256×128 층 | LoRA | 전체 | 비율 |
|---|---|---|---|
| rank 1 | 384 | 32,768 | 1/85 |
| rank 4 | 1,536 | 32,768 | 1/21 |
| rank 16 | 6,144 | 32,768 | 1/5 |
실제 큰 모델에서는 학습 파라미터가 0.1~1%로 줄어, 소비자 GPU에서도 미세조정이 된다. 게다가 어댑터만 저장하면 되니 과제마다 수 MB짜리 어댑터 하나씩 — 하나의 기반에 여러 어댑터를 갈아 끼운다.
4. 흔한 오해와 한계
- “LoRA가 항상 전체와 같다” — 아니다. 적응이 저계수일 때만이다. rank가 필요한 계수보다 작으면 부족하다(2절 r=1·2).
- “기반도 조금 바뀐다” — 아니다. 기반은 완전히 얼려 두고 어댑터만 학습한다. 그래서 원래 능력이 안 망가진다.
- 추론 비용은 그대로 — 학습 파라미터만 줄 뿐, 추론 때 를 합치면 크기는 원래와 같다(합쳐 두면 지연도 0).
- 이 글의 실험 — 저계수 변형을 일부러 심은 축소 과제다. “적응=저계수, 그래서 저계수 어댑터로 충분”이라는 구조가 요점이다.
5. 한 문단 요약
미세조정이 바꾸는 양 는 대개 저계수다(재 보니 상위 3개 특이값이 지배). 그래서 를 두 작은 행렬의 곱 로 두고 그것만 학습하는 것이 LoRA다. 기반은 얼리고 어댑터만 배우니, rank 4로 전체 미세조정과 똑같은 손실을 1/42 파라미터로 냈다. 실제로는 학습 파라미터가 0.1~1%로 줄어 소비자 GPU 미세조정과 “하나의 기반 + 여러 어댑터”를 가능하게 한다. 그 뿌리는 저계수·SVD의 산수다.
참고
- Hu 외 — LoRA: Low-Rank Adaptation of Large Language Models (2021)
- Dettmers 외 — QLoRA (2023) — 4비트 양자화 + LoRA
- 연재: 양자화 · 수학: 저계수와 SVD