인지야공/딥러닝 기초 정리/37번째 글
데이터 — 중복, 오염, 그리고 품질
실행:
python NN_33_data.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
스케일링 법칙 편은 “데이터를 늘리면 좋아진다”고 했다. 그런데 늘린다는 게 정확히 뭘까. 같은 문서를 열 번 넣는 것도 늘리는 것인가? 평가 문제가 섞여 들어가면? 라벨이 30% 틀린 데이터를 열 배 넣으면?
모델 구조를 고르는 일보다 데이터를 정리하는 일에 훨씬 많은 공이 들어간다는 것이 업계의 공공연한 사실이다. 왜 그런지를 셋으로 나눠 잰다. 과제는 지식 증류 편과 같은 도형 12종 분류다.
1. 중복 — 같은 것을 여러 번 넣으면
웹에서 긁은 데이터에는 같은 문서가 수없이 반복된다. 그러면 무엇이 달라질까. 학습 집합의 크기를 4,800개로 고정하고, 그 안에서 고유한 데이터의 수만 줄였다(나머지는 복제).
직접 재 보기 A
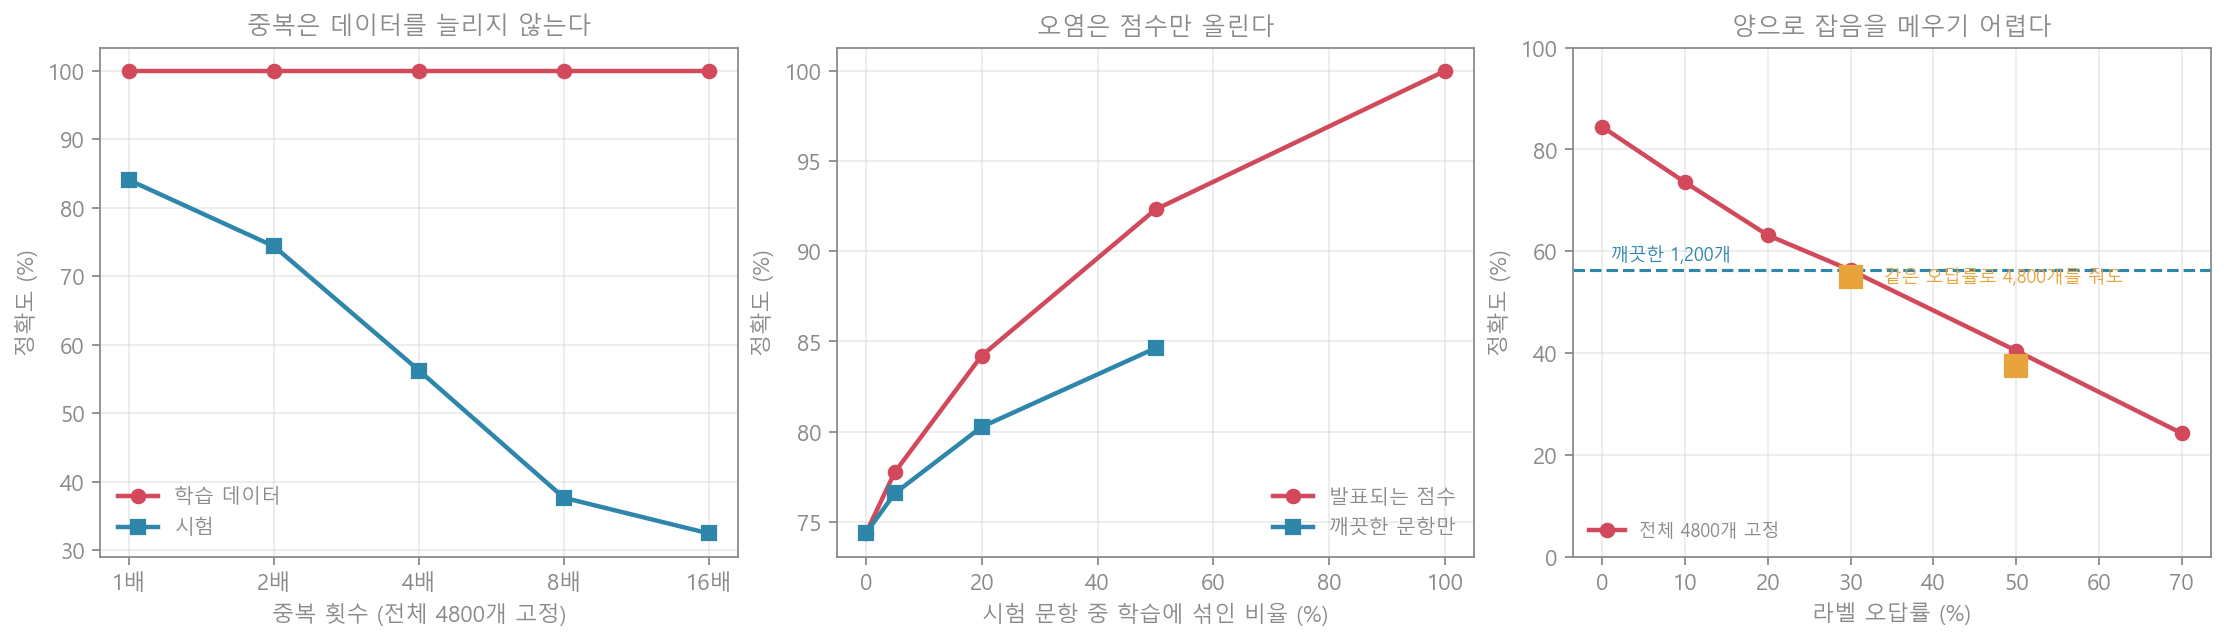
| 중복 횟수 | 1배 | 2배 | 4배 | 8배 | 16배 |
|---|---|---|---|---|---|
| 고유한 데이터 | 4,800 | 2,400 | 1,200 | 600 | 300 |
| 학습 데이터 정확도 | 100.0% | 100.0% | 100.0% | 100.0% | 100.0% |
| 시험 정확도 | 84.0% | 74.4% | 56.2% | 37.6% | 32.4% |
| 격차(암기) | 16.0%p | 25.6%p | 43.8%p | 62.4%p | 67.6%p |
학습 데이터는 언제나 100%다. 겉으로 보이는 학습 손실만 보면 아무 문제가 없다. 그런데 시험은 84.0%에서 32.4%로 반토막 이하다. 중복은 데이터를 늘리지 않는다 — 같은 것을 여러 번 보여줄 뿐이고, 모델은 그것을 더 확실히 외울 뿐이다.
그래서 대규모 사전학습 파이프라인이 중복 제거(dedup)에 그렇게 공을 들인다. 단순히 낭비라서가 아니라, 중복된 데이터가 암기를 부추겨 일반화를 갉아먹기 때문이다. 학습 데이터가 그대로 출력되는 암기(memorization) 문제도 중복된 문서에서 특히 심하게 나타난다.
2. 오염 — 시험 문제가 학습에 섞이면
더 위험한 것은 평가 데이터가 학습에 들어가는 일이다. 웹을 통째로 긁으면 벤치마크 문제와 답이 그 안에 있을 수 있다. 시험 문항의 일부를 학습에 그대로 섞고, 유출된 문항과 깨끗한 문항의 점수를 갈라 봤다.
직접 재 보기 B
| 시험의 유출 비율 | 0% | 5% | 20% | 50% | 100% |
|---|---|---|---|---|---|
| 발표되는 점수(시험 전체) | 74.4% | 77.8% | 84.2% | 92.3% | 100.0% |
| 깨끗한 문항만 | 74.4% | 76.6% | 80.3% | 84.6% | — |
| 유출 문항만 | — | 100.0% | 100.0% | 100.0% | 100.0% |
| 부풀림 | 0.0%p | 1.2%p | 3.9%p | 7.7%p | — |
유출된 문항은 예외 없이 100%다. 외웠으니 당연하다. 그래서 절반만 새어 들어가도 발표 점수가 92.3%가 되고, 전부 새면 100%가 된다 — 실력과 무관하게.
눈여겨볼 것은 깨끗한 문항의 점수도 올라간다는 점이다(74.4% → 84.6%). 유출된 문항도 결국 유효한 학습 데이터이기 때문이다. 그러니 “오염되면 점수만 오르고 실력은 그대로”라는 말은 정확하지 않다. 정확한 진술은 이것이다 — 점수가 실력보다 훨씬 더 많이 오른다. 여기서는 실력이 10.2%p 오르는 동안 점수는 17.9%p 올랐다. 그 차이 7.7%p가 순수한 거품이다.
이것이 “새 모델이 벤치마크를 갈아치웠다”는 발표를 곧이곧대로 믿기 어려운 이유다. 그래서 평가는 모델 출시 이후에 만들어진 문제나 비공개 문제로 해야 신뢰할 수 있고, 오염 검사(n-gram 중복 탐색)가 논문의 필수 절차가 됐다.
3. 품질 vs 양 — 잡음은 양으로 메워지지 않는다
마지막은 라벨 품질이다. 전체 크기를 4,800개로 고정하고 라벨 오답률만 바꿨다.
직접 재 보기 C
| 라벨 오답률 | 0% | 10% | 20% | 30% | 50% | 70% |
|---|---|---|---|---|---|---|
| 시험 정확도 | 84.4% | 73.5% | 63.1% | 56.3% | 40.5% | 24.2% |
오답률 10%p마다 대략 10%p씩 깎인다. 그럼 양으로 메울 수 있을까. 같은 오답률의 데이터를 4배 줘 봤다.
| 시험 정확도 | |
|---|---|
| 깨끗한 1,200개 | 56.2% |
| 오답률 30%인 4,800개(4배) | 54.9% |
| 오답률 50%인 4,800개(4배) | 37.4% |
4배를 줘도 못 이긴다. 오답률 30%짜리 4,800개(54.9%)가 깨끗한 1,200개(56.2%)보다 못하다. 잡음은 표본을 늘리면 평균으로 씻겨 나갈 것 같지만, 틀린 라벨은 틀린 방향으로 기울기를 만들기 때문에 일정 비율을 넘으면 데이터를 더 넣는 것이 답이 아니다.
여기서 “데이터가 모델을 만든다”는 말의 실질적인 뜻이 나온다. 같은 예산이라면 더 모으는 것보다 거르는 것이 나을 때가 많다. 작은 고품질 데이터로 큰 데이터를 이기는 결과들(교과서 품질 데이터, 필터링된 웹 코퍼스)이 계속 보고되는 배경이다.
4. 흔한 오해와 한계
- “데이터는 많을수록 좋다” — 중복(1절)과 잡음(3절)은 양이 아니다. 고유하고 맞는 데이터가 양이다.
- “학습 손실이 낮으면 잘 배운 것” — 1절에서 학습 정확도는 언제나 100%였다. 중복은 학습 지표에 안 잡힌다.
- “오염되면 점수만 오른다” — 정확히는 점수가 실력보다 더 많이 오른다(2절, 17.9%p vs 10.2%p).
- “조금 섞인 건 괜찮다” — 5%만 새도 3.9%p 부풀려졌다(여기선 1.2%p 거품). 벤치마크 순위는 보통 1~2%p 차이로 갈린다.
- 이 글의 실험 — 도형 분류라는 장난감이고, 잡음도 “라벨을 무작위로 바꾸기”라는 단순한 형태다. 84.0%·32.4% 같은 수는 이 설정의 값이고, 요점은 중복은 암기를 키우고, 오염은 점수를 부풀리고, 잡음은 양으로 안 메워진다는 구조다.
5. 한 문단 요약
데이터를 “늘린다”는 말은 생각보다 까다롭다. 전체 4,800개를 유지한 채 고유한 데이터만 16분의 1로 줄이자 학습 정확도는 100% 그대로인데 시험은 84.0%에서 32.4%로 떨어졌다 — 중복은 데이터가 아니라 암기다. 시험 문항의 절반이 학습에 새어 들어가면 발표 점수는 92.3%가 되는데 깨끗한 문항의 실력은 84.6%였다. 점수가 실력보다 7.7%p 더 오른 것이고, 벤치마크 발표를 곧이곧대로 믿기 어려운 이유다. 라벨 오답률은 10%p마다 약 10%p를 깎았고, 오답률 30%인 데이터는 4배를 줘도 깨끗한 데이터를 못 이겼다. 모델을 고르는 일보다 데이터를 거르는 일에 공이 더 들어가는 이유가 이 셋에 다 있다.