인지야공/딥러닝 기초 정리/41번째 글
캘리브레이션 — 모델은 자기가 틀린 것을 아는가
실행:
python NN_39_calibration.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 필요한 수학: 엔트로피와 KL 발산 노트.
평가 편은 점수를 얼마나 믿을 수 있나를 물었다. 이번엔 한 칸 더 들어간다 — 모델이 스스로 말하는 확신을 믿을 수 있나. “90% 확신”이라고 할 때 실제로 10번 중 9번 맞아야 쓸모가 있다. 사람에게 넘길지 자동으로 처리할지, 다시 물어볼지 말지가 전부 그 숫자에 달려 있기 때문이다.
1. 무엇을 재는가 — 그림으로 먼저
모델이 말한 확신을 가로축에, 그 확신으로 답한 것들의 실제 정확도를 세로축에 놓는다. 잘 맞으면 대각선에 놓인다. 아래로 처지면 과신(말한 것보다 못 맞힘)이다.
이 처짐을 숫자 하나로 요약한 것이 ECE(기대 보정 오차)다. 확신 구간별로 “말한 확신”과 “실제 정확도”의 차이를 재서, 그 구간에 들어간 표본 수로 가중 평균한다.
| 기호 | 뜻 |
|---|---|
| 확신 구간(여기서는 12칸) | |
| 그 구간에 들어간 표본 수 | |
| 전체 표본 수 |
2. 직접 재 보기 A — 정확도는 멈췄는데 확신만 오른다
도형 12종 분류를 학습시키며 정확도와 평균 확신을 나란히 쟀다.
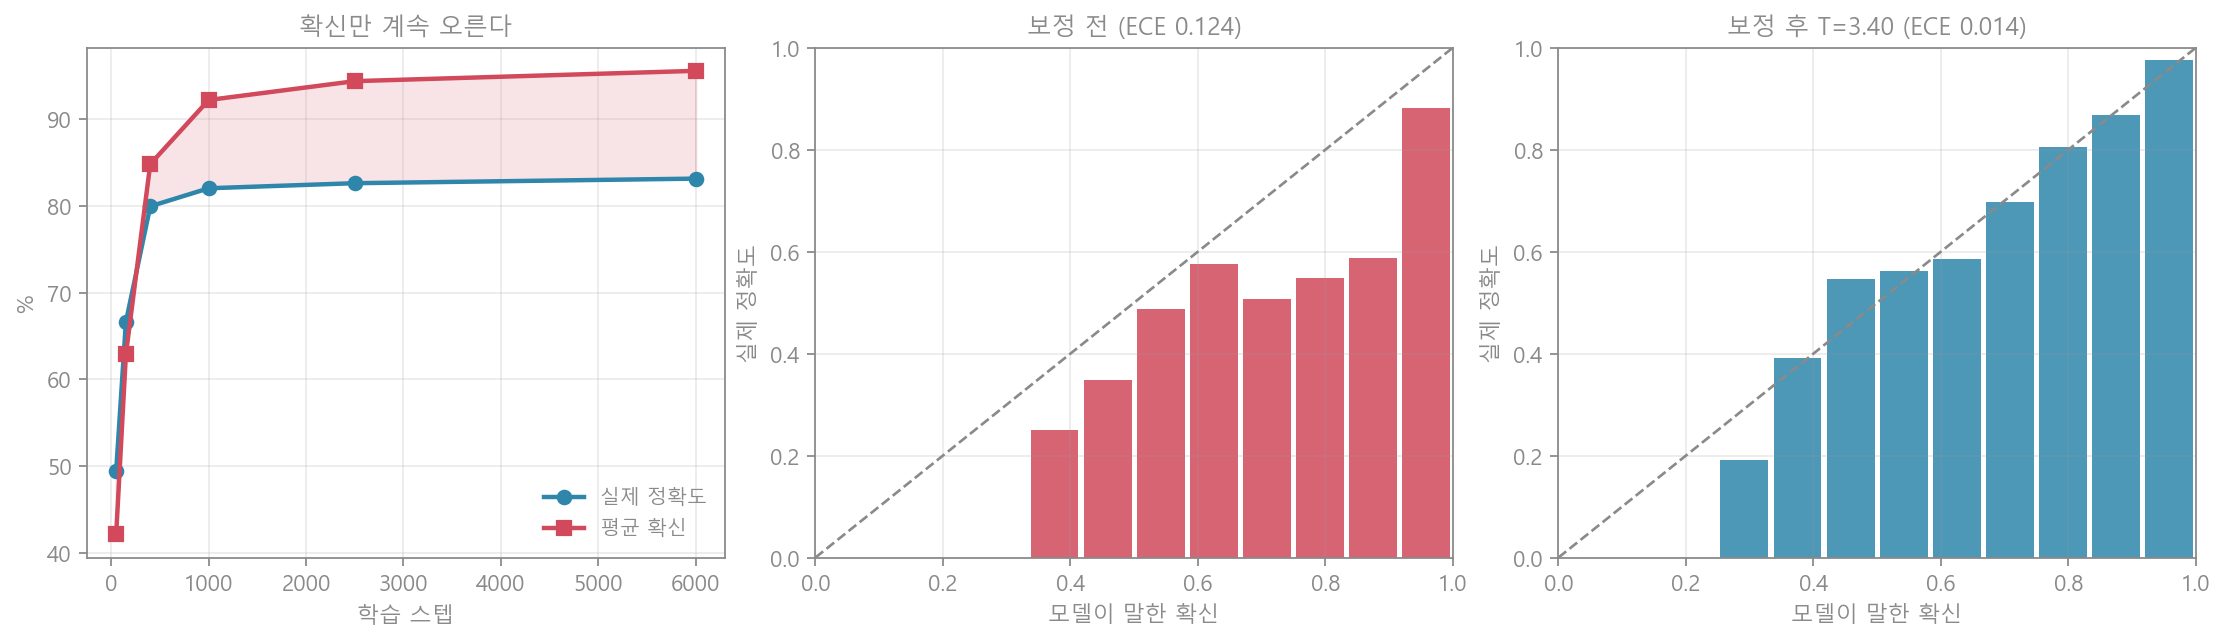
| 학습 스텝 | 150 | 400 | 1,000 | 2,500 | 6,000 |
|---|---|---|---|---|---|
| 학습 데이터 정확도 | 77.6% | 97.5% | 100.0% | 100.0% | 100.0% |
| 시험 정확도 | 66.6% | 79.9% | 82.0% | 82.6% | 83.1% |
| 평균 확신 | 62.9% | 84.8% | 92.2% | 94.4% | 95.6% |
| 과신 폭 | −3.7%p | +4.9%p | +10.2%p | +11.8%p | +12.4%p |
| ECE | 0.0412 | 0.0524 | 0.1020 | 0.1177 | 0.1243 |
1,000스텝 이후 시험 정확도는 82%에서 거의 멈췄는데, 확신은 92.2%에서 95.6%까지 계속 올랐다. 초반(150스텝)에는 오히려 겸손했는데(−3.7%p) 학습이 길어질수록 뒤집힌다.
이유는 손실 함수에 있다. 교차엔트로피는 맞힌 것도 더 확신하면 손실이 준다 (엔트로피 노트). 학습 데이터를 다 맞힌 뒤에도 줄일 것이 남아 있으니, 모델은 확신을 키우는 쪽으로 계속 간다. 학습 데이터에서는 그게 옳지만 시험에서는 아니다.
신뢰도 그림이 대각선에서 떨어져 나가는 과정을 그대로 보면 분명하다.
3. 직접 재 보기 B — 숫자 하나로 고친다
고치는 법은 놀랄 만큼 싸다. 로짓을 온도 로 나누는 것뿐이다 (디코딩과 샘플링 편의 그 온도다).
는 시험에 쓰지 않은 데이터 한 줌으로 맞춘다. 파라미터가 딱 하나다.
| 평균 확신 | 정확도 | ECE | |
|---|---|---|---|
| 보정 전 | 95.6% | 83.2% | 0.1235 |
| 보정 후 () | 83.1% | 83.2% | 0.0144 |
보정 오차가 88% 줄었고, 정확도는 한 자리도 안 바뀌었다. 온도로 나누는 것은 모든 로짓을 같은 비율로 줄이는 일이라 순위가 바뀌지 않기 때문이다. 즉 무엇을 고르는가는 그대로 두고, 얼마나 확신하는가만 고친다.
찾아진 온도가 3.395라는 것도 읽을 거리다 — 모델이 내놓은 로짓이 3.4배 과하게 뾰족했다는 뜻이다.
4. 직접 재 보기 C — 본 적 없는 것 앞에서
더 불편한 문제가 남는다. 학습에서 본 적 없는 입력에는 어떻게 답할까.
| 입력 | 평균 확신 | 90% 넘게 확신한 비율 |
|---|---|---|
| 학습에서 본 도형 | 95.6% | 86.8% |
| 잡음이 두 배 낀 도형 | 95.3% | 85.5% |
| 완전한 무작위 잡음 | 97.2% | 91.3% |
| 아무것도 없는 빈 화면 | 49.6% | 0.0% |
12종 중 하나를 고르는 문제이니, 모르겠으면 8.3%가 맞다. 그런데 완전한 무작위 잡음에 97.2%로 확신한다. 오히려 진짜 도형(95.6%)보다 더 확신했다.
이유는 구조적이다. 소프트맥스는 주어진 후보들 중 무엇이 제일 그럴듯한가만 답한다. “이 중에 답이 없다”는 선택지가 애초에 없다. 잡음 이미지에서도 우연히 어느 한 클래스의 특징이 조금 더 강하면, 그 차이가 지수함수를 지나며 97%로 부풀려진다.
빈 화면에서만 49.6%로 떨어진 것은 입력이 전부 0이라 로짓이 편향값만 남았기 때문이고, 모델이 모른다는 것을 알아서가 아니다.
5. 흔한 오해와 한계
- “확률이 90%면 90%다” — 아니다(2절). 과신 폭이 12.4%p였다. 확신 값을 기준으로 자동 처리 여부를 정하는 시스템이라면 그대로 사고가 된다.
- “정확도가 높으면 보정도 잘돼 있다” — 별개다. 2절에서 정확도는 멈춘 채 ECE만 3배가 됐다.
- “보정하면 성능이 떨어진다” — 온도 보정은 순위를 안 바꿔 정확도가 그대로다(3절).
- “낮은 확신 = 모른다” — 4절이 반례다. 모르는 입력에서 오히려 더 확신했다. 분포 밖 탐지는 별도의 장치(거부 옵션, 앙상블, 밀도 추정)가 필요하다.
- 이 글의 실험 — 도형 12종이라는 장난감이고 작은 MLP다. 12.4%p·97.2% 같은 수는 이 설정의 값이지만, 과신이 학습과 함께 커지는 것과 소프트맥스가 “모르겠다”를 못 만드는 것은 구조에서 오는 성질이다.
6. 한 문단 요약
모델이 말하는 확신은 확률이 아니다. 시험 정확도가 82%에서 멈춘 뒤에도 평균 확신은 92.2%에서 95.6%까지 올라 과신 폭이 12.4%p가 됐다 — 교차엔트로피가 “맞힌 것을 더 확신하라”고 계속 밀기 때문이다. 고치는 것은 싸다. 시험에 안 쓴 데이터로 온도 하나(3.395)만 맞추자 보정 오차가 88% 줄고 정확도는 83.2%로 그대로였다(순위를 안 바꾸므로). 다만 더 근본적인 문제가 남는다 — 완전한 무작위 잡음에 97.2%로 확신했다. 소프트맥스에는 “이 중에 답이 없다”는 선택지가 없기 때문이고, 그건 온도로 고칠 수 있는 종류의 문제가 아니다.